

Verfasst vonMo Kahnam


Sie haben „cinematisches Porträt eines furchtlosen Entdeckers“ eingegeben, auf Generieren geklickt und ein verschwommenes Gesicht, schmutzige Beleuchtung und einen Hintergrund erhalten, der so gar nichts mit der Szene in Ihrem Kopf zu tun hat. Diese Erfahrung ist weit verbreitet. EinKI-Bildgenerator aus Textliest einen Prompt nicht wie ein menschlicher Art Director. Er interpretiert ein Bündel von Sprachsignalen, prognostiziert visuelle Beziehungen und verwandelt diese Vorhersagen in Pixel.
Der Unterschied zwischen einem durchschnittlichen Ergebnis und einem Bild, das die Leute teilen möchten, ist meist kein geheimes Schlüsselwort. Es ist der Prozess des Schöpfers: das Definieren des Motivs, das Kontrollieren der Komposition, das Auswählen einer visuellen Sprache und das iterative Durchführen jeweils einer sinnvollen Änderung. Die Tools sind zugänglich, aber starke Ergebnisse hängen dennoch von bewussten Entscheidungen ab.
Ein leeres Eingabefeld fördert vages Denken. Sie tippen „schönes Fantasieschloss bei Sonnenuntergang“, und das Modell muss entscheiden, was für ein Schlosstyp, wo die Kamera positioniert ist, wie groß der Mond erscheinen soll, ob die Szene wie ein Gemälde oder eine Fotografie aussieht und welche Details hervorgehoben werden sollen. Sie haben ihm keinen visuellen Plan vorgegeben, also füllt es die Lücken anhand von Mustern, die es während des Trainings gelernt hat.
Die meisten modernen Text-zu-Bild-Systeme verwenden einen Diffusionsprozess. Einfach ausgedrückt beginnt das Modell mit visuellem Rauschen und formt dieses Rauschen schrittweise in ein Bild um, das der Textdarstellung Ihres Prompts entspricht. Es ruft nicht ein einzelnes gespeichertes Bild ab und fügt es auf die Leinwand. Es generiert eine neue Anordnung von Formen, Farben, Texturen und räumlichen Beziehungen basierend auf den Anweisungen, die es interpretieren kann.
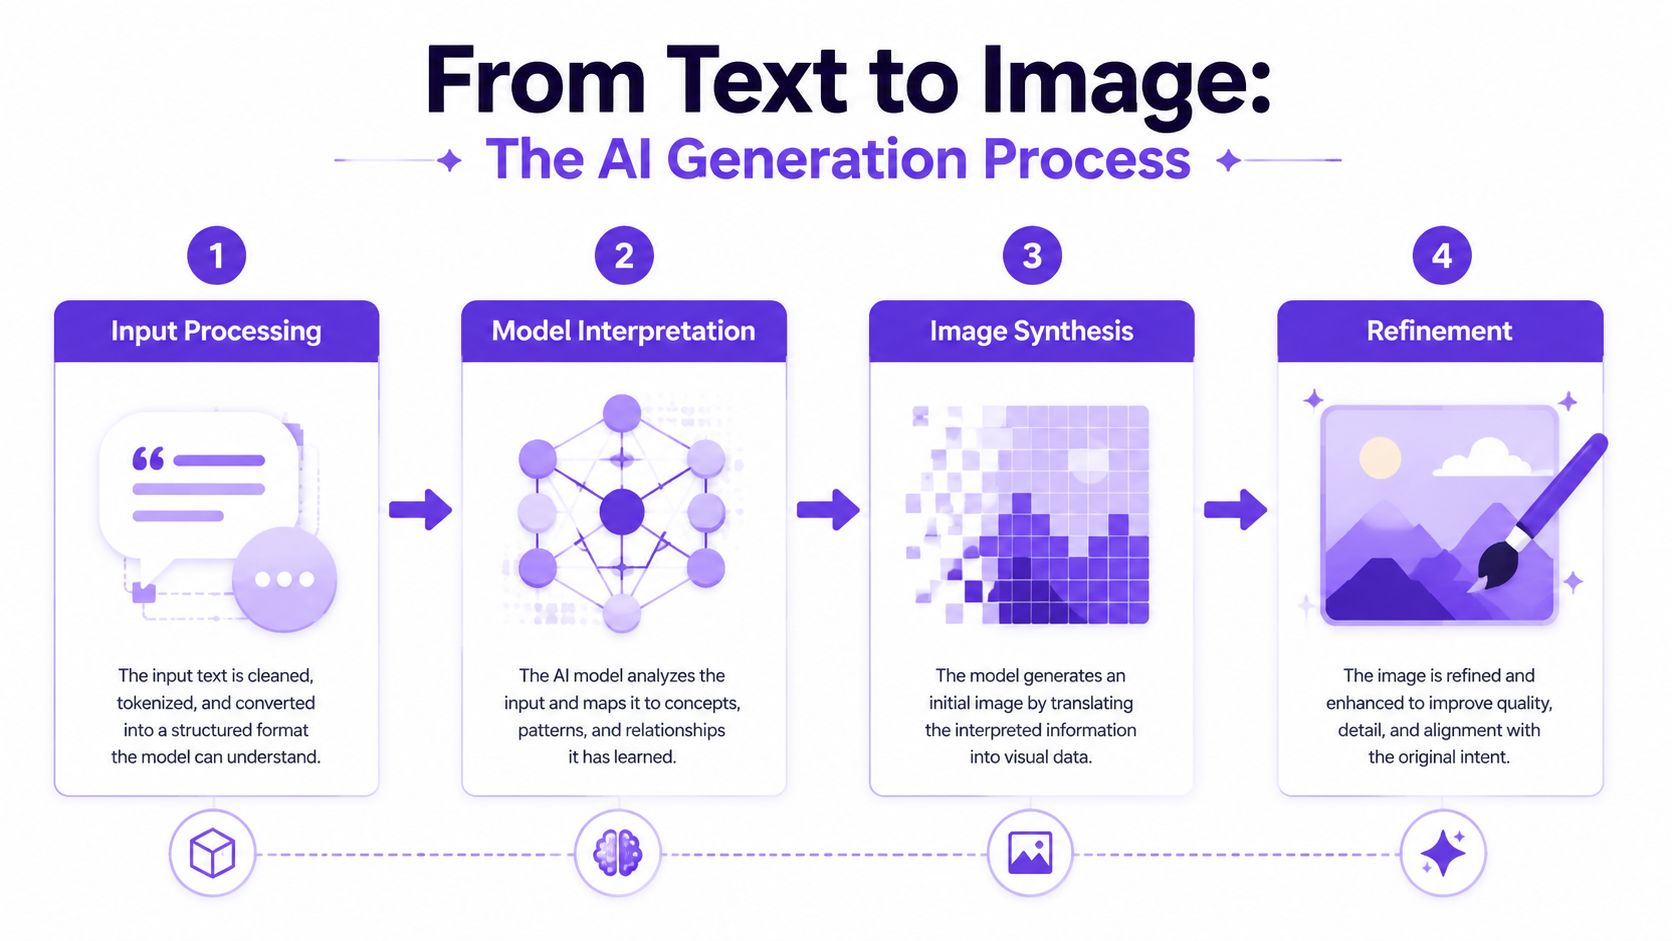
Die Arbeit des Modells lässt sich in vier miteinander verbundene Phasen unterteilen:
Ein Prompt wie „rotes Fahrrad am See“ gibt dem System ein Motiv und einen Ort, aber nicht viel Hierarchie. „Ein verwittertes, rotes Tourenfahrrad, das an einem Holzsteg an einem nebligen Alpensee lehnt, Gegenlicht am frühen Morgen, Dokumentarfotografie, gedämpfte Grün- und Rostpalette, weite Komposition“ liefert Beziehungen, die das Modell verwenden kann. Der zweite Prompt garantiert keinen Erfolg, aber er reduziert die Anzahl der wichtigen Entscheidungen, die dem Zufall überlassen werden.
Für einen umfassenderen Blick auf die Mechanik bietetdiese Erklärung zur Funktionsweise von KI-Kunstnützlichen Kontext. Wenn Sie Zugriffsmodelle bei der Auswahl eines Arbeitsbereichs vergleichen, ist12 KI-Bildgeneratoren mit kostenlosen Tarifeneine praktische Referenz, da sich Verfügbarkeit, Bearbeitungswerkzeuge und Nutzungsbedingungen auf den verschiedenen Plattformen unterscheiden.
Die Technologie hat sich rasant von der Spezialforschung zu alltäglicher Kreativsoftware entwickelt. OpenAI stellte DALL·E im Januar 2021 vor, gefolgt von DALL·E 2 im April 2022 und DALL·E 3 im September 2023 – Meilensteine, die in derGeschichte der Text-zu-Bild-Modelle dokumentiert sindDie öffentliche Veröffentlichung von Stable Diffusion am 22. August 2022 machte ein Open-Weight-Diffusionsmodell für die lokale Nutzung und für Experimente verfügbar. Stable Diffusion XL 1.0, veröffentlicht im Juli 2023, verwendete3,5 Milliarden Parameter, was ungefährdem 3,5-Fachen früherer Versionenentspricht, wie in diesergenerativen KI-Zeitleiste.
beschrieben wird. Diese Geschichte ist aus einem praktischen Grund von Bedeutung. Sie steuern keinen digitalen Maler, der die Absicht versteht. Sie steuern ein probabilistisches System. Jede Prompt-Auswahl engt entweder die visuelle Suche ein oder lässt dem Modell mehr Freiraum zum Improvisieren.
Ein Prompt funktioniert besser, wenn er wie ein kompakter Kreativbrief statt wie ein Haufen Adjektive formuliert ist. Beginnen Sie mit dem Element, das unbedingt erscheinen muss, und definieren Sie dann dessen Kontext, die visuelle Darstellung, die Beleuchtung und die emotionale Stimmung.
Verwenden Sie diese Reihenfolge als zuverlässigen Ausgangspunkt:
Ein schwacher Prompt könnte lauten:
„Ein cooler Krieger in einem Wald.“
Eine nützlichere Version ist:
„Eine kampferprobte weibliche Waldläuferin, die auf einem moosbedeckten Steinpfad in einem alten Zedernwald steht, Dreiviertelporträt, Lederüstung mit dezenten Bronzedetails, Strahlen aus blassem Morgenlicht durch Nebel, geerdetes Fantasy-Konzeptkunstwerk, dezente Grün- und Bernsteinfarbpalette, entschlossene Stimmung.“
Der überarbeitete Prompt sagt dem Generator, was Aufmerksamkeit verdient und wie der Betrachter darauf treffen soll.„Dreiviertelporträt“beeinflusst die Rahmung.„Blasses Morgenlicht durch Nebel“erzeugt eine klarere Atmosphäre als „schöne Beleuchtung“.„Dezente Grün- und Bernsteinfarbpalette“begrenzt eine unkontrollierte Farbverschiebung.
Fügen Sie nicht jedes ansprechende Stilwort hinzu, das Sie kennen. „Cinematisch, realistisch, malerisch, Anime, redaktionell, surreal, minimalistisch“ gibt dem Modell widersprüchliche visuelle Ziele vor. Wählen Sie einen dominanten Stil und eine unterstützende Referenz. Beispielsweise ist „redaktionelle Modefotografie mit kinoreifem Gegenlicht“ stimmiger als eine Liste zusammenhangloser Ästhetiken.
Negative Prompts können helfen, wiederkehrende Mängel zu beseitigen, obwohl ihr genaues Verhalten je nach Modell variiert. Verwenden Sie sie für konkrete Ausschlüsse wie „zusätzliche Finger, verzerrte Hände, doppeltes Subjekt, verzerrter Text, Wasserzeichen, unruhiger Hintergrund“. Sie sind weniger nützlich, wenn sie zu einem langen Katalog jedes möglichen Fehlers werden.
Seien Sie bei Text innerhalb eines Bildes vorsichtig. Viele Generatoren haben nach wie vor Schwierigkeiten mit präzisen Schriftzügen, erstellen Sie das Kunstwerk daher mit absichtlich freiem Raum und fügen Sie die Überschrift später in einem Design-Tool hinzu, wenn es auf Genauigkeit ankommt. Auch die Prompt-Iteration sollte kontrolliert werden. Ändern Sie zuerst die Beleuchtung, vergleichen Sie die Ergebnisse und ändern Sie dann die Komposition. Wenn Sie den gesamten Prompt nach jedem Versuch umschreiben, wissen Sie nicht, welche Entscheidung die Verbesserung verursacht hat.
Praktische Regel:Ändern Sie jeweils nur eine große Variable, behalten Sie die Version bei, die funktioniert, und machen Sie sich eine kurze Notiz darüber, was jede Überarbeitung verändert hat.
DerLeitfaden für Anfänger zum Prompt Engineeringist nützlich, wenn Sie strukturierteres Üben wünschen. Die wesentliche Gewohnheit ist einfach: Beschreiben Sie das visuelle Verhältnis, das Sie benötigen, nicht nur die Stimmung, die Sie sich wünschen.
Ein Banner, ein Buchumschlag-Konzept und ein quadratischer Social-Media-Beitrag können dasselbe Subjekt verwenden, aber völlig unterschiedliche Kompositionen erfordern. Legen Sie zuerst das Ziel fest. Entscheiden Sie, welches Element einheitlich bleiben muss, wo Text platziert werden kann und welches visuelle Detail die meiste Aufmerksamkeit verdient.
Öffnen Siestarryaiund erstellen Sie einen Basis-Prompt rund um Subjekt, Schauplatz, Komposition, Stil, Beleuchtung und Stimmung. Wählen Sie eine Leinwandgröße und einen Stil, die zur beabsichtigten Platzierung passen. Der Text-zu-Bild-Workflow konvertiert diese Beschreibung in ein Kunstwerk und ermöglicht es Ihnen, mehrere Versionen zu generieren, wodurch ein direkter Vergleich nützlicher wird, als ein einziges glückliches Ergebnis zu beurteilen.
Beginnen Sie mit einem klaren Prompt. Lassen Sie Referenzbilder, ausgearbeitete Charaktergeschichten und konkurrierende Stile für spätere Durchläufe weg. Ein einfaches erstes Ergebnis zeigt, wie der Generator das Subjekt interpretiert, und gibt Ihnen einen zuverlässigen Vergleichspunkt.
Generieren Sie mehrere Variationen und bewerten Sie die Struktur, bevor Sie feine Details beurteilen. Achten Sie auf ein jelas Subjekt, eine überzeugende Platzierung und nutzbaren negativen Raum. Speichern Sie die stärkste Komposition, anstatt automatisch das am poliertesten aussehende Bild auszuwählen.
Sobald die Anordnung funktioniert, schützen Sie sie. Wenn ein Seed- oder ein ähnliches Wiederverwendungssteuerelement verfügbar ist, behalten Sie es bei, während Sie sekundäre Änderungen testen. So können Sie Kleidungs-, Beleuchtungs- oder Hintergrundanpassungen vergleichen, ohne die bereits erfolgreiche visuelle Anordnung zu verwerfen.
Die Wahl der Leinwand beeinflusst ebenfalls das Ergebnis. Verwenden Sie ein Hochformat für die Ausrichtung eines Buchumschlags oder vertikale Social-Media-Inhalte und ein Querformat, wenn die Szene auf beiden Seiten Platz benötigt. Es ist sicherer, das Seitenverhältnis vor der Generierung auszuwählen, als nachträglich ein Gesicht, ein Produkt oder einen beabsichtigten leeren Bereich wegzuschneiden.
Gezielte Bearbeitungen halten Iterationen informativ:
Behalten Sie die gewählte Version und eine kurze Notiz zu jeder Überarbeitung. Diese Aufzeichnung verhindert wiederholte Experimente und hilft, Credits und Aufmerksamkeit zu sparen. Das Ziel ist eine starke Struktur mit bewussten Verfeinerungen, nicht endlose Generierungen.
Ein kurzes Tutorial zeigt die Benutzeroberfläche und den Ablauf im Kontext:
Die Generierungsgeschwindigkeit hängt vom Bereitstellungs-Stack und der Hardware sowie vom Modell ab. Ein Technikbericht maß eine durchschnittliche Latenz von3,91 Sekundenbei einem Standard-Setup mit Stable Diffusion 2.1, von2,55 Sekundenmit DJL Serving plus Deepspeed und von2,36 Sekundenmit Inferentia-2-Hardware. Der Bericht beschreibt die schnellste Konfiguration in diesem Test als etwa40 % schnellerals die Standardkonfiguration und8 % schnellerals das Setup mit DJL und Deepspeed, wie in dieser Fallstudie zur Latenz von Stable Diffusion dokumentiert. Vergleichen Sie als Ersteller den gesamten Iterationsprozess einschließlich Generierung, Bearbeitung und Export statt nur der Modellqualität.
Ein Prompt kann fehlschlagen, selbst wenn das Motiv korrekt erscheint. Die nützliche Frage ist, was schiefgegangen ist: Objektbeziehungen deuten meist auf Mehrdeutigkeit oder semantische Drift hin, während ein fehlendes seltenes Kostüm, eine Kreatur, ein Artefakt oder historisches Detail eine schwache Modellabdeckung widerspiegeln kann.
Text-zu-Bild-Systeme können aus naturalsprachlichen Prompts inkorrekte Inhalte generieren, und separate Beispiele aus demselben Wortlaut können stark voneinander abweichen. Die Forschung zu seltenen Konzepten ergab, dass25 % der ImageNet-Konzeptein einem öffentlichen Diffusionsmodell schlecht generiert wurden, wobei sich die Fehler auf Konzepte konzentrierten, die durch weniger als10.000 Trainingsbeispielerepräsentiert wurden. Die Ergebnisse werden in dieserForschungsarbeit zu seltenen Konzepten und Diffusionsmodellen veröffentlicht.
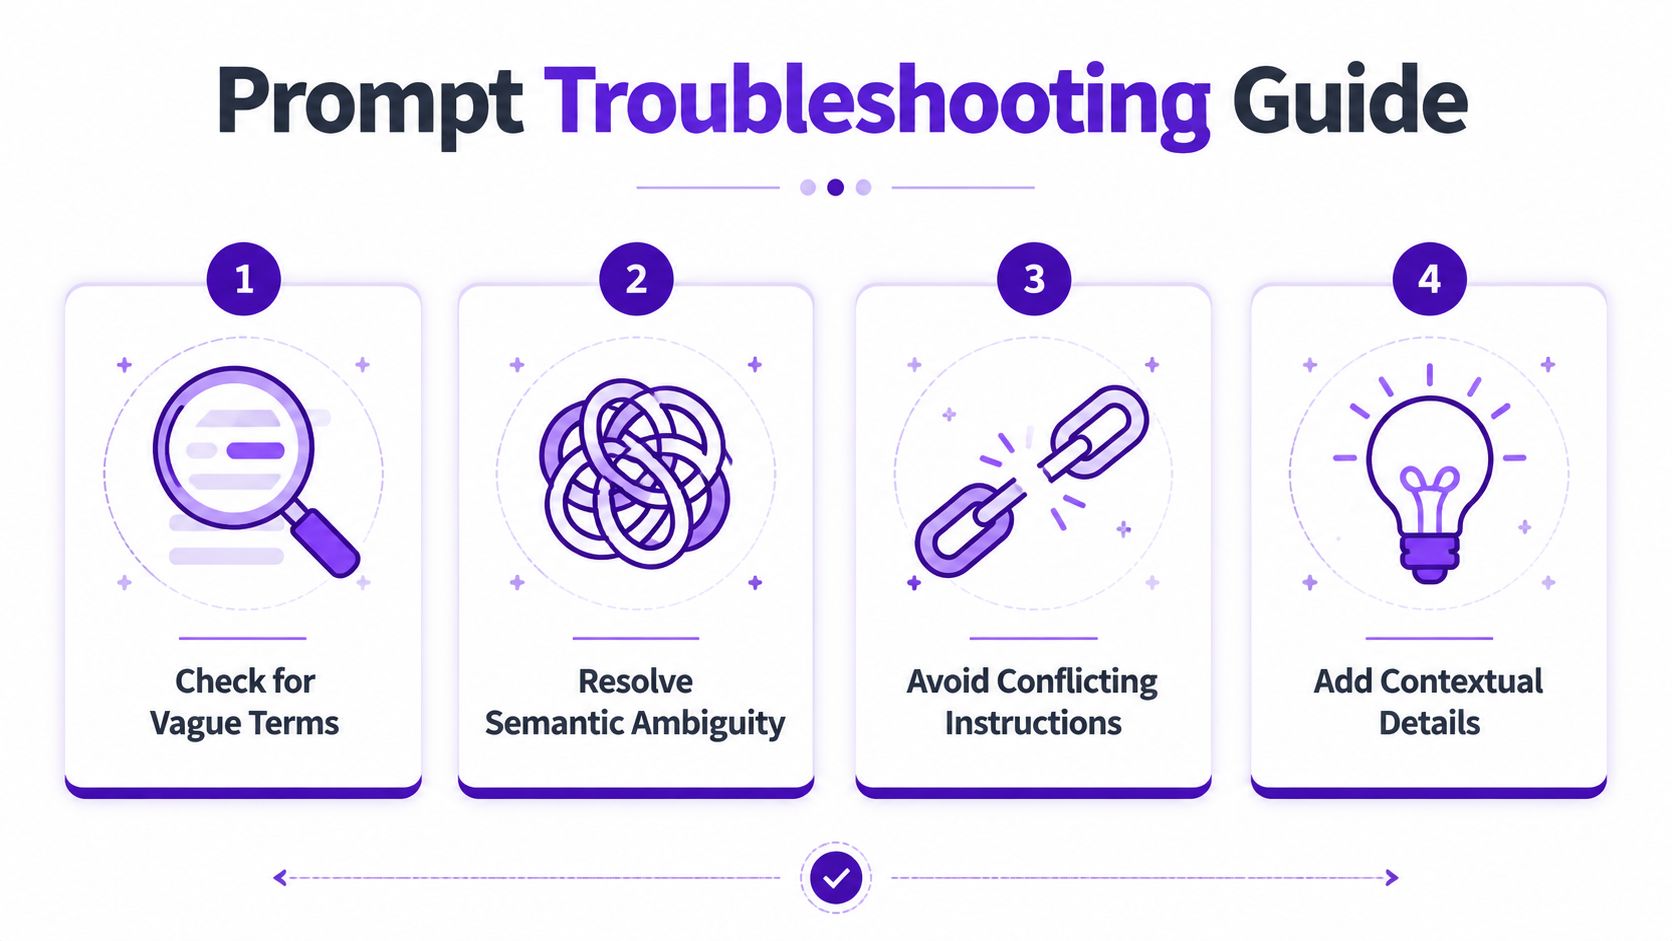
Klassifizieren Sie den Fehler und ändern Sie dann eine Variable nach der anderen:
Komplexe Szenen gelingen besser, wenn sie in Teilen inszeniert werden. Etablieren Sie zuerst den Hauptcharakter und bauen Sie dann die Umgebung auf; nutzen Sie dabei Referenzen oder Bearbeitungswerkzeuge, sofern starryai diese unterstützt. Spezifizieren Sie bei Gruppen Tiefe, Positionen und Kameraeinstellung. „Drei Personen in einem Café“ listet Motive auf; „zwei Freunde an einem Fenstertisch, Barista im Hintergrund, Medium Shot auf Augenhöhe, Hände auf dem Tisch sichtbar“ beschreibt ein Bild.
Die Prompt-Schwierigkeit lässt sich auch vor der Generierung bewerten. Der PQPP-Benchmark nutztüber 10.000 manuell annotierte Abfragen,um die Generierungs- und Abrufleistung zu bewerten. Er bietet eine Methode zur Vorbewertung schwieriger Prompts und leitet mehrdeutige Eingaben an stärkere Modelle oder Überarbeitungsworkflows weiter. Seine Methodik wird imPQPP-Benchmark-Papier.
beschrieben. Seltene Konzepte erfordern konkrete visuelle Deskriptoren und, wo zulässig, ein Referenzbild. Zusätzliche Adjektive können kein Wissen ersetzen, über das das Modell nicht verfügt. Wechseln Sie nach mehreren fehlgeschlagenen Versuchen das Modell oder vereinfachen Sie die Darstellung, anstatt weitere Credits für nahezu identische Prompts zu verbrauchen. Dokumentieren Sie Formulierung, Änderung und Ergebnis, damit erfolgreiche Korrekturen reproduzierbar bleiben.
Der Stil bestimmt Komposition, Farbverhalten, Oberflächenstruktur und emotionale Signalwirkung, was ihn zu einer strukturellen Entscheidung statt zu einem finalen Schliff macht. Dasselbe Motiv kann als vertrauenswürdige Dokumentarfotografie, verspielte flache Illustration oder fantastische, malerische Concept-Art wirken.
| Richtung | Visueller Effekt | Nützlich für |
|---|---|---|
| Fotorealistisch | Natürliche Materialien, erkennbare Beleuchtung, bodenständige Details | Produktkonzepte, Porträts, realistisch wirkende Szenen |
| Kinoreif (Cinematic) | Dramatischer Kontrast, bewusste Bildkomposition, stärkere Atmosphäre | Kampagnenbilder, Trailer, narrative Posts |
| Anime | Stilisierte Merkmale, expressive Posen, grafische Farben | Avatare, Fandom-Inhalte, Charakterkonzepte |
| Aquarell | Weiche Kanten, Papierstruktur, zurückhaltende Details | Literarische Projekte, Schreibwaren, sanfte redaktionelle Arbeit |
| Flache Vektorillustration | Klare Formen, reduzierte Paletten, lesbare Silhouetten | Icons, Erklärgrafiken, einfache Merch-Designs |
Die integrierten Stil-Voreinstellungen von starryai können bei derselben Motivbeschreibung völlig unterschiedliche Ergebnisse erzielen. Betrachten Sie die Voreinstellung als visuelle Einschränkung, nicht als dekorativen Button. Sie beeinflusst, wie der Generator Beleuchtung, Kanten, Details und Stimmung interpretiert; testen Sie daher denselben Basis-Prompt, bevor Sie den Wortlaut umschreiben.
Für ein Indie-Buchcover müssen eine kontrollierte Palette und bewusster negativer Raum die Kompositionsentscheidungen der Voreinstellung überstehen. Ein Etsy-Design benötigt eine Silhouette, die in der Thumbnail-Größe lesbar bleibt, während ein Gaming-Avatar ein klares Gesicht, eine starke Farbtrennung und eine zusschnittsichere Pose erfordert. Die attraktivste Voreinstellung in einer Ansicht in Originalgröße versagt möglicherweise, sobald das Asset verkleinert oder neben Text platziert wird.
Social-Media-Inhalte verlangen ebenfalls nach schneller Wiedererkennung, aber „virale“ Ästhetiken beschreiben keinen zuverlässigen Stil. Eine glänzende Selfie-Transformation, ein verträumtes saisonales Porträt und ein Retro-Gaming-Charakter basieren auf unterschiedlichen Paletten, Beleuchtungsaufbauten und Oberflächenbehandlungen. Spezifizieren Sie diese Entscheidungen, anstatt nach dem „TikTok-Stil“ zu fragen, was zu viel Raum für Interpretation lässt.
Ein praktischer starryai-Test verwendet einen Basis-Prompt und mehrere Voreinstellungen:
Halten Sie das Motiv, die Kameraperspektive und die Szenenanordnung stabil, während Sie die Voreinstellung ändern. Vergleichen Sie, wo die jeweilige Version den Fokuspunkt platziert, wie sie mit dem hellsten Bereich umgeht und ob ihre Textur das Beschneiden überlebt. Notieren Sie die Voreinstellung, den Prompt-Wortlaut und nützliche Fehler. Ein seltsamer Schatten oder ein übermäßig unruhiger Hintergrund können eine Einschränkung offenbaren, die in der nächsten Iteration korrigiert werden muss.
Schöpfer, die wiederholt veröffentlichen, sollten die Erstellung von Assets mit der Veröffentlichungsplanung verknüpfen. EinSocial-Media-Planungs-Workflow für Künstlerkann Variationen, Bildunterschriften und das Plattform-Timing organisieren, aber eine konsistente visuelle Ausrichtung stammt dennoch aus einem kleinen, wiederverwendbaren Stilvokabular.
Wählen Sie den Stil, den Ihr Publikum schnell wiedererkennen kann, und wiederholen Sie dann seine prägenden Merkmale über verwandte Assets hinweg. Eine kohärente Serie gibt Betrachtern ein klareres Gefühl dafür, was zusammengehört, als zusammenhanglose Experimente, selbst wenn einzelne Bilder beeindruckend aussehen.
Die Annahme „Ich habe den Prompt geschrieben, also besitze ich das Bild“ ist unsicher. Die Leitlinien des US Copyright Office aus dem Jahr 2025 besagen, dass KI-generierte Ergebnisse urheberrechtlich schützbar sein können, wenn ein Mensch ausreichende expressive Elemente beisteuert, aberdas Prompting allein reicht nicht aus. Menschliche Bearbeitung oder kreative Anordnung können sich qualifizieren, abhängig von der Arbeit und dem Beitrag.
Diese Unterscheidung ist für Indie-Autoren, Etsy-Verkäufer und Vermarkter wichtig. Eine Plattform erlaubt möglicherweise die kommerzielle Nutzung unter ihren Bedingungen, während das Urheberrecht immer noch Ungewissheit hinsichtlich exklusiven Schutzes oder Durchsetzbarkeit lässt. Das globale Bild bleibt ebenfalls ungelöst, wobei derBericht des US Copyright Office über generative KIauf den Standard für menschliche Beiträge und internationale Unsicherheit eingeht.
Führen Sie Aufzeichnungen über Ihre Prompts, Quellskizzen, Referenz-Assets, Bearbeitungen und Kompositionssendungen. Fügen Sie in einem Editor aussagekräftige, von Menschen geschaffene Elemente hinzu, insbesondere wenn das Bild ein Produkt, Buch, eine Werbung oder eine Markenidentität unterstützen soll. Überprüfen Sie die aktuellen Bedingungen des Generators vor einer kommerziellen Veröffentlichung, da Lizenzierung, öffentliche Sichtbarkeit, Trainingsnutzung und Anforderungen kostenpflichtiger Tarife variieren können.
Trainingsdaten schaffen eine weitere Ebene der Unsicherheit. Eine rechtliche Analyse aus Berkeley aus dem Jahr 2025 erklärt, dass generative Bilddatensätze gescrapte urheberrechtlich geschützte und gemeinfreie Bilder, Bildunterschriften oder Labels enthalten können und dass Datensätze selbst als urheberrechtlich geschützte Zusammenstellungen gelten können. DieBerkeley-Analyse zu KI-Generierung und Trainingsdatenmacht die Provenienz zu einem Produkt- und Geschäftsanliegen und nicht nur zu einem technischen Detail.
Der EU-Ansatz variiert ebenfalls je nach Ausnahme und Institution. DerBericht des Copyright Office zum generativen KI-Trainingerklärt, dass die DSM-Richtlinie der EU aus dem Jahr 2019 Ausnahmen für Text-and-Data-Mining enthält, wobei Artikel 3 auf Forschungsorganisationen und kulturelle Erbe-Institutionen für die wissenschaftliche Forschung beschränkt ist. Wenn Sie synthetische Medien in der EU veröffentlichen, achten Sie auch auf Offenlegungspflichten. Die Europäische Kommission besagt, dass bestimmte generierte oder manipulierte Inhalte sichtbare Kennzeichnungen und maschinenlesbare Markierungen tragen müssen, wobei Regeln für Systeme gelten, die ab dem2. August 2026auf den EU-Markt kommen, und bestehende Systeme eine zusätzliche Frist vonvier Monatenzur Einhaltung erhalten, gemäß ihremKI-Transparenz-Update.
Für eine praktische Checkliste zur kommerziellen Nutzung mit Fokus auf generierte Kunstwerke lesen Sie vor der Veröffentlichung oder dem Verkauf dieLeitlinien zu den kommerziellen Nutzungsrechten von starryai.
starryai verwandelt geschriebene Prompts in KI-Kunstwerke und bietet Tools zum Erstellen von Variationen, Remixen, Retuschieren, Hochskalieren, Herunterladen und Teilen. Probieren Siestarryaimit einem spezifischen visuellen Briefing aus, bewahren Sie die stärkste Komposition und bauen Sie Ihr finales Bild durch zielgerichtete Iterationen auf statt durch zufällige Prompt-Änderungen.


