

Geschrieben vonMo Kahnam
26. Juli 2026


Du bist wahrscheinlich an dem Punkt angelangt, an dem deine Prompts ganz gut sind, deine Ideen stark, aber die Ergebnisse sich immer noch ein wenig zu generisch anfühlen. Vielleicht sieht der Held deines Indie-Romans immer aus wie ein typischer Fantasy-Charakter von der Stange, oder deine Etsy-Mockups driften alle in dieselbe fade Ästhetik ab, egal wie sorgfältig du den Prompt formulierst. Das ist meistens der Moment, in dem das Training eigener KI-Modelle weniger wie eine technische Spielerei und mehr wie eine kreative Entscheidung wirkt, die du richtig treffen musst.
Ein Indie-Autor möchte, dass ein wiederkehrender Charakter auf einem Cover, einem Teaser-Bild und einer Charakterkarte gleich aussieht. Ein Etsy-Verkäufer möchte eine Merch-Linie, die nicht nach derselben Internet-Ästhetik aussieht, die alle anderen verwenden. In beiden Fällen lautet die Frage nicht „Kann KI helfen?“, sondern „Welcher Weg passt zur Aufgabe?“.
Es gibt vier echte Optionen.Standardmodellesind der schnellste und günstigste Ausgangspunkt, und sie reichen aus, wenn das Ergebnis keine streng kontrollierte Identität erfordert.Retrieval-basierte Personalisierungfunktioniert, wenn der Assistent aus freigegebenen Dateien, Websites oder Cloud-Quellen antworten muss, anstatt das Modell selbst zu verändern – was in Geschäftsumgebungen oft die Standardbedeutung von „Trainieren mit deinen Daten“ ist.Benutzerdefiniertes GPT-Training und Retrieval. Fine-Tuningpasst ein bestehendes vortrainiertes Modell für eine Markenstimme, einen visuellen Stil oder ein aufgabenspezifisches Muster an.Training von Grund aufist der aufwendigste Weg, und die meisten Creator benötigen ihn nicht.
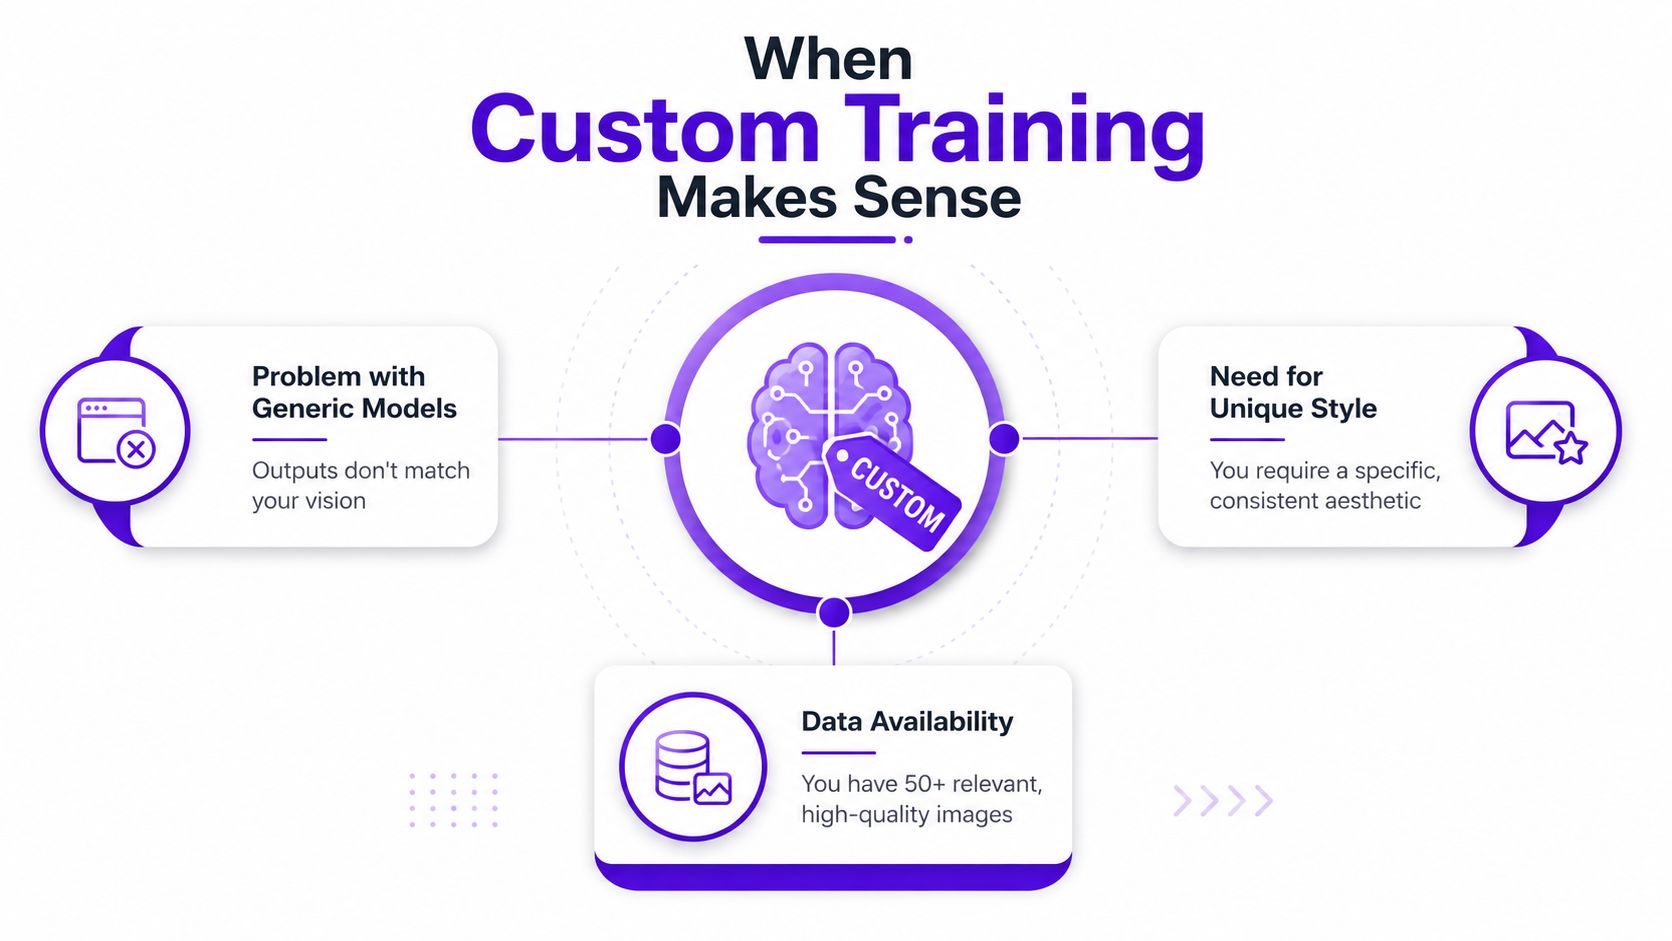
Praktische Regel:Trainiere ein eigenes Modell nur dann, wenn das generische Ergebnis deine Domäne immer wieder verfehlt, dein monatliches Inferenzvolumen hoch genug ist, um den Mehraufwand zu rechtfertigen, oder deine Anforderungen an Latenz und Markenkonsistenz streng sind.
Ein nützlicher historischer Meilenstein istBERT im Jahr 2018, das dazu beitrug, das aufgabenspezifische Fine-Tuning auf Basis vortrainierter Foundation-Modelle zu etablieren. Die ursprünglichen BERT-Arbeiten von Google berichteten überbahnbrechende Ergebnisse bei 11 NLP-Aufgaben, einschließlich eines Sprungs von90,9 % auf 94,9 %beim damaligenGLUE-Benchmark, was zeigte, wie angepasste Modelle generische Ansätze schlagen können, wenn sie auf eine bestimmte Aufgabe abgestimmt sind.Oracles Übersicht zum Training von KI-Modellen. Derselbe Wandel ist der Grund, warum kleine Teams heute ein Modell anpassen können, anstatt eines von Grund auf neu zu erstellen.
Ein kurzer mentaler Check hilft:
Der Datensatz entscheidet meistens darüber, ob sich Ihr Modell ausgereift oder seltsam unpassend anfühlt. Das gilt insbesondere für Kreativ-Workflows, bei denen ein einziges unscharfes Bild, eine falsch beschriftete Bildunterschrift oder eine doppelte Referenz das Ergebnis eher in Richtung Eintönigkeit als in Richtung Stil lenken kann.
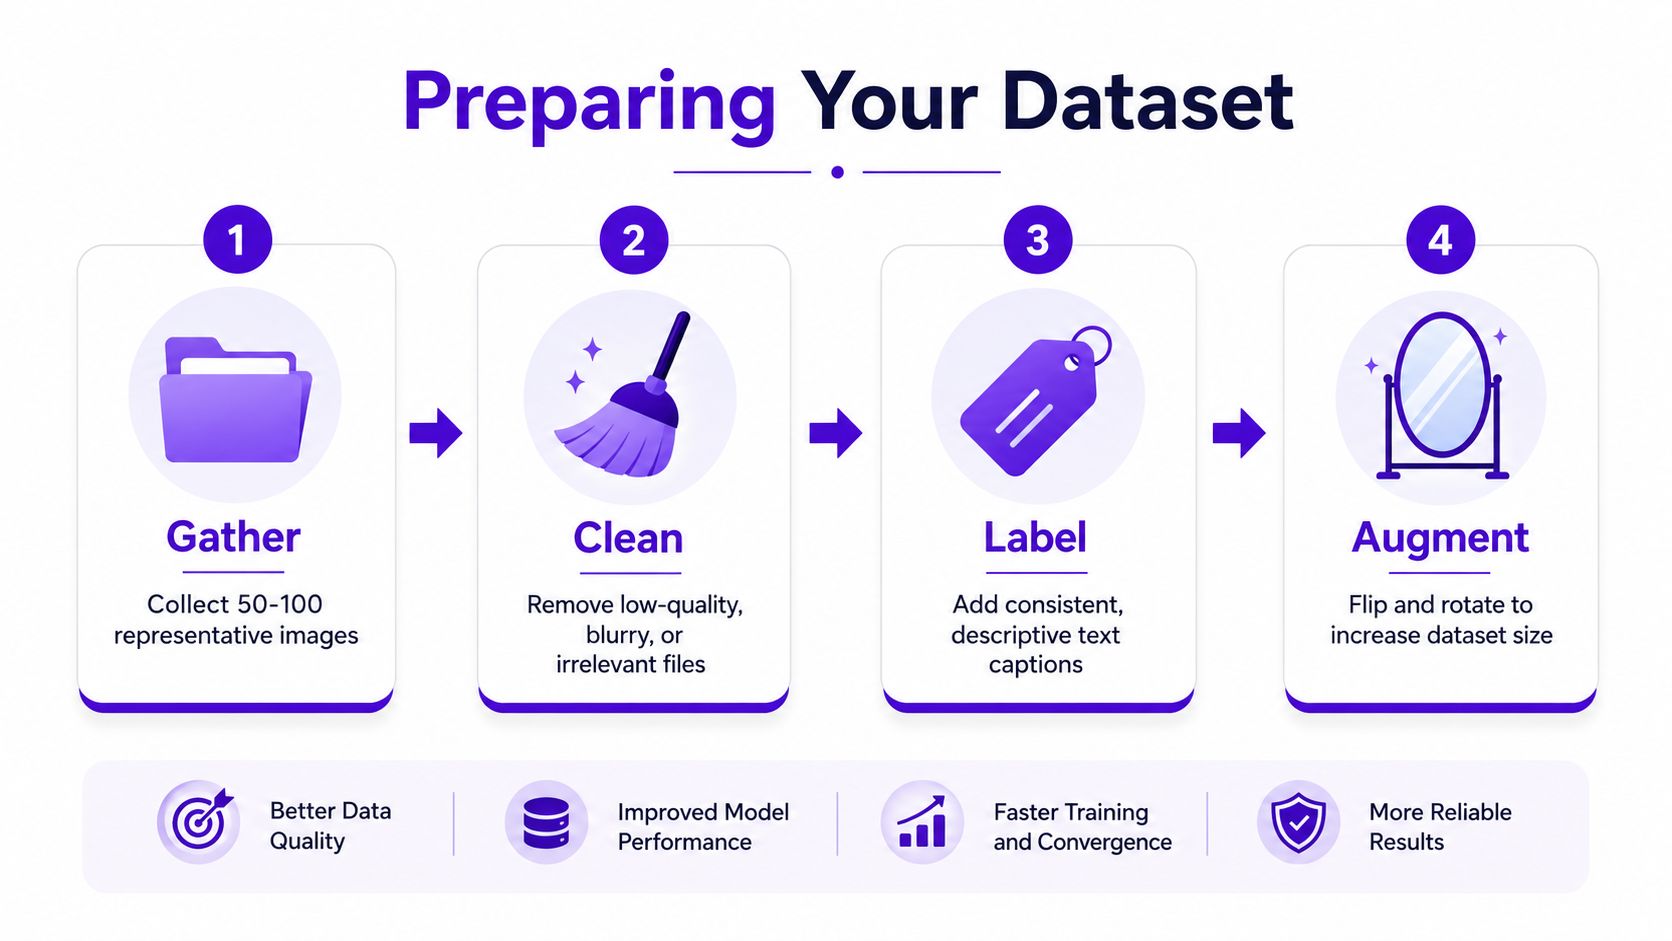
Beginnen Sie damit, nur Bilder oder Texte zu sammeln, die auch wirklich in das Modell gehören. Ein fokussierter Satz ist einem breiten Haufen gemischten Referenzmaterials überlegen, da das Modell das Muster lernt, das Sie ihm am häufigsten zeigen. Für die Erstellung von Creator-Bildern ist ein praktischer Ausgangspunkt12 bis 20 Bildermit Beschriftungen, und das Quellmaterial empfiehlt außerdem einMinimum von 10 Bildern, wenn Beschriftungen enthalten sindimage training setup.
Bereinigen Sie den Datensatz im Anschluss gründlich. Entfernen Sie Duplikate, minderwertige Dateien, irrelevante Ausreißer und fehlerhafte Beschriftungen. Der Grund ist einfach: Das Modell kann nicht zwischen „wichtig“ und „zufällig“ unterscheiden, es sei denn, Ihre Daten haben diese Arbeit bereits für es erledigt. Die klarste Struktur ist nach wie vor die klassische Aufteilung:70 bis 80%für das Training,10 bis 15%für die Validierung und10 bis 15%für das Testendataset split guidance.
Ihr Validierungssatz ist wichtiger, als viele Anfänger denken. Der Trainingsverlust (Training Loss) kann weiter sinken, während der Validierungsverlust (Validation Loss) beginnt, nach oben abzudriften, und diese Lücke ist das früheste Anzeichen von Overfitting (Überanpassung). Wenn das Modell Ihren Datensatz auswendig lernt, anstatt den Stil zu lernen, sehen Sie normalerweise großartig aussehende Trainingsbeispiele und enttäuschende neue Ausgaben.
Der operationellere Teil betrifft Verzerrung (Bias) und Abdeckung. Ein Creator-Modell sollte Variationen in Pose, Beleuchtung, Winkel, Hintergrund und Bildausschnitt enthalten, damit das Ergebnis nicht auf einen einzigen, engen Look festgelegt wird. Eine interne Workflow-Referenz, die viele Teams für die Organisation von Datensätzen verwenden, istcollection management guidance, da das Problem oft weniger darin besteht, Bilder zu generieren, als vielmehr darin, die Quellbibliothek ordentlich genug für das Training zu halten.
Bewahren Sie neben jedem Datensatz eine Notiz auf: Woher er stammt, was Sie entfernt haben und warum Sie die finalen Beispiele behalten haben. Diese Aufzeichnung spart später Stunden, wenn sich ein Modell seltsam verhält und Sie die Ursache zurückverfolgen müssen.
Creator benötigen in der Regel nicht die schwerwiegendste Methode. Sie brauchen die Methode, die den Look bewahrt, der ihnen wichtig ist, ohne Zeit, Rechenleistung oder ihren Verstand zu verschlingen. Deshalb hängt die richtige Wahl davon ab, ob Sie dem Modell ein vollständiges Verhalten, einen leichten Stil oder einfach nur ein Auslösewort (Trigger Word) für ein visuelles Konzept beibringen möchten.
| Methode | Benötigte Daten | Trainingszeit | Am besten geeignet für |
|---|---|---|---|
| Fine-Tuning | Mehr kuratierte Beispiele, breitere Abdeckung | Länger | Markenstimme, Aufgaben-Spezialisierung, tiefere Verhaltensänderungen |
| LoRA | Moderater, fokussierter Datensatz | Kürzer | Charaktere, Stile, Creator-Visuals, schnelle Iterationen |
| Textual Inversion | Kleiner Satz von Konzepten | Kürzeste | Neue Token, einfache Stil-Hinweise, enge visuelle Auslöser |
Fine-Tuningändert mehr vom Verhalten des Modells, daher ist dies die schwerwiegendere Option, wenn Sie eine tiefere Anpassung benötigen. Dies ist nützlich, wenn das zugrunde liegende Modell die Domäne immer wieder verfehlt, erfordert jedoch auch mehr von Ihren Daten und Ihrer Geduld. Ein guter Ausgangspunkt für das konzeptionelle Verständnis von Workflows im Diffusionsstil ist der umfassendere Erklärungstext zuGrundlagen des Stable-Diffusion-Trainings, weil viele Bildersteller diesen Methoden zuerst in diesem Ökosystem begegnen.
LoRAist die Option, zu der viele Kreative tendieren. Sie ist leichter, schneller und einfacher anzupassen, wenn man ein Charaktergesicht, einen wiederkehrenden Avatar oder eine bestimmte Cover-Ästhetik trainiert. Sie bietet in der Regel genug Kontrolle, um einen Stil festzulegen, ohne ein vollständiges Modell-Rewrite zu erzwingen.
Textuelle Inversionist der sanfteste Ansatz. Sie funktioniert am besten, wenn man einfach nur ein Token benötigt, das zuverlässig eine bestimmte visuelle Idee aufruft. Wenn das Ziel lautet „lass diesen wie mein originales Drachenmaskottchen aussehen“, kann das ausreichen. Wenn das Ziel lautet „sorge dafür, dass das Modell mein gesamtes Markensystem versteht“, tut es das meistens nicht.
Wenn das Ziel ein wiedererkennbarer Charakter ist, sollte man mit der leichtesten Methode beginnen, die zum Ziel führt. Der direkte Sprung zur vollständigen Feinabstimmung erhöht oft die Komplexität, bevor er die Qualität steigert.
Eine einfache Entscheidungsregel funktioniert gut. Wählen SieTextuelle Inversionfür ein eng gefasstes Konzept,LoRAfür die meiste stil- oder charakterbezogene Arbeit von Kreativen undFeinabstimmung, wenn Sie eine breitere Verhaltenskontrolle benötigen und bereits über die Datensatzdisziplin verfügen, um diese zu unterstützen.
Ein erster Trainingslauf ist weniger dramatisch als die Leute erwarten. Man „startet kein magisches Modell“, sondern testet, ob Datensatz, Beschriftungen und Einstellungen die Ausgabe in die richtige Richtung bewegen können, ohne dass die Stil-Konsistenz kollabiert.
Beginnen Sie mit einem Basismodell, das Ihrem Zielanwendungsfall bereits ähnelt. Für den Charakter einer Fantasy-Buchreihe bedeutet dies in der Regel ein visuell kohärentes Fundament anstelle des allgemeinsten verfügbaren Modells. Stellen Sie eine konservative Lernrate ein, damit das Modell nicht über den Look hinwegrast, den Sie ihm beibringen möchten. Bei allzu aggressivem Vorgehen werden die Ergebnisse oft schnell spröde oder neigen zum Overfitting.
Verwenden Sie Checkpointing nach jeder Epoche. Das gibt Ihnen einen Rollback-Punkt, wenn das Modell beginnt abzuweichen, und macht den direkten Vergleich viel einfacher. Der im Quellmaterial beschriebene praktische Workflow empfiehlt zudemsollwertbasierte Validierungund Ablationen, was bedeutet, kleine Teilmengen von Bildern oder Beschriftungen zu überprüfen, um zu sehen, welche Komponente hilftTrainings-Workflow-Leitfaden.
Eine einfache Creator-Style-Schleife sieht so aus:
Einfache Augmentierung hilft, sollte aber nicht die Identität des Sets übernehmen. Spiegelungen, mäßige Zuschnitte und leichte Farbanpassungen können die Stärke verbessern. Starke Verzerrungen schaden in der Regel der Stil-Treue, insbesondere wenn das Trainingsziel ein erkennbares Gesicht, Outfit oder ein Marken-Look ist.
Wenn das Modell bei Trainingsbeispielen großartig aussieht, aber bei neuen Prompts beginnt, Gesichter abzuflachen oder Hintergrundartefakte zu wiederholen, stoppen Sie den Lauf und überprüfen Sie die Beschriftungen, bevor Sie weitere Epochen hinzufügen.
Für einen ersten Lauf lautet die nützlichste Frage nicht „hat es trainiert?“, sondern „hat es die Art von Ausgabe verbessert, die ich brauche?“. Das ist der Unterschied zwischen einem technisch erfolgreichen Job und einem nützlichen Kreativ-Werkzeug.
Benutzerdefiniertes Training wird teuer, wenn die Planungsphase übersprungen wird. Ein Kreativer braucht kein Finanzteam, aber er braucht ein grobes Gefühl dafür, ab wann ein benutzerdefiniertes Setup aufhört, ein lustiges Experiment zu sein, und zu einer wiederkehrenden Infrastrukturentscheidung wird.
Ein Leitfaden schätzt, dass maßgeschneidertes Training ab ca.5 bis 10 Millionen Aufrufen pro Monatwirtschaftlich attraktiv wird oder wenn die Latenz unter50 ms Leitfaden für das Training benutzerdefinierter Modellebleiben muss. Für die meisten Kreativen liegt das weit jenseits eines typischen Buchcover- oder Avatar-Workflows. Eine gehostete API oder ein leichter benutzerdefinierter Workflow innerhalb von starryai lässt sich im kleineren Rahmen meist viel leichter rechtfertigen.
Eine praktische Art, über Ausgaben nachzudenken, ist nach Stufen:
| Training-Stufe | Typisches Compute-Gefühl | Erwartetes Ergebnis | Creator-Passform |
|---|---|---|---|
| Leicht | Ein kurzer Lauf mit einem engen Datensatz | Stil- oder Konzept-Ausrichtung | Avatare, Maskottchen-Konzepte, einfache Merch-Grafiken |
| Mittel | Mehr Iteration und Checkpoint-Vergleich | Konsistenterer Charakter- oder Marken-Look | Indie-Buchumschläge, wiederkehrende Produktgrafiken |
| Schwer | Viele Experimentierzyklen und präzisere Feinabstimmung | Tiefere Modellsteuerung | Teams mit strengen Latenz-, Domain- oder Skalierungsanforderungen |
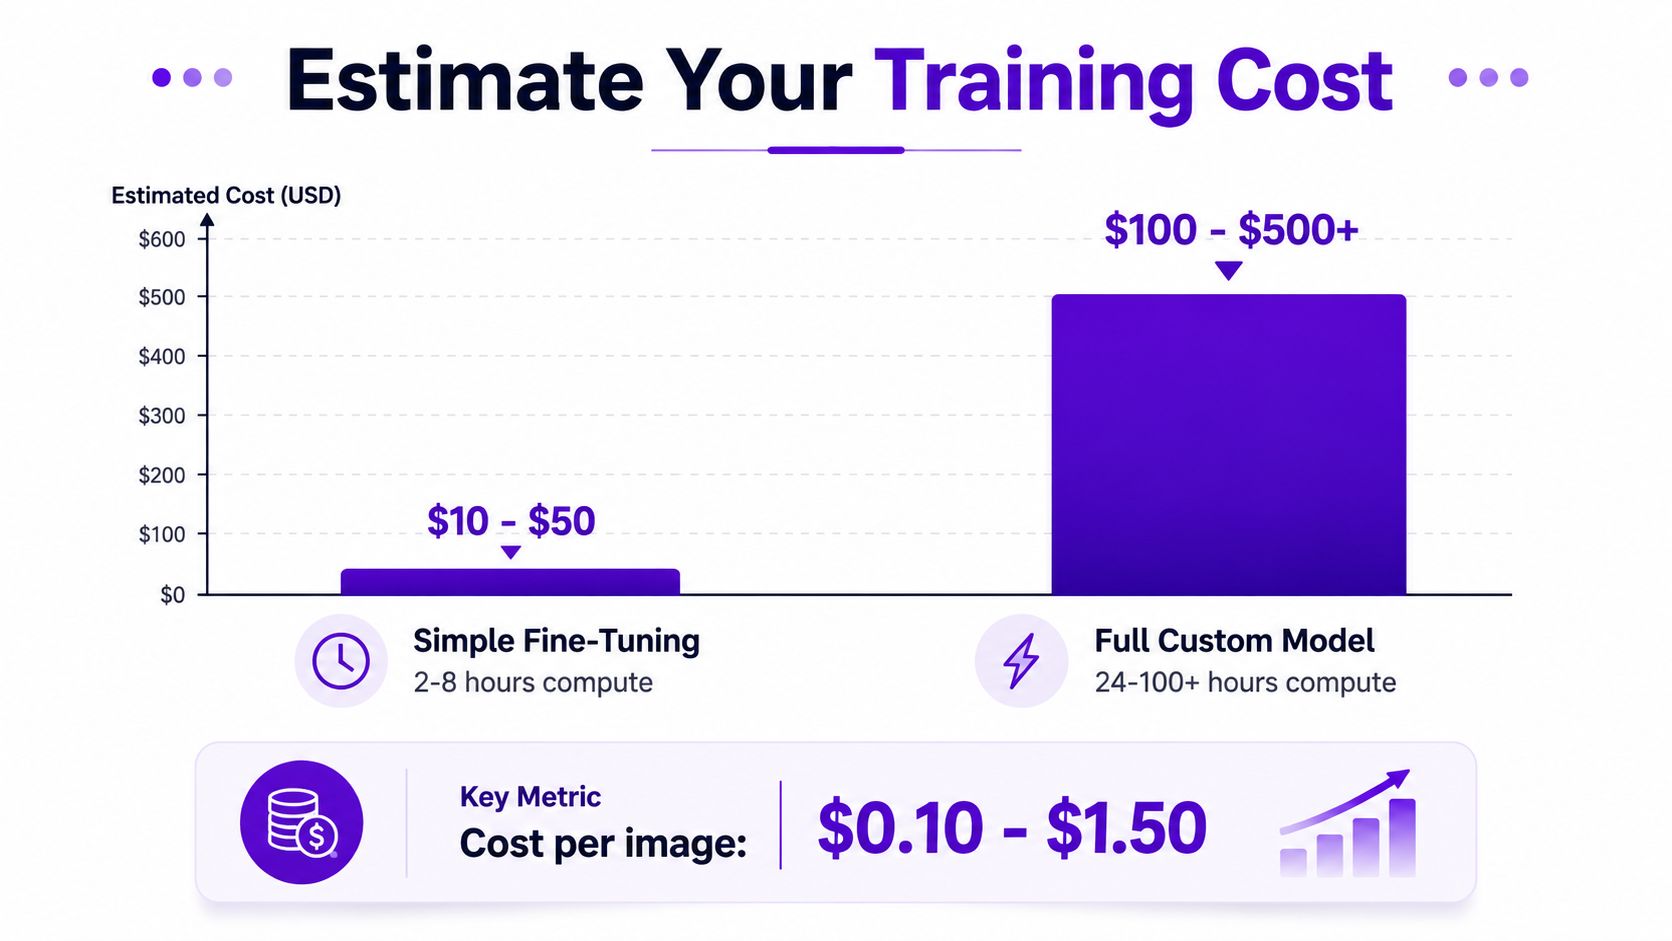
Das Ausgangsmaterial verweist zudem auf eine praktischeKosten pro Bild von 0,10 $ bis 1,50 $im Trainingskontext, der in der dazugehörigen Grafik gezeigt wirdKostenschätzungs-Grafik. Das ist keine universelle Rechnungsformel, aber ein nützlicher Planungsanker, wenn Sie entscheiden, ob Sie ein Konzept trainieren sollen oder fünf.
Wenn Sie zu Hause experimentieren, kann lokales Training auf einer Consumer-GPU für kleine Tests ausreichen. Gehostete Plattformen sind besser, wenn Sie eine kürzere Einrichtungszeit und weniger Probleme mit der Umgebung wünschen. Die Frage lautet nicht „Was ist in der Theorie am günstigsten?“, sondern „Womit komme ich zu einem nutzbaren Ergebnis, ohne eine Woche für das Setup zu verschwenden?“
Budgetieren Sie für Iterationen, nicht nur für den ersten Durchlauf. Die meisten nützlichen Modelle entstehen, nachdem Sie ein paar kleinere Durchläufe verglichen haben, anstatt alles auf einen einzigen riesigen Durchlauf zu setzen.
Ein Modell kann großartig aussehen und trotzdem unbrauchbar sein, wenn die Trainingsdaten unachtsam gesammelt wurden. Das ist der Teil, den viele Kreative unterschätzen, besonders wenn sie planen, Drucke, Cover, Avatar-Pakets oder Merchandise zu verkaufen, die auf diesen Ausgaben basieren.
Die klare Regel ist,Urheberrecht, , NutzungsbedingungenundDatenschutzbestimmungenbeim Sammeln von Web-Inhalten zu respektieren. Der Leitfaden von CIO empfiehlt außerdem, detaillierte Aufzeichnungen über Quellen und Vorverarbeitung zu führen, zusammen mit einer rigorosen Validierung, Deduplizierung, Bereinigung und regelmäßigen Audits, um Verzerrungen zu reduzierenCIO zum Training von Daten-Governance. Das sind keine abstrakten Ethikpunkte, sondern operative Kontrollen.
Sie müssen außerdem die Lizenz des Basismodells von den Rechten an Ihrem trainierten Ergebnis trennen. Ein fein abgestimmtes Modell erbt nicht automatisch jede kommerzielle Erlaubnis, die an das Basismodell geknüpft ist, und Kreativunternehmen verbrennen sich oft die Finger, wenn sie vom Gegenteil ausgehen. Wenn Sie sich nicht sicher sind, was eine Plattform erlaubt, sollten diestarryai-Lizenzbedingungenüberprüft werden, bevor Sie bezahlte Aufträge ausliefern.
Bei Ähnlichkeiten und Fan-Charakteren ist die Einwilligung wichtig. Wenn Ihr Modell eine erkennbare Person erlernt oder wenn Sie das geschützte Charakterdesign einer anderen Person trainieren, sollten Sie das als eine Frage der Rechte behandeln und nicht nur als eine ästhetische Wahl. Das ist besonders wichtig, wenn das Ergebnis zum Verkauf bestimmt ist.
Auch Bias-Prüfungen sind praktisch. Achten Sie auf systematische Verzerrungen bei Geschlecht, Alter, Hautton, Körpertyp oder kulturellen Hinweisen in Ihren Ergebnissen. Wenn eine Gruppe immer wieder auf dieselbe Weise dargestellt wird, weist der Datensatz das Modell wahrscheinlich dazu an, selbst wenn Sie das nicht beabsichtigt haben.
Eine kurze Checkliste für Rechte ist hilfreich:
Für eine breitere richtlinienbezogene Perspektive treten dieselben Fairness-Bedenken auch in anderen KI-Systemen auf, einschließlichFairness bei KI-gestütztem Recruiting. Die Kategorie ist eine andere, aber die Lehre ist dieselbe: Wenn die Daten verzerrt sind, ist es das Ergebnis auch.
Das Training ist nur die halbe Arbeit. Ein Modell, das nur in einem Notebook oder einem Trainingslauf existiert, hilft einem Autor, Verkäufer oder Social Creator nicht dabei, irgendetwas zu veröffentlichen.
Die Evaluierung sollte visuell beginnen. Vergleichen Sie Ergebnisse nebeneinander, verwenden Sie Prompt-Sweeps und fragen Sie einige echte Benutzer, welche Ergebnisse dem beabsichtigten Look am nächsten kommen. Bei Kreativprojekten fängt diese Art der Überprüfung Fehler ab, die numerische Metriken übersehen können, insbesondere wenn sich das Ergebnis markenkonform anfühlen muss und nicht nur technisch gültig.
Optimieren Sie danach für die Art und Weise, wie das Modell verwendet wird.Quantisierungkann die Dateigröße verringern und bei Speicherlimits helfen.Destillationkann die Inferenz beschleunigen. Prompt Engineering ist nach wie vor wichtig, denn ein gut trainiertes Modell kann eine schlechte Leistung erbringen, wenn der Prompt die Art und Weise ignoriert, wie er konditioniert wurde.
Eine Bereitstellungsreihenfolge, die in der Praxis funktioniert, sieht wie folgt aus:
Creator workflows often include custom avatars, book covers, and social visuals, so a platform that already supports those jobs can save time. starryai offersStyles Training, which lets users upload5 to 60 imagesof a consistent style, object, or aesthetic to train a custom style model. That makes it a practical option when the goal is a repeatable look rather than a full engineering project.
Die Überwachung nach dem Start ist wichtig. Achten Sie auf Genauigkeitsabweichungen, seltsame Grenzfälle und Qualitätsschwankungen, während Sie das Modell mit neuen Prompts füttern. Wenn die Ergebnisse nachlassen, ist ein kleiner, kuratierter Satz schwieriger Beispiele meist hilfreicher, als ganz von vorne zu beginnen.
Das Modell ist niemals „fertig“. Es bleibt nur dann nützlich, wenn Sie die Ergebnisse kontinuierlich mit dem Look abgleichen, den Sie tatsächlich erreichen möchten.
If you're ready to turn a rough visual idea into something repeatable, start withstarryai, test a focused style set, and see whether your project fits a lightweight creator workflow before you commit to a heavier training path.


