

Verfasst vonMo Kahnam


Text-zu-Bild-KI ruft kein gespeichertes Foto ab: Ein Textencoder verwandelt Ihren Prompt in Zahlen, und wiederholtes Entrauschen verwandelt zufälliges Rauschen in ein Bild, das durch diese Zahlen gesteuert wird. Die latente Diffusion, die 2022 in einflussreicher Forschung vorgestellt wurde, macht diesen Prozess effizienter, indem sie mit einer komprimierten Darstellung statt mit jedem einzelnen Pixel arbeitet.
Der beliebte Ratschlag, „einfach einen besseren Prompt zu schreiben“, greift zu kurz. Ihre Wörter steuern einen iterativen Schätzprozess, keine direkte Suche und keine Collage, weshalb das Ergebnis dauern kann, sich zwischen den Durchläufen ändern oder bei Händen, Objektanzahlen und Beschriftungen Fehler machen kann. Wenn Sie die Schritte verstehen, können Sie klarere Prompts schreiben und entscheiden, was Sie korrigieren müssen, wenn eine Generierung fehlschlägt.
Eine Text-zu-Bild-App ruft kein fertiges Bild ab und stellt keine Collage aus Ihren Wörtern zusammen. Sie verwendet Ihren Prompt, um eine Reihe von Schätzungen zu steuern, die mit zufälligem Rauschen beginnen und es schrittweise zu einem Bild formen. DieForschung aus dem Jahr 2022 zur latenten Diffusion und dem Bilderzeugungsprozessbeschreibt, wie sich dieser Prozess von Rauschen zu einem Bild entwickelt, das zum Prompt passt.
| Stufe | Was das Modell tut | Was Sie sehen |
|---|---|---|
| Textkodierung | Ein Sprach-Encoder wandelt den Prompt in numerische Embeddings um | Noch nichts sichtbar |
| Rauschbeginn | Die Generierung beginnt mit zufälligem Gaußschen Rauschen | Graues Rauschen ohne Objekte |
| Frühes Entrauschen | Die ersten Schritte legen Gesamtform, Objekte und Layout fest | Eine verschwommene Komposition |
| Spätes Entrauschen | Spätere Schritte fügen Farbe, Textur und feine Details hinzu | Schärfere Oberflächen und Kanten |
| Dekodieren | Ein Decoder wandelt die latente Darstellung wieder in Pixel um | Das fertige Bild |
Die Phasen erklären, warum eine frühe Vorschau verschwommen wirken kann, aber dennoch das Layout der Szene zeigt. Die Textcodierung bereitet numerische Anweisungen vor, während das Anfangsrauschen keine erkennbaren Objekte enthält. Das frühe Entrauschen legt die grobe Komposition fest; spätere Schritte verfeinern hauptsächlich Farben, Oberflächen und Kanten.
Texteinflussbeschreibt, wie stark der Prompt das Entrauschen steuert. Einige Apps stellen dies als Gewichtungsskala dar. Eine höhere Einstellung bringt das Ergebnis näher an den Wortlaut heran, kann das Bild jedoch härter wirken lassen. Eine niedrigere Einstellung gibt der Generierung mehr Spielraum zum Abweichen. Der Prompt gibt das Ziel vor; die Einstellung des Texteinflusses bestimmt, wie streng der Prozess diesem folgt.
Das direkte Entrauschen jedes einzelnen Pixels würde mehr Rechenleistung und Speicher erfordern. Die latente Diffusion komprimiert ein Bild zunächst in eine kleinere Darstellung, führt das Entrauschen dort durch und decodiert das Ergebnis anschließend wieder in Pixel. Dies macht es praktischer, höher aufgelöste Bilder zu erzeugen, ohne dabei während des gesamten Prozesses jedes Pixel verfeinern zu müssen.
Sie können eine Vorschau wie einen Entwurf betrachten: Achten Sie zuerst auf die Komposition und prüfen Sie dann, ob die Details auftauchen, während das Bild schärfer wird. KI-Unterstützung für die akademische Forschung ist ein weiteres Beispiel dafür, wie KI einen schrittweisen Arbeitsprozess unterstützt.
Trainingspaare sind Lektionen und kein Archiv fertiger Bilder, die darauf warten, von der App kopiert zu werden. Jedes Paar verknüpft ein visuelles Beispiel mit Wörtern, die es beschreiben, und hilft einem Modell dabei, Verbindungen zwischen Sprache und visuellen Mustern zu erlernen. Diese Verbindungen können ein Motiv, dessen Eigenschaften, die Anordnung einer Szene und einen visuellen Stil umfassen.
Der Umfang der Trainingsdaten ist wichtig, aber das gilt ebenso für die Qualität der Bildunterschriften. LAION-5B, ein öffentlich zugängliches Dataset, das in der Bild-Text-Forschung verwendet wird, enthält etwa5 Milliarden Bilder, von denen laut derForschung zum LAION-5B-Bild-Text-Datasetetwa2 Milliardenentsprechende englische Bildunterschriften besitzen. Das Modell lernt Muster aus diesen Beispielen; es verwendet sie nicht als Nachschlagetabelle für fertige Bilder.
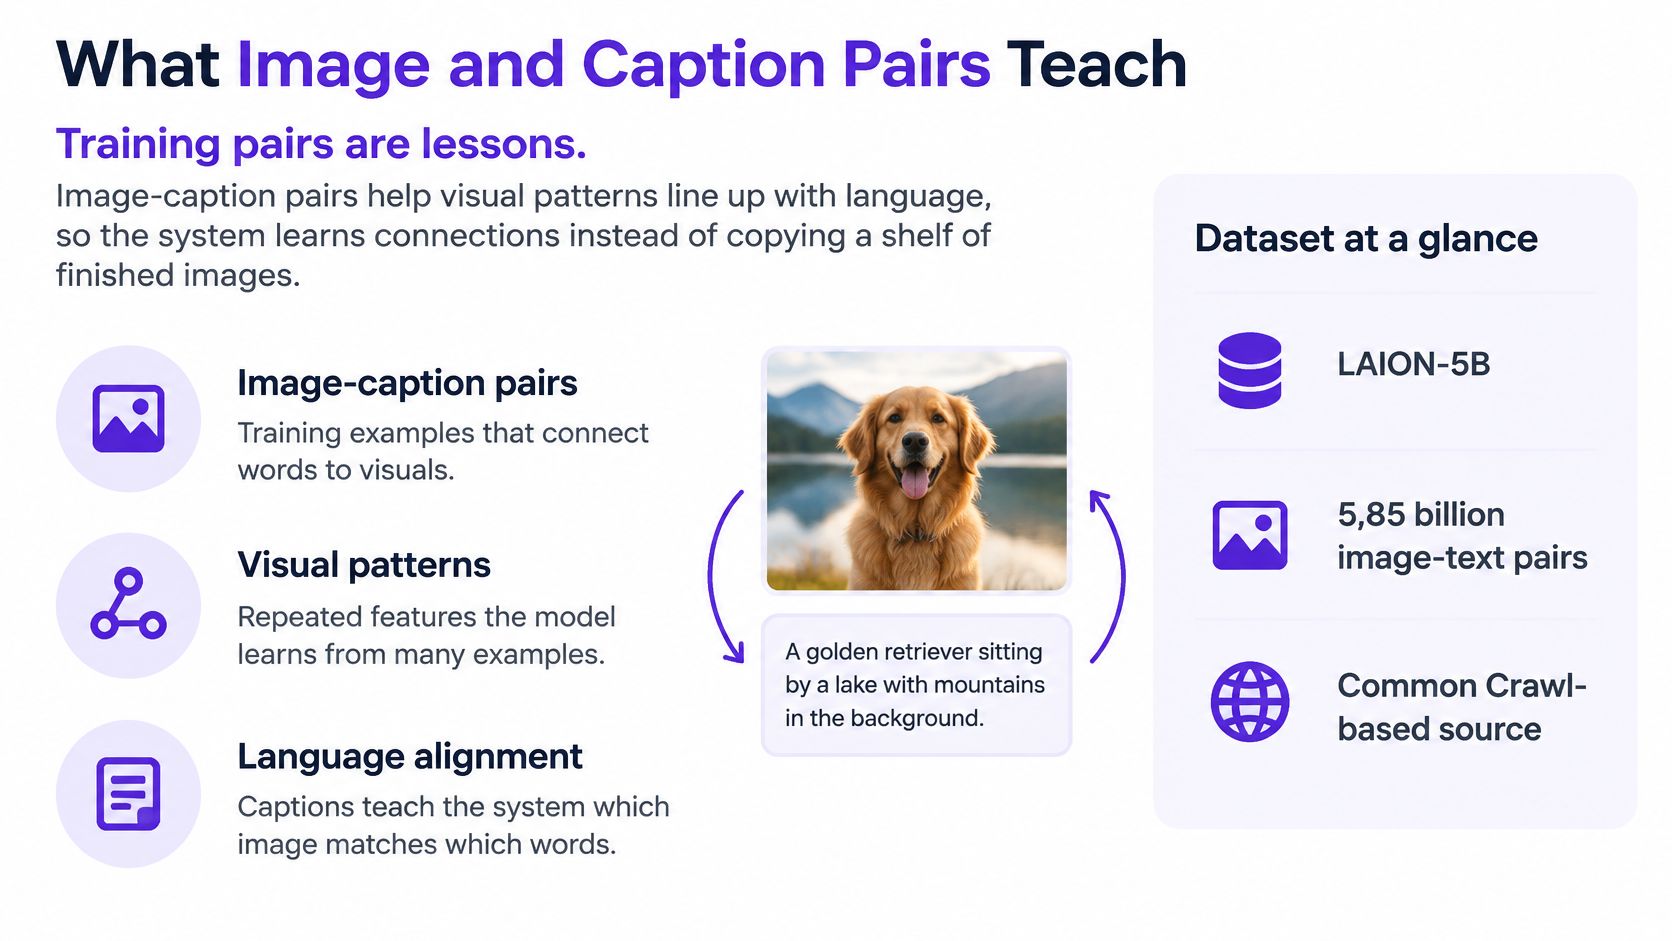
Bildunterschriften beeinflussen, was das Modell lernen kann, mit einem Bild zu verknüpfen. Dichte, qualitativ hochwertige Bildunterschriften können verbessern, wie gut generierte Bilder dem Text folgen. Der Nachteil ist, dass sie auch die ästhetische Qualität und die Vielfalt der Ergebnisse verringern können. Ein System, das aus präzisereren Beschreibungen lernt, ist möglicherweise besser darin, genannte Details abzugleichen, ohne dabei ein breiteres Spektrum an Looks zu erzeugen.
Dies hilft zu erklären, warum das Befolgen von Prompts nicht nur eine Frage davon ist, ein visuelles Modell größer zu machen. Das Modell hängt auch davon ab, ob seine Trainingsunterschriften jedes Bild klar genug beschrieben haben. Wenn ein ungewöhnliches Kostüm, eine Nischen-Spielfigur oder eine markante Marke in nur wenigen gut beschriebenen Beispielen vorkommt, verfügt das System möglicherweise über schwächere Muster, auf die es zurückgreifen kann.
Zerlegen Sie für ein obskures Motiv die Idee in visuelle Merkmale, die das Modell ausdrücken kann: die Form eines Kostüms, dessen Materialien und Farben, die Körperteile der Kreatur oder die Position einer logoähnlichen Markierung. Ein Prompt, der diese sichtbaren Teile beschreibt, gibt dem System mehr an die Hand als ein reiner Insidername.
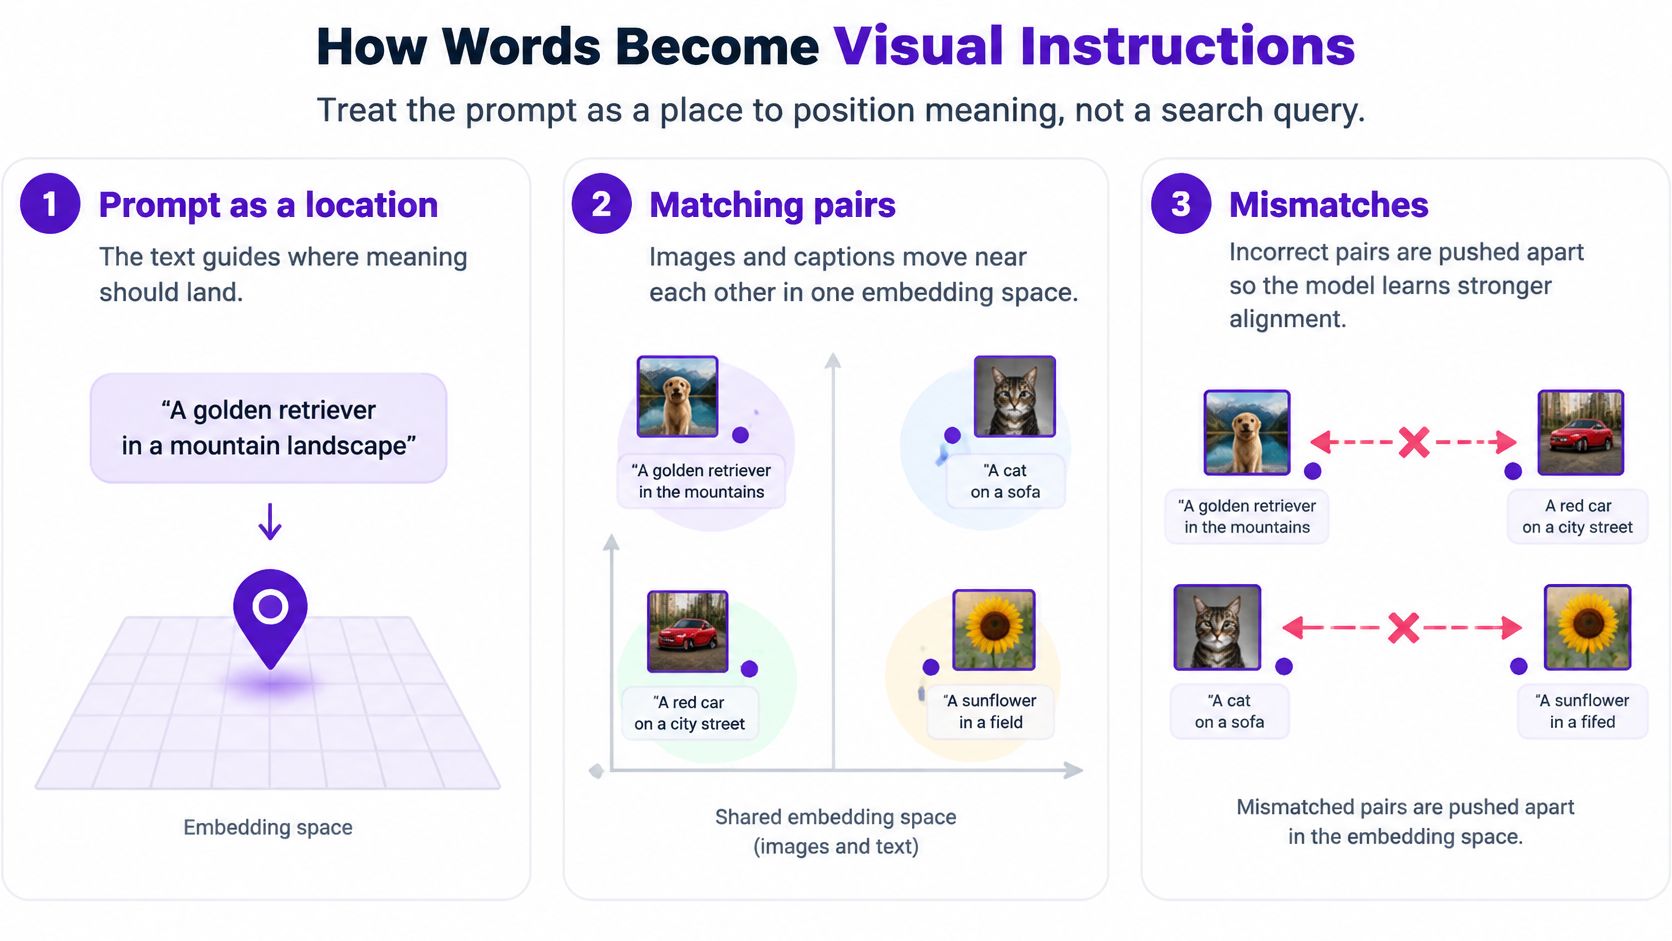
Stellen Sie sich einen gemeinsamen Raum vor, in dem Bilder und ihre Bildunterschriften jeweils ihren Platz haben. Eine gute Bildunterschrift befindet sich in der Nähe des Fotos, das sie beschreibt; eine falsche Bildunterschrift liegt weiter entfernt. Bei einem Ansatz im CLIP-Stil werden zueinander passende Bilder und Bildunterschriften in einem gemeinsamen Einbettungsraum nahe zusammengebracht, während nicht zusammengepasste Paare auseinandergetrieben werden. DieBeschreibung des kontrastiven Lernens in Text-zu-Bild-Systemenerklärt, wie diese Übereinstimmung in beiden Richtungen gemessen wird, von Bild zu Text und von Text zu Bild.
Zum Zeitpunkt der Generierung wird der Prompt zu einer numerischen Darstellung, die Konzepte wie Motiv, Attribute und Stil transportiert. Das Diffusionsmodell nutzt diese Darstellung zur Steuerung der Bildentstehung, anstatt den Prompt als unstrukturierten String zu behandeln. Einfach ausgedrückt versucht das Modell, die benannte Bedeutung beizubehalten und sie gleichzeitig in eine visuelle Struktur zu übertragen.
Betrachten Sie zwei Prompts für ein Kaffeebild:
„Schönes Kaffeebild.“
„Rote Emailleschale auf einer Fensterbank, morgendliches Seitenlicht, kein Text.“
Ersterer gibt dem Modell ein grobes Ziel vor, lässt jedoch viele Entscheidungen offen. Letzterer benennt das Objekt, seine Farbe und sein Material, seine Beziehung zur Fensterbank, die Beleuchtung und eine Einschränkung. Diese Details verleihen der Prompt-Repräsentation klarere Ankerpunkte.
Ein Text-zu-Bild-Prompt ist keine Suchanfrage, die das nächstbeste existierende Foto heraussucht. Er ist eine Reihe von Anweisungen, die den Prozess der Bildnerstellung leitet. Benennen Sie, was erscheinen soll, wie die Elemente zueinander stehen und welche visuellen Entscheidungen am wichtigsten sind. EinLeitfaden zur Optimierung von KI-Promptskann Ihnen dabei helfen, sich diese Gewohnheit für die Bildnerstellung anzueignen.
Der Texteinfluss wirkt sich auch darauf aus, wie stark der Prompt bei jedem Entrauschungsschritt zieht. Ein präziser Prompt gibt dem Modell klarere Konzepte an die Hand, die es zu bewahren gilt; die Einstellung des Einflusses bestimmt, wie stark diese Konzepte das entstehende Bild beeinflussen. Keines von beiden garantiert, dass jedes Detail korrekt ist.
Versuchen Sie diese Schreibgewohnheit: Benennen Sie das Motiv, eine Beziehung, einen Blickwinkel oder eine Lichtquelle sowie etwas, das weggelassen werden soll. Beispielsweise ist „rote Tasse auf einer Fensterbank, Perspektive auf Augenhöhe, weiches morgendliches Seitenlicht, keine Aufschrift“ handlungsorientierter als eine Reihe allgemeiner Komplimente. Diese Klarheit beseitigt zwar nicht die Ungewissheit, gibt dem Prozess aber ein spezifischeres Ziel.
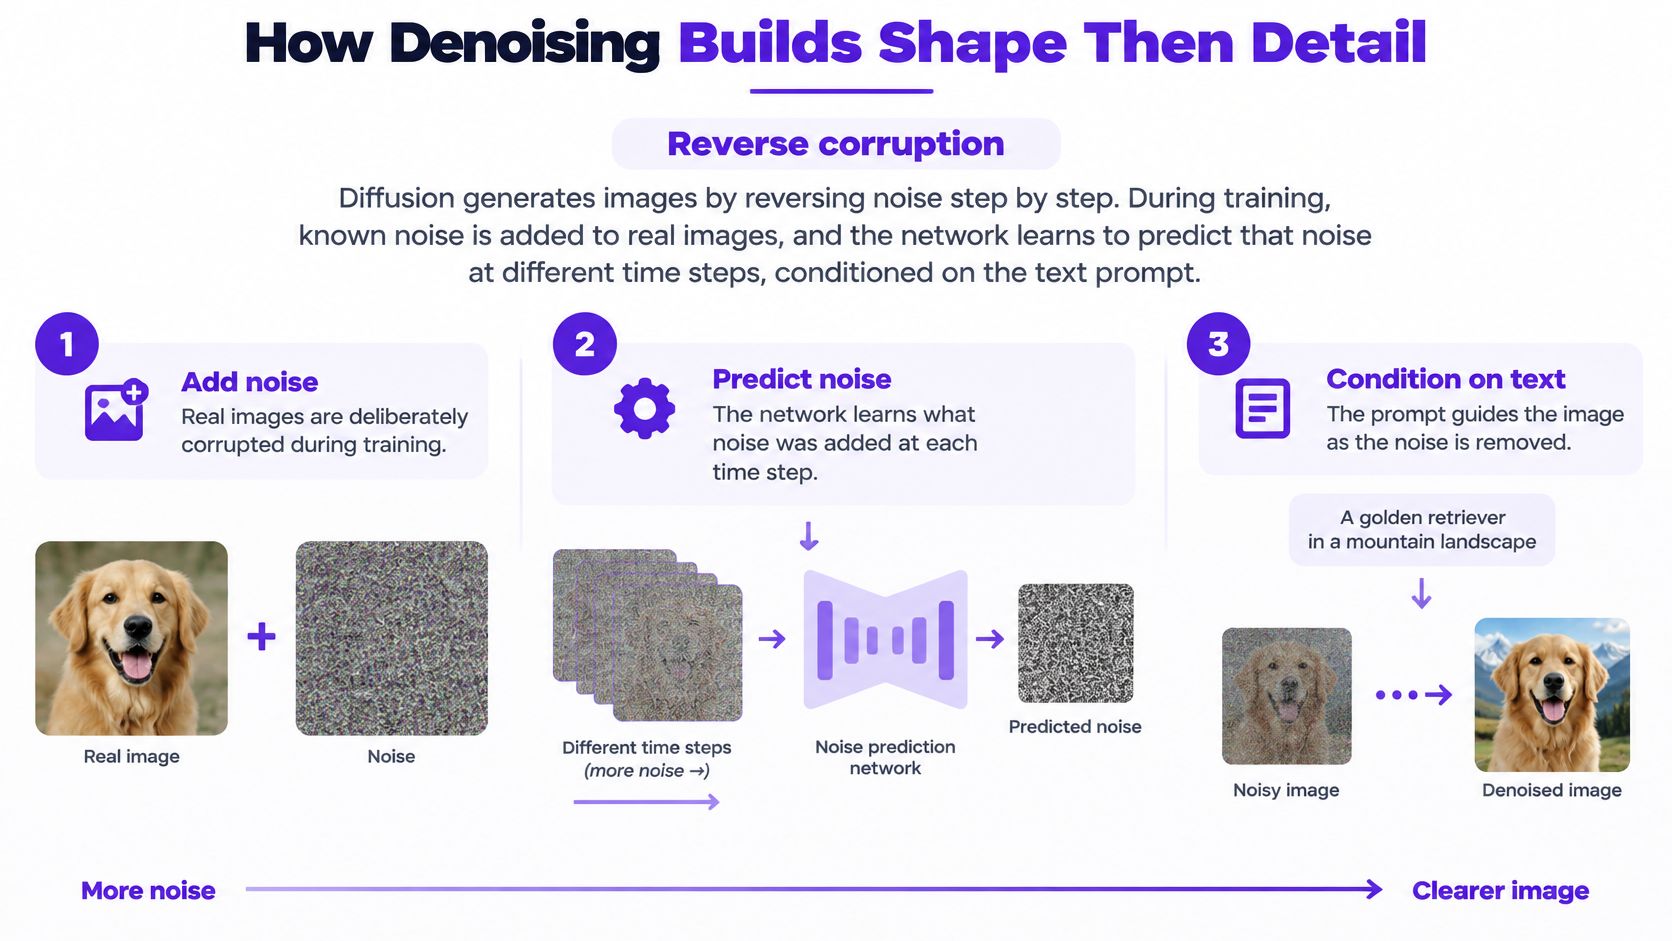
Während des Trainings sieht das Modell Bilder, die gezielt mit bekanntem Rauschen versehen wurden. Es lernt, das Rauschen zu verschiedenen Zeitpunkten vorherzusagen, während es die Textdarstellung als Bedingung nutzt. Die Generierung kehrt diese Verfälschung um: Das Modell geht von Rauschen aus und wendet wiederholt seinen gelernten Entrauschungsvorgang an, um sich auf ein Bild zuzubewegen, das zum Prompt passt.
Unter dem zufälligen Startpunkt ist kein Originalfoto versteckt. Bei der Inferenz stellt das Modell kein bestimmtes Bild wieder her, das es zuvor gesehen hat. Jeder Schritt liefert eine Vorhersage darüber, wie das entstehende Bild aussehen sollte, ausgehend vom aktuellen verrauschten Zustand und der Texteinwirkung.
Ein pixelbasiertes Diffusionssystem arbeitet direkt mit den Pixeln des Bildes, was beträchtliche Rechenleistung erfordern kann. Die latente Diffusion komprimiert das Bild zuerst, führt die Entrauschungsschritte an dieser kleineren Darstellung durch und verwendet dann einen Decoder, um das Ergebnis in Pixel umzuwandeln. Die Umstellung auf diesen Ansatz im Jahr 2022 reduzierte den Rechen- und Speicherbedarf und unterstützte gleichzeitig die hochauflösende Synthese.
Diese Effizienz hat jedoch ihren Preis. Das Modell verfeinert nicht jedes Pixel direkt während seiner Hauptgenerierungsschleife, und der Komprimierungs- sowie Decodierungsprozess kann die endgültige Qualität einschränken. Die latente Diffusion macht die Generierung praktischer, aber sie macht nicht jedes Ergebnis fehlerfrei.
Frühe Entrauschungsschritte etablieren die globale Komposition und Objektgeometrie. Spätere Schritte füllen hauptsächlich Details wie eine Stoffoberfläche, ein Glanzlicht oder eine Kante aus. Eineeinfach formulierte Einführung in Stable Diffusionbietet eine weitere Möglichkeit, einen weit verbreiteten Diffusionsansatz zu erkunden.
Diese Reihenfolge ist nützlich, wenn Sie eine Vorschau bewerten. Wenn die Pose eines Läufers oder die Position eines Buchcover-Charakters falsch aussieht, während das Bild noch verschwommen ist, ist mehr Textur nicht die Lösung. Das Modell kann eine falsche frühe Vermutung verfeinern, anstatt sie auf magische Weise zu korrigieren. Betrachten Sie den sichtbaren Fortschritt alszuerst das Layout, dann die Oberflächen, zuletzt die Pixel.
Ein Prompt wird nicht in einem einzigen Vorgang direkt in Pixel umgewandelt. Das Modell beginnt mit zufälligem Rauschen und führt eine Reihe von Vorhersagen aus, sodass die erneute Verwendung derselben Wörter zu einem anderen Ergebnis führen kann. Selbst beschleunigte Diffusionsansätze erfordern typischerweise etwa20–50 aufeinanderfolgende Entrauschungsschritte pro Bild, so eineAnalyse zu Geschwindigkeit, Inkonsistenz und praktischen Problemen bei der Text-zu-Bild-Generierung.
Dieser iterative Prozess trägt auch dazu bei, zu erklären, warum ein Prompt eine Anweisung verfehlen kann. Eine Vorhersage über Textausrichtung, Anatomie oder die Anzahl der Objekte kann nachfolgende Schritte beeinflussen. Ein längerer Prompt kann die Dinge zudem verschlimmern, wenn er konkurrierende Motive oder Stile kombiniert, wodurch das Modell eine verworrene Reihe von Anweisungen erhält.
| Was Ihnen auffällt | Warum der Mechanismus dies tut | Was als Nächstes zu versuchen |
|---|---|---|
| Gleicher Prompt, anderes Bild | Jeder Durchlauf beginnt mit neuem, zufälligem Rauschen und approximiert | Komposition und Blickwinkel benennen, dann neu generieren |
| Seltsame Hände, Gliedmaßen oder Zählungen | Fehler können sich über etwa 20 bis 50 Schritte summieren | Weniger Personen verwenden, die Pose vereinfachen und dann einen Bearbeitungsschritt durchführen |
| Kaputte oder zusätzliche Beschriftung | Text ist in Pixeln schwer ausgerichtet zu halten | Sehr kurze Wörter verwenden oder Schrift außerhalb des Modells hinzufügen |
| Mehr Details machten es schlimmer | Konkurrierende Konzepte reißen die Einbettung auseinander | Wählen Sie ein Motiv, klare Beziehungen und einen Stil |
| Generierung fühlt sich langsam an | Schritte laufen sequenziell ab, nicht als einzelner Pixelschreibvorgang | Planen Sie mehrere Versuche ein anstelle eines perfekten Durchlaufs |
Eine komprimierte latente Darstellung kann die Berechnung reduzieren, aber sie erzeugt auch eine Obergrenze für die Qualität, die durch den Autoencoder auferlegt wird. Wenn die Komprimierung etwas verliert, kann das spätere Entrauschen es nicht immer zurückbringen. Deshalb ist ein ansprechendes Bild der Beweis für ein erfolgreiches Ergebnis und nicht der Beweis dafür, dass das Modell jeden Prompt zuverlässig löst.
Destillation und Konsistenzmodellierung sind Entwicklungen, die man im Auge behalten sollte. Sie zielen darauf ab, die Generierung auf ein oder zwei Auswertungen statt vieler Diffusionsschritte zu reduzieren, was die Bilderstellung für mobile und hochvolumige Kreativ-Workflows reaktionsschneller machen könnte. Diese Richtung bedeutet nicht, dass jede aktuelle Bild-App bereits in ein oder zwei Schritten generiert.
Für Kreative besteht die praktische Reaktion darin, Komposition, Motivbeziehungen, Kamera oder Blickwinkel und Ausgabe-Einschränkungen anzugeben. Betrachten Sie dann ein fehlerhaftes Ergebnis als fehlgeschlagene Inferenz und nicht als Urteil über die Idee: Generieren Sie neu, wenn die Komposition nicht stimmt, oder bearbeiten Sie den Teil, der fehlgeschlagen ist. Wenn Sie Werkzeuge vergleichen, konzentrieren Sie sich darauf, welches Ihre wiederkehrende Aufgabe und Ihren Korrektur-Workflow bewältigt; dieseÜbersicht über Text-zu-Bild-Modellebietet einen weiteren Ausgangspunkt.
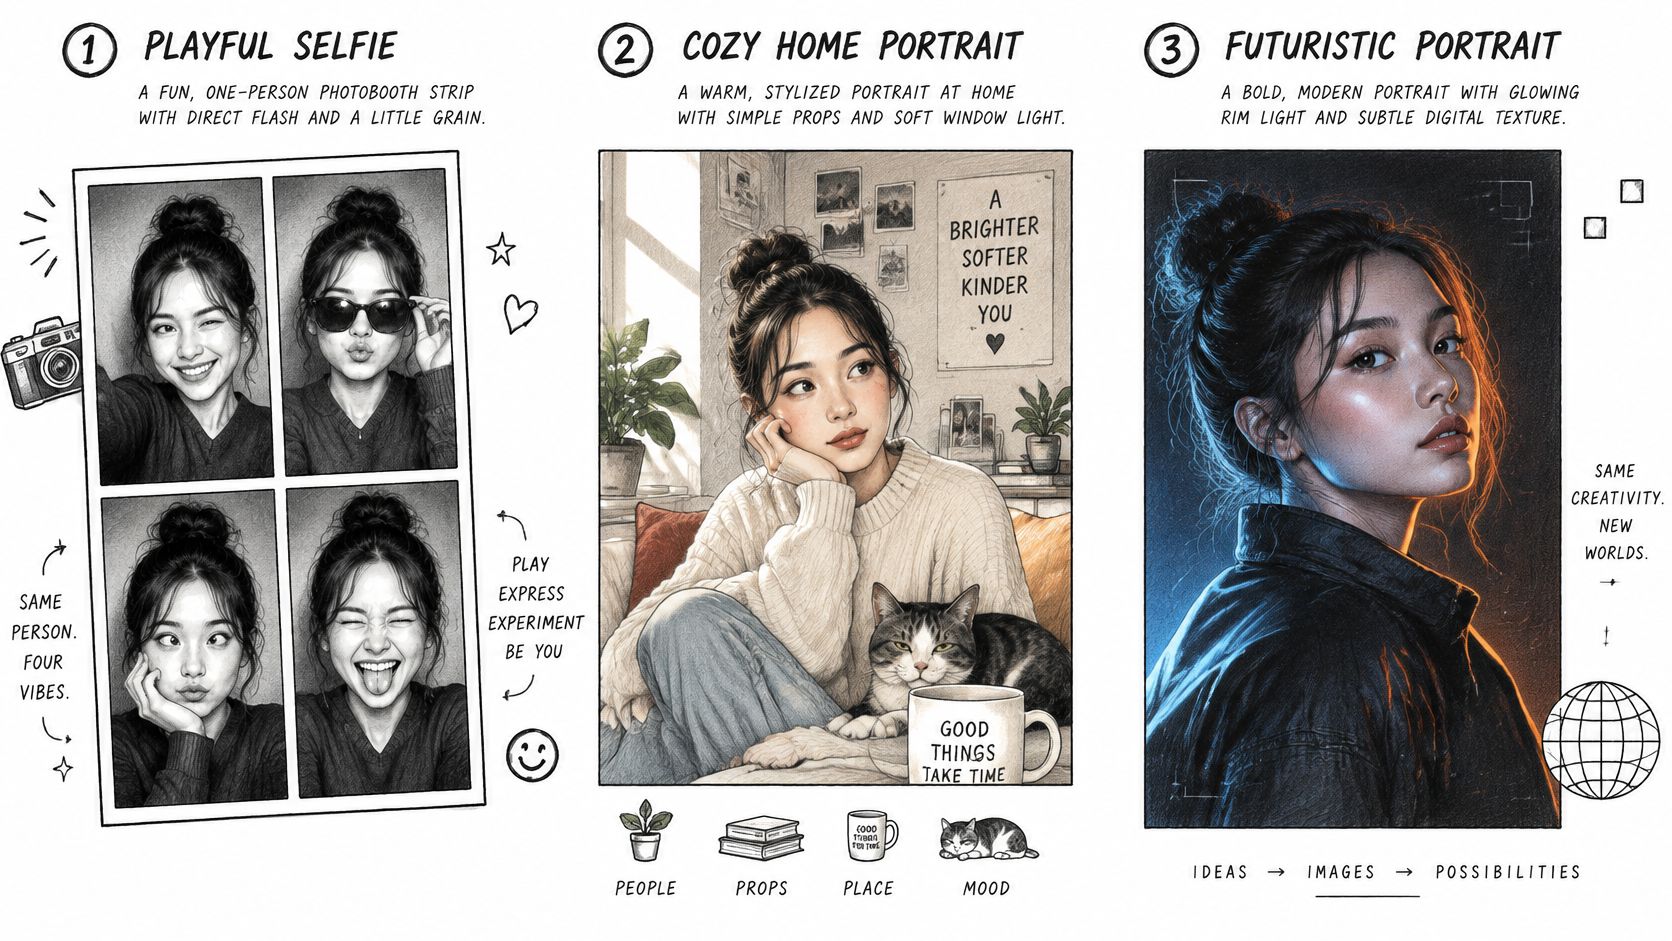
Dieselbe Gewohnheit beim Verfassen von Prompts kann für eine Selfie-Transformation, ein sportliches Porträt oder ein Charakterkonzept dienen. Geben Sie dem Modell in jedem Fall zuerst die strukturellen Anweisungen und verwenden Sie dann Details, die den beabsichtigten Look unterstützen. Hier sind drei Prompts, die Sie anpassen können.
Selfie im Photobooth-Stil:„Eine Person mit verspieltem Gesichtsausdruck, direktem Kamerablitz, Layout mit vier Bildstreifen, leichtes Filmkorn.“ Die Wörter „eine Person“ und „Layout mit vier Bildstreifen“ geben dem Modell das Motiv und die frühe Komposition vor, die es etablieren soll. „Direkter Kamerablitz“ definiert die Beleuchtung; „leichtes Filmkorn“ ist ein Oberflächendetail. Lassen Sie zusätzliche Stil-Labels weg, die mit dem Look des Bildstreifens konkurrieren.
Um die Art von Porträt-Transformationen zu sehen, die zu neuen Ideen anregen können, werfen Sie einen Blick auf das folgende Beispiel.
Sportliches Porträt:„Läufer mitten im Schritt auf einer Laufbahn, zielstrebige Körperhaltung, schlichte dunkle Aktivkleidung, Seitenlicht.“ „Läufer mitten im Schritt“ und „zielstrebige Körperhaltung“ helfen dabei, die Körperposition und die Gesamterscheinung zu bestimmen. Die Laufbahn und das Seitenlicht platzieren das Motiv in einer klaren Umgebung. Stapeln Sie nicht mehrere Kleidungsstile oder Stimmungen auf einen Prompt, der ohnehin eine lesbare Pose erfordert.
Charakter für ein Cover oder Merch:„Ein Fantasy-Charakter, waldgrüner Mantel und kupferfarbener Schal, schlichter cremefarbener Hintergrund, kein Text.“ Das Motiv und die Kleiderdetails geben dem Generator ein prägnantes visuelles Ziel; der schlichte Hintergrund lenkt die Aufmerksamkeit auf den Charakter. Das Weglassen des Titels ist Absicht. Fügen Sie akkurate Beschriftungen nachträglich hinzu, anstatt sich darauf zu verlassen, dass das Bildmodell einen Covertitel buchstabieren kann.
Für einen alltäglichen Workflow können Sie mit starryai von einem Text-Prompt oder Selfie aus starten, Bildvariationen generieren und „Bearbeiten“ verwenden, wenn eine Hand, ein Hintergrund oder ein Beschnitt nicht gelingt. Halten Sie das Motiv, das Layout und den Hintergrund im anfänglichen Prompt klar. Passen Sie dann nur das fehlgeschlagene Detail an, anstatt alles neu zu schreiben.
Ein Herkunftssignal kann zeigen, dass ein Bild von KI generiert oder bearbeitet wurde. Es begründet nicht, dass Sie die Erlaubnis haben, jedes Element zu verwenden, dass ein Marktplatz das Bild erlaubt oder dass sein Kontext der Wahrheit entspricht. Content Credentials und unsichtbare Wasserzeichen können die Historie eines Bildes aufzeichnen oder signalisieren, obwohl Zuschnitt, Komprimierung oder wesentliche Bearbeitungen ein Wasserzeichen schwer erkennbar machen können. Kein sichtbares Signal beweist nicht, dass ein Bild ein Foto ist.
Für Buchcover, Merchandise, Avatare und markenbezogene Posts speichern Sie, wie das Bild erstellt wurde, und überprüfen Sie es vor der Veröffentlichung:
Ein Label kann den Prozess eines Bildes erklären, aber Sie müssen dennoch beurteilen, was es darstellt und ob Sie berechtigt sind, seine Zutaten zu verwenden. Speichern Sie in starryai Ihren Prompt neben dem generierten Bild und generieren oder bearbeiten Sie dann fehlerhafte Anatomie oder Texte. Überprüfen Sie die finale Datei, bevor Sie sie posten oder verkaufen.
starryai bietet einen kostenlosen KI-Bildgenerator und eine Kreativ-Suite, um Text-Prompts, Selfies und Emojis in Visuals zu verwandeln. Probieren Sie einen klaren Prompt aus, vergleichen Sie die Ergebnisse undbesuchen Sie starryai, um mit dem Generierungs- und Bearbeitungs-Workflow zu experimentieren.


