

Geschrieben vonMo Kahnam
1. Juli 2026


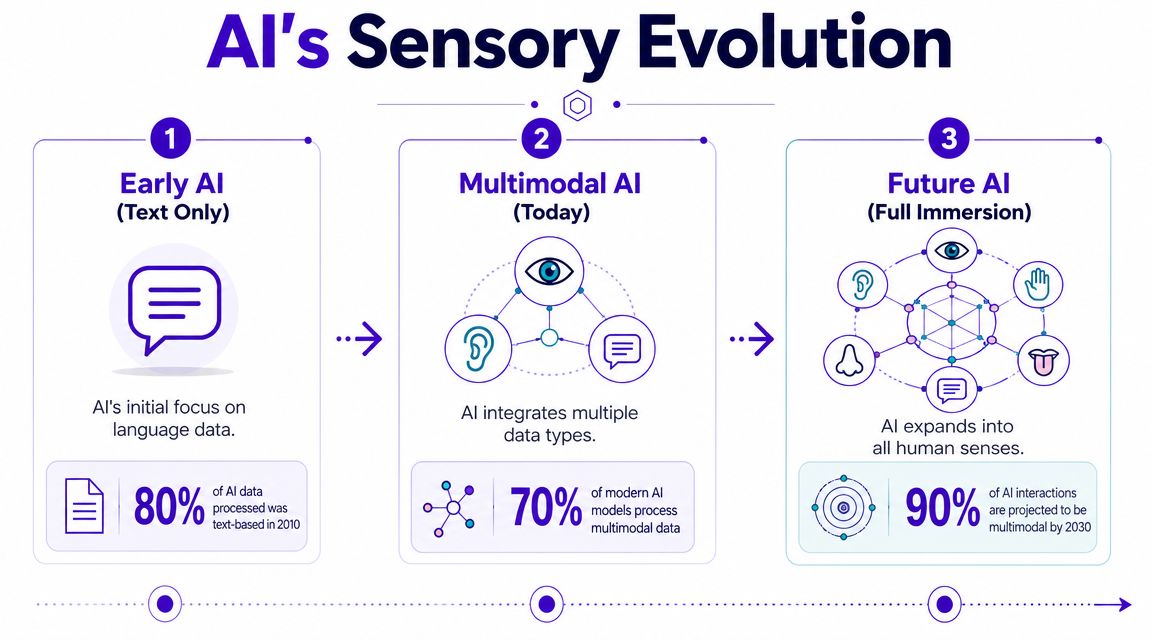
Multimodale KI ist eine Art von künstlicher Intelligenz, die Informationen aus mehreren Quellen gleichzeitig verstehen und verarbeiten kann, wie Text, Bilder und Ton – ganz ähnlich wie Menschen es tun. Sie ist bereits eine reale MarktKategorie, wobei eine Branchenschätzung den globalen Markt für multimodale KI auf1,6 Milliarden USD im Jahr 2024bewertet und bis 2034 einen Wert vonetwa 27 Milliarden USD prognostiziert.
Sie spüren wahrscheinlich bereits die Lücke, die dadurch geschlossen wird. Sie tippen einen Prompt ein, erhalten ein Bild, das nah dran ist, und wünschen sich dann, Sie könnten auch ein Referenzfoto hochladen, die gewünschte Stimmung beschreiben, vielleicht Sprachnotizen hinzufügen und das Tool dazu bringen, all das gemeinsam zu verstehen.
Das ist der Hauptgedanke hinter multimodaler KI. Sie betrachtet Kreativität nicht nur als reinen Text. Sie fängt an, eher wie ein Mitarbeiter zu arbeiten, der Ihre Worte lesen, sich Ihre Referenzen ansehen und die Teile zu einer einzigen Antwort zusammenfügen kann. Für Künstler, Content Creator, Indie-Autoren, Nebenberufler und Social-Media-Manager verändert das, was KI in einem täglichen Workflow leisten kann.
Viele ältere KI-Werkzeuge fühlten sich an wie die Zusammenarbeit mit jemandem, der nur Notizen lesen konnte, die unter einer Tür hindurchgeschoben wurden. Wenn Sie einen starken Prompt eintippten, konnten sie antworten. Aber wenn Sie ein Selfie zeigen, auf eine Farbpalette zeigen und sagen wollten „Mach, dass sich das wie ein verträumtes Fantasy-Poster anfühlt“, konnte das System diese Signale oft nicht gut kombinieren.
Deshalb istwas multimodale KI istfür Kreative wichtig. Es markiert einen Wandel von Systemen mit nur einer Eingabe hin zu Tools, die überText, Bilder, Audio und Videohinweg arbeiten können, anstatt jedes Format als eine eigene Welt zu behandeln.
Creators rarely work in one format at a time. A TikTok concept might begin as a caption idea, turn into a reference board, become a voiceover, then end as a short video. A book cover might start with character notes, then mood images, then typography experiments.
Multimodal AI fits that reality better than older tools because it can handle richer context.
If you want tostreamline video production with TTS, multimodal thinking starts to become effective. You're no longer dealing with isolated tasks. You're combining media types into one creative system.
Practical rule:The more your idea depends on relationships between words, visuals, and sound, the more likely multimodal AI will feel useful rather than gimmicky.
The commercial side reflects that shift too. One industry estimate values the global multimodal AI market at1,6 Milliarden USD im Jahr 2024and projects it will reachetwa 27 Milliarden USD prognostiziert, implying a32.7% CAGRaccording tomultimodal AI market analysis from Global Market Insights.
If you're already working with AI visuals, it helps to understand the image side first, especially in guides likewhat an AI image is. Multimodal AI builds on that foundation, then adds more senses to the conversation.
The simplest way to understand multimodal AI is to compare it with your own perception. When you meet a dog, you don't process only one signal. You see its shape, hear the bark, maybe read the name on a tag, and your brain blends those cues into one understanding.
AunimodalAI system works more like a single-sense specialist. It may only read text, or only classify images. Amultimodalsystem can connect several kinds of input and reason across them.
Readers often get tripped up here. Multimodal does not solely mean “the app accepts uploads.” Plenty of tools let you attach an image and paste text, but they don't necessarily understand the relationship between them.
A multimodal system does something deeper. It can look at a photo, interpret written or spoken instructions about that photo, and generate a response that reflects both inputs together.
That shift became a defining milestone in the field. Major research and industry descriptions frame multimodal AI around models that jointly processText, Bilder, Audio und Video, which is what moved AI from narrow specialization toward systems that more closely resemble human perception, as explained inTileDB's guide to multimodal AI.
| Type | What it handles | Where it feels limited |
|---|---|---|
| Unimodal AI | One data type at a time | It can miss context that lives in another format |
| Multimodal AI | Multiple data types together | It's more complex, but can produce richer responses |
For a creator, that difference is practical.
Multimodale KI fühlt sich dann nützlich an, wenn die Beziehung zwischen den Eingaben wichtiger ist als jede einzelne Eingabe für sich.
Die kreative Ausrichtung ist meist vielschichtig. Vielleicht möchten Sie „dieses Gesicht“, „diese malerische Stimmung“, „diesen Bildunterschriften-Ton“ und „diese Soundtrack-Energie“. Menschliche Mitarbeiter verstehen solche Bündel ganz natürlich. Multimodale KI versucht, in Software etwas Ähnliches zu tun.
Aus diesem Grund taucht sie in breiteren Märkten in Bereichen wie Gesundheitsdiagnostik, autonome Fahrzeuge, Moderation von Inhalten, Kundenservice und Robotik auf. Für Kreative ist die Quintessenz einfacher. KI wird immer besser im Umgang mit Kontext, und der Kontext ist der Ort, an dem der Stil zu Hause ist.
Unter der Haube ist multimodale KI weniger Magie als vielmehr Choreografie. Man kann sie sich wie ein kleines Team von Übersetzern vorstellen, die hinter den Kulissen arbeiten.
Ein Übersetzer versteht Text. Ein anderer versteht Bilder. Ein weiterer kümmert sich um Audio. Jeder Spezialist nimmt eine andere Art von Roheingabe und wandelt sie in eine Form um, die das System vergleichen und kombinieren kann.
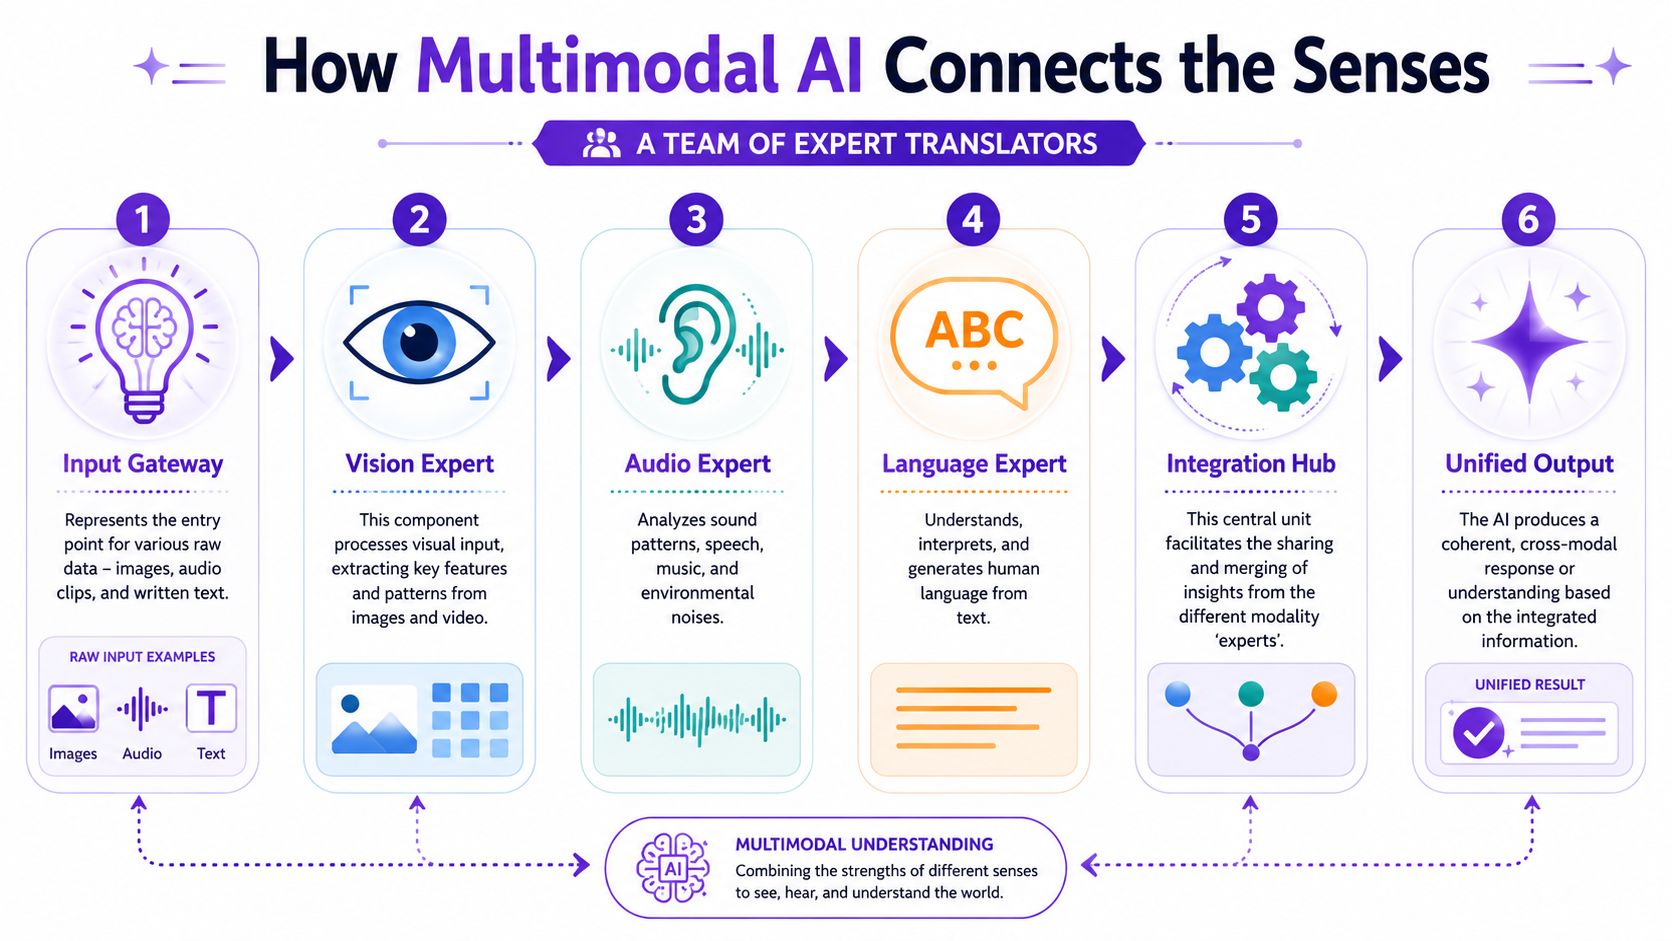
Eine gängige multimodale Architektur umfasst einEingabemodul, einFusionsmodulund einAusgabemodul. Technisch ausgedrückt bestehen diese Systeme in der Regel ausmodalitätsspezifischen Encodernsowie einerFusionsschicht, die Text, Bilder, Audio oder Video in einen gemeinsamen Einbettungsraum abbildet, wie in der Erläuterung zu multimodaler KI von McKinsey beschrieben.
Hier ist die Version in einfachem Deutsch:
Eingabe
Verschiedene Encoder verarbeiten verschiedene Medien. Text wird tokenisiert. Bilder werden in der Größe angepasst und codiert. Audio wird oft in Merkmale umgewandelt, die das Modell interpretieren kann.
Fusion
Dies ist der wesentliche Zwischenschritt. Das System bildet diese unterschiedlichen Eingaben in einem gemeinsamen Raum ab, um die Bedeutung formatübergreifend vergleichen zu können.
Ausgabe
Ein nachgeschaltetes Modell liefert die Antwort. Diese Antwort kann Text, ein Bild, Anweisungen, eine Klassifizierung oder ein anderes generiertes Ergebnis sein.
Ohne Fusion wäre multimodale KI nur ein Haufen separater Spezialisten. Die Fusionsschicht sorgt dafür, dass das System Ihren Prompt mit Ihrem Bild verbinden kann, anstatt sie als zusammenhanglose Dateien zu behandeln.
Das ist es, was modalitätsübergreifendes Schließen (Cross-Modal Reasoning) ermöglicht. Ein Modell kann ein Bild und einen Text-Prompt zusammen verwenden, um eine Frage zu beantworten oder eine Antwort zu generieren, die beides widerspiegelt.
Betrachten Sie die Fusionsschicht als den Besprechungstisch, an dem jeder Spezialist seine Notizen in derselben Sprache einbringt.
Diese Idee des gemeinsamen Raums erklärt auch, warum die Technologie flexible Ausgaben unterstützen kann. Sobald verschiedene Modalitäten in dieselbe hochdimensionale Repräsentation eingebettet sind, kann das Modell dieBeliebig-zu-Beliebig-Generierung (Any-to-Any Generation)unterstützen, was bedeutet, dass es eine oder mehrere Modalitäten aufnehmen und eine andere Modalität als Ausgabe erzeugen kann, so Milvus zu multimodalen Rechenanforderungen.
Wenn Sie ein Porträt hochladen und hinzufügen „Mach daraus ein Neon-Cyberpunk-Poster“, stapelt das System nicht einfach eine Anweisung auf eine Datei. Es versucht, die visuellen Merkmale des Porträts mit der semantischen Bedeutung des Prompts abzugleichen, bevor das Ergebnis generiert wird.
Aus diesem Grund wirken manche Ergebnisse unheimlich treffend, während andere abdriften. Das Modell muss mehrere Signale korrekt aufeinander abstimmen.
Wenn Sie eine breitere Grundlage für das Ökosystem rund um diese Systeme wünschen, istGenerative KI-Modelle erklärteine nützliche Lektüre zur Ergänzung. Generative Modelle erzeugen die Ausgabe. Multimodales Design hilft ihnen, eine größere Mischung von Eingaben zu verstehen, bevor sie dies tun.
Der schnellste Weg, multimodale KI zu verstehen, besteht darin, sie für etwas zu nutzen, das Ihnen ohnehin am Herzen liegt. Für Kreative bedeutet das meist Identität, Stil, Geschwindigkeit oder Storytelling.
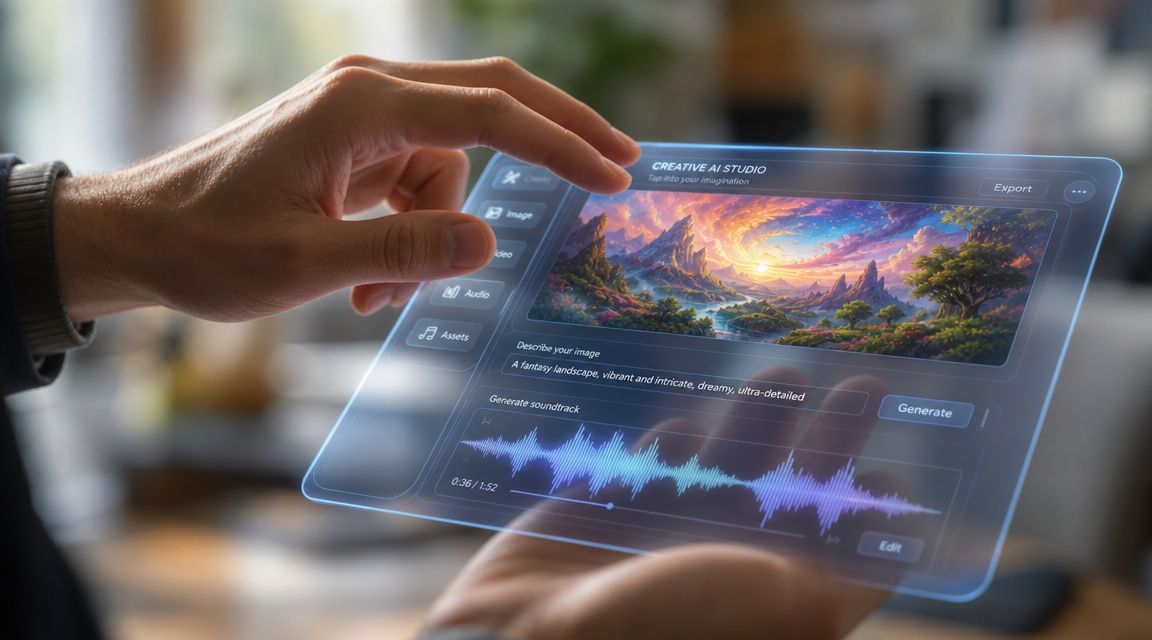
Dies ist einer der klarsten Anwendungsfälle für Kreative. Sie beginnen mit einem Bild von sich selbst und fügen dann Text hinzu, der die Transformation steuert.
Ein Prompt wie „Verwandle dieses Porträt in einen mondbeschienenen Elfen-Ranger mit silberner Rüstung und malerischer Beleuchtung“ gibt dem Modell zwei Dinge gleichzeitig: Identitätshinweise aus dem Foto und Stilhinweise aus der Sprache. Das Ergebnis kann als Avatar, Profilauffrischung, Poster-Konzept oder Fandom-Kunst dienen.
Für diese Art von Workflow sind Tools wiestarryai Text-zu-Bildrelevant, da sie die Prompt-basierte Bilderstellung unterstützen und für Kreative geeignet sind, die visuelle Ergebnisse ohne technisches Setup wünschen.
Manchmal lautet das Ziel nicht „Lass mich anders aussehen“. Sondern „Lass diese Idee mehr nach jener Ästhetik aussehen“.
Das kann bedeuten, ein Stimmungsbild hochzuladen und einen Prompt zu schreiben, der Ton, Palette oder Genre vorgibt. Ein Kreativer, der Kunstdrucke auf Etsy verkauft, könnte dies nutzen, um Richtungen für Cottagecore-, Retro-Sci-Fi- oder Dark-Academia-Kollektionen zu testen. Ein Indie-Autor könnte dasselbe Muster für Charakterkonzepte oder Cover-Erkundungen verwenden.
Wenn Sie im Verlagswesen tätig sind, ist dieser Leitfaden zurAuswahl von KI-Generatoren für Self-Publishernützlich, da er die Tool-Auswahl auf tatsächliche Cover- und Konzept-Workflows ausrichtet, anstatt auf abstrakten KI-Hype.
Multimodale KI generiert nicht nur. Sie kann auch interpretieren.
Sie können ein Bild einspeisen und Folgendes anfordern:
Das ist hilfreich, wenn man Schwierigkeiten hat, eine Idee zu benennen, zu veröffentlichen oder zu verfeinern, die man zwar vor sich sieht, aber noch nicht in Worte gefasst hat.
Eine kurze Demo macht dies greifbarer:
Für Short-Form-Video-Creator ist der interessante Sprung die Kombination aus Skript, Visuals und Stimme. Ein Konzept kann als geschriebene Hook beginnen, zu generiertem Bildmaterial werden und dann Narration oder Sounddesign erhalten.
Das bedeutet nicht, dass jeder Creator einen kompletten Produktions-Stack benötigt. Es bedeutet, dass die Mauer zwischen „Schreiben“, „Design“ und „Editing“ durchlässiger wird. Dieselbe Kernidee kann sich nun flüssiger über Formate hinweg bewegen, weshalb multimodale KI besonders natürlich für TikTok, Reels, Trailer und visuelles Storytelling wirkt.
Ein guter kreativer Prompt muss nicht länger die gesamte Arbeit alleine tragen. Referenzmedien können nun die Last mitteilen.
Multimodale KI öffnet neue kreative Türen, erhöht aber auch den Aufwand, um die Dinge richtig zu machen. Diese Systeme sind anspruchsvoller als Modelle mit nur einer Eingabe, da sie mehrere Informationsströme verarbeiten und kohärent aufeinander abstimmen müssen.
Verglichen mit unimodalen Systemen erfordern multimodale Modelleerheblich mehr Rechenleistung und Speicher, da sie mehrere Encoder verarbeiten und größere Architekturen aufrechterhalten müssen. Das erhöht die Latenz und steigert den Trainings- und Inferenzbedarf, wie in der zuvor verlinkten Milvus-Referenz angemerkt.
Wenn ein System Bild, Text, Audio und Video kombinieren kann, kann es auch dazu verwendet werden, irreführende Inhalte überzeugender zu gestalten. Dazu gehören gefälschte Visuals, manipulierte Sprachinhalte oder Mixed-Media-Beiträge, die authentisch wirken sollen.
Bias ist ein weiteres Anliegen. Wenn das Trainingsmaterial verzerrte Darstellungen enthält, kann das Modell diese Muster über mehrere Formate hinweg gleichzeitig statt nur in einem Kanal weitertragen.
Eine fundierte Art, multimodale KI zu nutzen, ist einfach:
Creator müssen die Technologie nicht fürchten. Sie müssen sie jedoch mit Urteilsvermögen einsetzen.
Nein.Generative KIbeschreibt Systeme, die Ausgaben wie Bilder, Text, Audio oder Video erzeugen.Multimodal AIbeschreibt Systeme, die mehrere Arten von Eingaben verstehen oder damit arbeiten können. Einige Tools sind beides. Einige sind nur eines.
Eine Text-zu-Bild-App ist möglicherweise generativ. Ein System, das ein Bild analysiert, Ihren Prompt liest und dann ein Ergebnis generiert, ist sowohl generativ als auch multimodal.
Ja. Sie müssen keine Modelle entwickeln oder die Mathematik des maschinellen Lernens verstehen, um zu beginnen. Die meisten Anfänger können das Konzept erlernen, indem sie einfache Workflows ausprobieren, wie das Hochladen eines Fotos, das Hinzufügen eines Prompts und das Vergleichen von Ergebnissen.
Beginnen Sie mit kleinen Experimenten:
Es verringert die Lücke zwischen der Idee in Ihrem Kopf und den Materialien, die Sie bereits haben. Anstatt alles in Text zu zwingen, können Sie Referenzen, Sprache und manchmal auch Ton oder Bewegung kombinieren.
Das ist besonders nützlich für Creator, die zuerst visuell denken oder plattformübergreifend arbeiten, wo aus einem einzigen Konzept ein Beitrag, ein Thumbnail, ein Cover, ein Voiceover oder ein kurzes Video werden muss.
Die wahrscheinliche Richtung ist eine natürlichere Interaktion. Creator werden zunehmend mit Tools arbeiten, die gemischte Eingaben in einem einzigen Ablauf akzeptieren und dann Ausgaben liefern, die kontextbewusster wirken.
Die wichtigste Veränderung ist nicht nur bessere Qualität. Es ist eine bessere Zusammenarbeit zwischen Ihrer Absicht und den Medien, die Sie bereitstellen.
Wenn Sie diese Art von Workflow selbst ausprobieren möchten,starryaiist eine Option, um Prompts, Selfies und visuelle Ideen ohne technische Vorkenntnisse in KI-generierte Bilder umzuwandeln.


