

Escrito porMo Kahnel
26 de julio de 2026


Probablemente estés en el punto en el que tus indicaciones son decentes, tus ideas son sólidas y los resultados todavía se sienten un poco demasiado genéricos. Tal vez el héroe de tu novela independiente sigue luciendo como un personaje de fantasía genérico, o tus maquetas de Etsy convergen hacia la misma estética insípida sin importar cuán cuidadosamente redactes la indicación. Ese suele ser el momento en que el entrenamiento de modelos de IA personalizados deja de parecer una curiosidad técnica y se convierte en una decisión creativa que debes acertar.
Un autor independiente quiere que un personaje recurrente se vea igual en una portada, una imagen de avance y una tarjeta de personaje. Un vendedor de Etsy quiere una línea de mercancía que no parezca la misma estética de internet que todos los demás están usando. En ambos casos, la pregunta no es "¿puede ayudar la IA?", sino "¿qué camino se adapta al trabajo?".
Hay cuatro opciones reales.Los modelos listos para usarson el punto de partida más rápido y económico, y son suficientes cuando el resultado no necesita una identidad estrictamente controlada.La personalización basada en recuperaciónfunciona cuando el asistente necesita responder a partir de archivos aprobados, sitios web o fuentes en la nube en lugar de cambiar el modelo en sí, lo que a menudo es el significado predeterminado de "entrenar con tus datos" en entornos empresarialesentrenamiento y recuperación de GPT personalizados. El ajuste fino (fine-tuning)ajusta un modelo preentrenado existente para una voz de marca, un estilo visual o un patrón específico de una tarea.Entrenar desde ceroes el camino más pesado, y la mayoría de los creadores no lo necesitan.
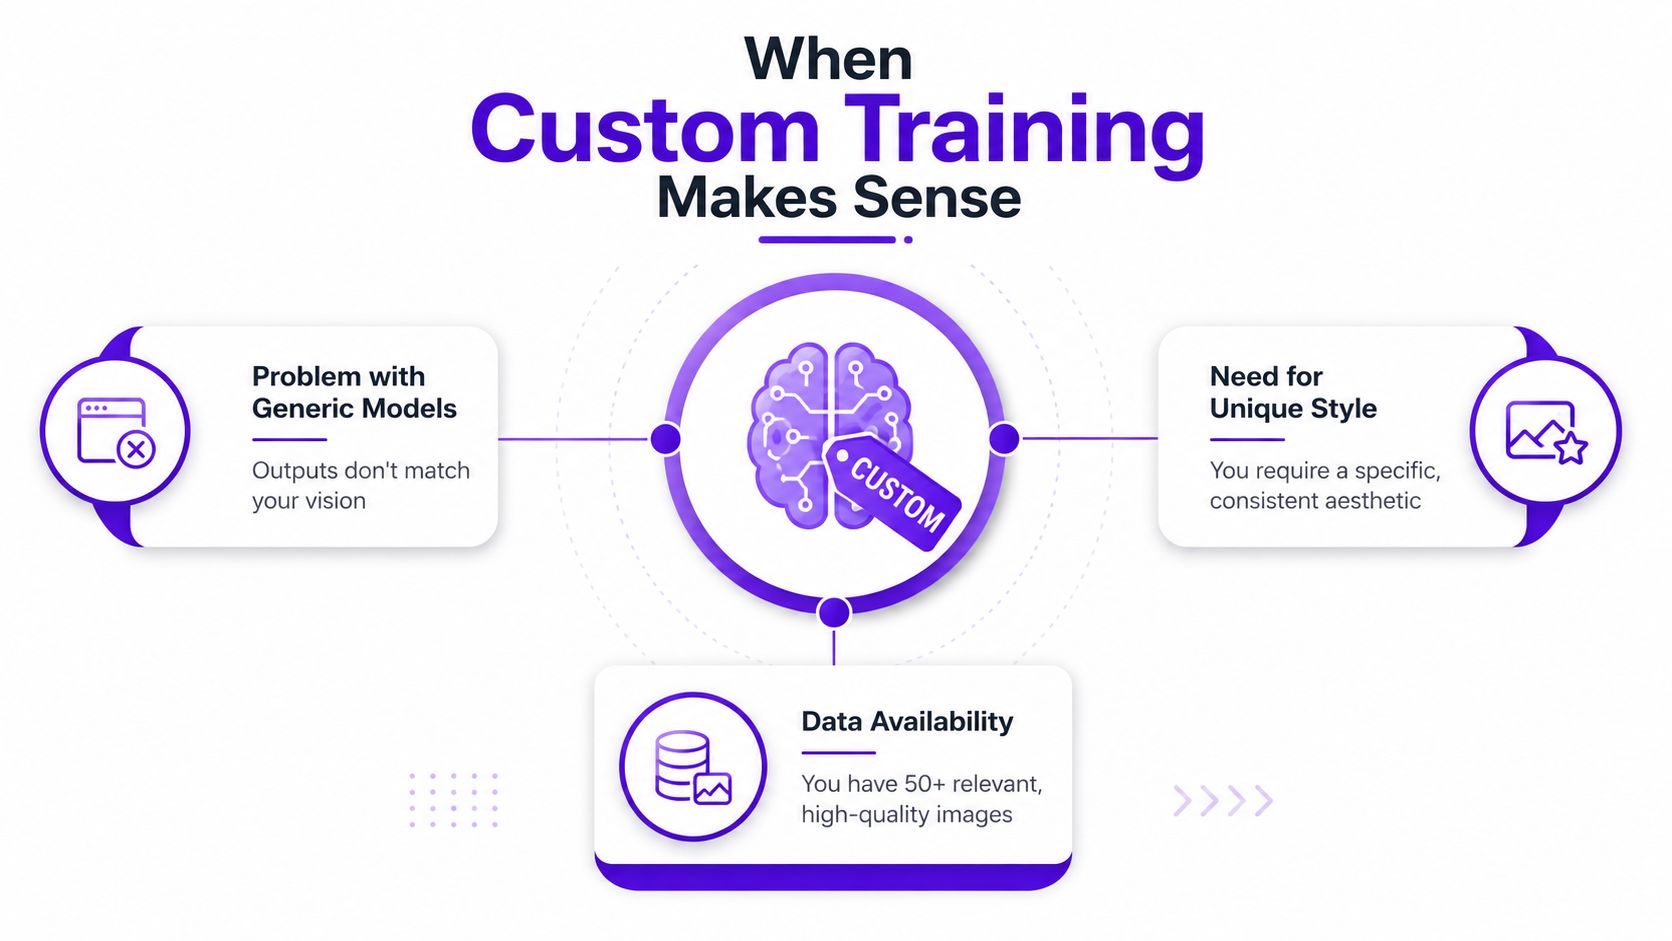
Regla práctica:entrena de forma personalizada solo cuando el resultado genérico siga fallando en tu dominio, tu volumen mensual de inferencia sea lo suficientemente alto como para justificar el trabajo extra, o tus requisitos de latencia y consistencia de marca sean estrictos.
Un marcador histórico útil esBERT en 2018, que ayudó a normalizar el ajuste fino específico de tareas sobre modelos de cimientos preentrenados. El trabajo original de BERT de Google informóresultados de última generación en 11 tareas de PNL (NLP), incluido un salto de90.9% a 94.9%en laprueba comparativa (benchmark) GLUEen ese momento, mostrando cómo los modelos adaptados podían superar a los enfoques genéricos cuando se ajustaban a una tarea específicaResumen de Oracle sobre el entrenamiento de modelos de inteligencia artificial. Ese mismo cambio es la razón por la cual los equipos pequeños ahora pueden personalizar un modelo en lugar de construir uno desde cero.
Una rápida verificación mental ayuda:
El conjunto de datos suele decidir si tu modelo se siente pulido o extrañamente desubicado. Eso es especialmente cierto para los flujos de trabajo de creadores, donde una imagen borrosa, un título mal etiquetado o una referencia duplicada pueden empujar el resultado hacia la uniformidad en lugar del estilo.
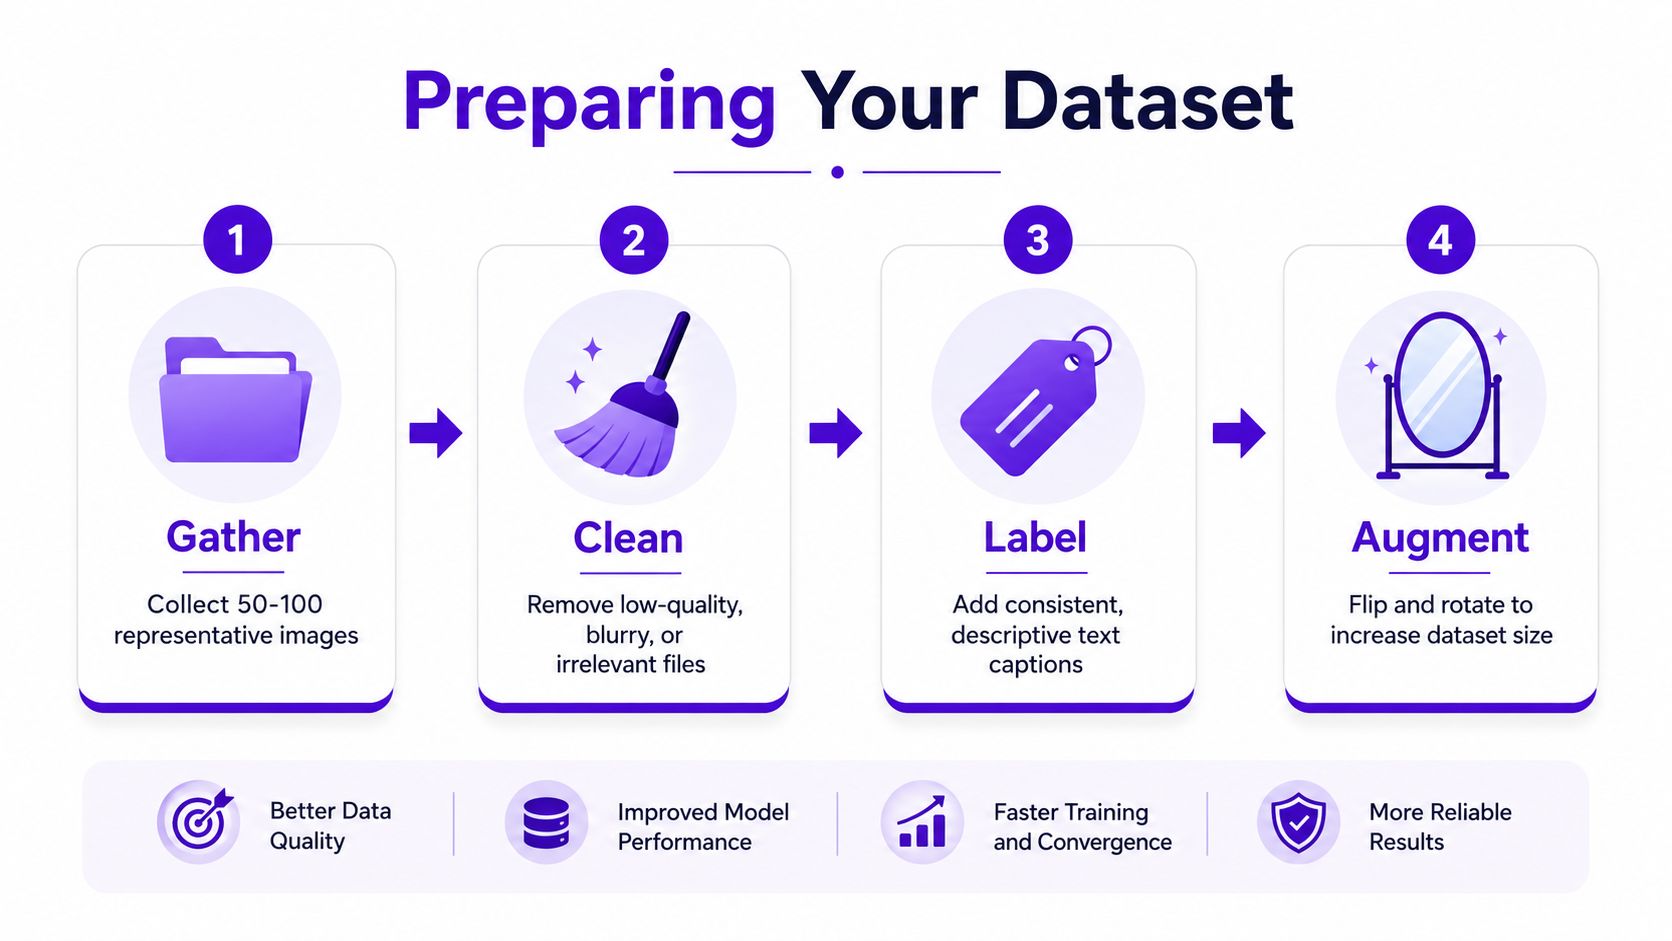
Comienza reuniendo solo las imágenes o el texto que pertenecen al modelo. Un conjunto enfocado supera a una pila amplia de material de referencia mixto, porque el modelo aprende el patrón que le muestras con más frecuencia. Para el trabajo con imágenes de creadores, un punto de partida práctico es12 a 20 imágenescon subtítulos, y el material de fuente también recomienda unmínimo de 10 imágenescuando se incluyen subtítulosconfiguración de entrenamiento de imágenes.
A continuación, limpia rigurosamente el conjunto. Elimina duplicados, archivos de baja calidad, valores atípicos irrelevantes y subtítulos rotos. La razón es simple: el modelo no puede separar lo "importante" de lo "accidental" a menos que tus datos ya hagan ese trabajo por él. La estructura más clara sigue siendo la división clásica:70 a 80%para entrenamiento,10 a 15%para validación, y10 a 15%para pruebasguía de división de conjuntos de datos.
Tu conjunto de validación importa más de lo que muchos principiantes piensan. La pérdida de entrenamiento puede seguir disminuyendo mientras que la pérdida de validación comienza a subir, y esa brecha es la primera señal de sobreajuste. Si el modelo está memorizando tu conjunto de datos en lugar de aprender el estilo, por lo general verás muestras de entrenamiento excelentes y salidas nuevas decepcionantes.
La parte más operativa es el sesgo y la cobertura. Un modelo de creador debe incluir variación en postura, iluminación, ángulo, fondo y encuadre para que el resultado no se quede atascado en un solo aspecto estrecho. Una referencia de flujo de trabajo interno que muchos equipos usan para la organización de conjuntos de datos es laguía de gestión de colecciones, porque el problema a menudo se trata menos de generar imágenes y más de mantener la biblioteca de origen lo suficientemente ordenada como para entrenar a partir de ella.
Mantén una nota junto a cada conjunto de datos: de dónde vino, qué eliminaste y por qué conservaste los ejemplos finales. Ese registro ahorra horas más tarde cuando un modelo se comporta de manera extraña y necesitas rastrear la causa.
Los creadores por lo general no necesitan el método más pesado posible. Necesitan el método que preserve el aspecto que les importa sin devorar tiempo, capacidad de cómputo o su cordura. Es por eso que la elección correcta depende de si estás intentando enseñarle al modelo un comportamiento completo, un estilo ligero o simplemente una palabra desencadenante para un concepto visual.
| Método | Datos necesarios | Tiempo de entrenamiento | Ideal para |
|---|---|---|---|
| Ajuste fino | Ejemplos más curados, mayor cobertura | Más largo | Voz de marca, especialización en tareas, cambios de comportamiento más profundos |
| LoRA | Conjunto de datos moderado y enfocado | Más corto | Personajes, estilos, visuales de creadores, iteraciones rápidas |
| Inversión textual | Conjunto de conceptos pequeño | Más corto | Nuevos tokens, pistas de estilo simples, activadores visuales estrechos |
El ajuste fino (fine-tuning)cambia una mayor parte del comportamiento del modelo, por lo que es la opción más pesada cuando necesitas una adaptación más profunda. Es útil cuando el modelo subyacente sigue perdiendo el dominio, pero también exige más de tus datos y tu paciencia. Un buen punto de partida para entender conceptualmente los flujos de trabajo de estilo de difusión es el explicador más amplio sobreFundamentos del entrenamiento de Stable Diffusion, porque muchos creadores de imágenes conocen estos métodos por primera vez dentro de ese ecosistema.
LoRAes la opción por la que se inclinan muchos creadores. Es más ligera, más rápida y más fácil de iterar cuando estás entrenando la cara de un personaje, un avatar recurrente o una estética de portada distintiva. Por lo general, te da suficiente control para fijar un estilo sin forzar una reescritura completa del modelo.
La inversión textuales el enfoque más suave. Funciona mejor cuando solo necesitas un token que invoque de manera fiable una idea visual específica. Si tu objetivo es «hacer que este se parezca a mi mascota dragón original», eso puede ser suficiente. Si tu objetivo es «hacer que el modelo entienda todo mi sistema de marca», normalmente no lo es.
Si el objetivo es un personaje repetible, empieza con el método más ligero que te lleve a él. Saltar directamente al ajuste fino completo suele añadir complejidad antes de añadir calidad.
Una regla de decisión simple funciona bien. Eligela inversión textualpara un concepto limitado,LoRApara la mayoría del trabajo de estilo o personajes orientado al creador, yel ajuste finocuando necesites un control de comportamiento más amplio y ya tengas la disciplina de conjunto de datos necesaria para respaldarlo.
Una primera ronda de entrenamiento es menos dramática de lo que la gente espera. No estás «lanzando un modelo mágico», estás probando si tu conjunto de datos, subtítulos y ajustes pueden mover el resultado en la dirección correcta sin colapsar la consistencia del estilo.
Empieza con un modelo base que ya se parezca a tu caso de uso objetivo. Para un personaje de una serie de libros de fantasía, eso suele significar una base visualmente coherente en lugar de la más general disponible. Establece una tasa de aprendizaje conservativa para que el modelo no pase por alto el aspecto que intentas enseñarle. Si es demasiado agresiva, los resultados a menudo se vuelven frágiles o se sobreajustan rápidamente.
Usa puntos de control (checkpoints) después de cada época. Eso te da un punto de reversión cuando el modelo empieza a desviarse y hace que la comparación lado a lado sea mucho más fácil. El flujo de trabajo práctico descrito en el material de origen también recomiendala validación basada en cortesy ablaciones, lo que significa comprobar pequeños subconjuntos de imágenes o subtítulos para ver qué componente está ayudandoguía de flujo de trabajo de entrenamiento.
Un bucle simple al estilo de un creador se ve así:
El aumento simple ayuda, pero no debe apoderarse de la identidad del conjunto. Las inversiones, los recortes modestos y los ajustes de color ligeros pueden mejorar la fuerza. La distorsión pesada suele perjudicar la fidelidad del estilo, especialmente cuando el objetivo del entrenamiento es una cara reconocible, un atuendo o un aspecto de marca.
Si el modelo se ve muy bien en los ejemplos de entrenamiento, pero comienza a aplanar caras o a repetir artefactos de fondo en nuevos 'prompts', detén la ejecución e inspecciona los subtítulos antes de añadir más épocas.
Para una primera ejecución, la pregunta más útil no es «¿se entrenó?», sino «¿mejoró el tipo de resultado que necesito?». Esa es la diferencia entre un trabajo técnicamente exitoso y una herramienta de creación útil.
El entrenamiento personalizado se vuelve costoso cuando la gente se salta la etapa de planificación. Un creador no necesita un equipo financiero, pero sí necesita una idea aproximada de cuándo una configuración personalizada deja de ser un experimento divertido y pasa a ser una decisión de infraestructura recurrente.
Una guía estima que el entrenamiento personalizado se vuelve económicamente atractivo por encima de aproximadamente5 a 10 millones de llamadas al mes, o cuando la latencia necesita mantenerse por debajo de50 ms guía de entrenamiento de modelos personalizados. Para la mayoría de los creadores, eso está muy por más allá de un flujo de trabajo típico de portada de libro o avatar. Una API alojada o un flujo de trabajo personalizado ligero dentro de starryai suele ser mucho más fácil de justificar a menor escala.
Una forma práctica de pensar en el gasto es por nivel:
| Nivel de entrenamiento | Sensación de cómputo típica | Resultado esperado | Ajuste para creadores |
|---|---|---|---|
| Ligero | Una ejecución corta con un conjunto de datos reducido | Alineación de estilo o concepto | Avatares, conceptos de mascotas, gráficos de mercancía simples |
| Medio | Más iteración y comparación de puntos de control | Aspecto de marca o personaje más consistente | Portadas de libros independientes, visuales de productos recurrentes |
| Pesado | Muchos ciclos de experimentación y un ajuste más preciso | Control de modelos más profundo | Equipos con estrictas necesidades de latencia, dominio o escala |
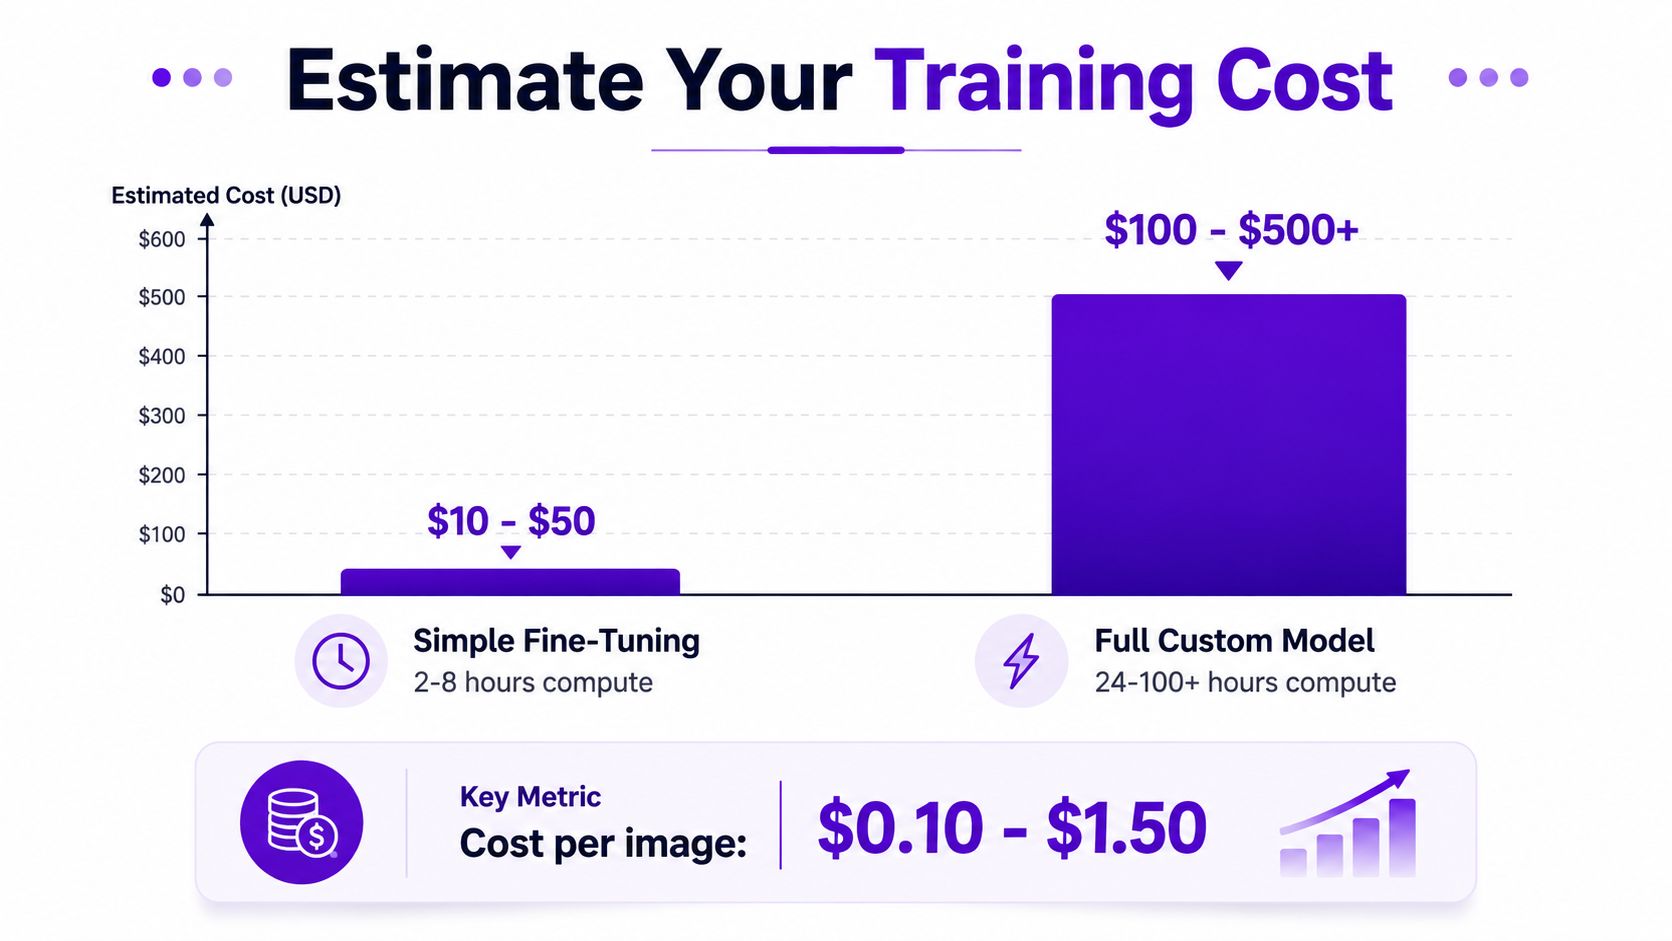
El material de origen también señala uncosto práctico por imagen de $0.10 a $1.50en el contexto de entrenamiento que se muestra en su gráfico degráfico de estimación de costos. Esa no es una fórmula de factura universal, pero es un ancla de planificación útil cuando estás decidiendo si entrenar un concepto o cinco.
Si estás experimentando en casa, el entrenamiento local en una GPU de consumo puede ser suficiente para pruebas pequeñas. Las plataformas alojadas son mejores cuando deseas un tiempo de configuración más corto y menos dolores de cabeza con el entorno. La pregunta no es "¿qué es lo más barato en teoría?", sino "¿qué me lleva a un resultado utilizable sin quemar una semana en la configuración?".
Presupuesta para la iteración, no solo para la primera ejecución. La mayoría de los modelos útiles llegan después de comparar algunas ejecuciones más pequeñas en lugar de apostarlo todo a una sola pasada gigante.
Un modelo puede verse genial y aun así ser inutilizable si los datos de entrenamiento se recopilaron sin cuidado. Esa es la parte que muchos creadores subestiman, especialmente cuando planean vender impresiones, portadas, paquetes de avatares o mercancía basada en el resultado.
La regla clara es respetar losderechos de autor, los términos de servicioy lasregulaciones de privacidad de datosal recopilar contenido web. La guía de CIO también recomienda mantener registros detallados de las fuentes y el preprocesamiento, junto con una validación rigurosa, desduplicación, limpieza y auditorías regulares para reducir el sesgoCIO sobre la gobernanza de datos de entrenamiento. Esos no son puntos de ética abstractos, son controles operativos.
También debes separar la licencia del modelo base de los derechos en torno a tu resultado entrenado. Un modelo afinado no hereda automáticamente todos los permisos comerciales asociados al modelo base, y los negocios de creadores a menudo salen perjudicados al asumir lo contrario. Si no estás seguro de lo que permite una plataforma, debes consultar lostérminos de licencia de starryaiantes de enviar trabajo pagado.
Para rostros y personajes de fans, el consentimiento importa. Si tu modelo está aprendiendo a reconocer a una persona, o si estás entrenando alrededor del diseño de un personaje protegido de otra persona, debes tratar eso como una cuestión de derechos, no solo como una elección estética. Eso es especialmente importante cuando el resultado está destinado a la venta.
Las comprobaciones de sesgo también son prácticas. Busca sesgos sistemáticos en género, edad, tono de piel, tipo de cuerpo o señales culturales en tus resultados. Si un grupo sigue siendo enmarcado de la misma manera, el conjunto de datos probablemente le esté diciendo al modelo que haga eso, incluso si no era tu intención.
Una lista de verificación rápida de derechos ayuda:
Para una perspectiva de políticas más amplia, las mismas preocupaciones de equidad aparecen en otros sistemas de IA también, incluyendo laequidad en la contratación impulsada por IA. La categoría es diferente, pero la lección es la misma: si los datos están sesgados, el resultado también lo estará.
El entrenamiento es solo la mitad del trabajo. Un modelo que vive solo en un cuaderno o en una ejecución de entrenamiento no ayuda a un autor, vendedor o creador social a enviar nada.
La evaluación debe comenzar de manera visual. Compara los resultados uno al lado del otro, usa barridos de avisos (prompt sweeps) y pregunta a algunos usuarios reales qué resultados se sienten más cercanos al aspecto deseado. Para los proyectos de creadores, ese tipo de revisión detecta errores que las métricas numéricas pueden pasar por alto, especialmente cuando el resultado necesita sentirse fiel a la marca en lugar de simplemente técnicamente válido.
Después de eso, optimiza para la forma en que se utilizará el modelo. Lacuantizaciónpuede reducir el tamaño del archivo y ayudar con los límites de memoria. Ladestilaciónpuede acelerar la inferencia. La ingeniería de avisos (prompt engineering) sigue importando también, porque un modelo bien entrenado puede tener un rendimiento inferior si el aviso ignora la forma en que fue condicionado.
Una secuencia de implementación que funciona en la práctica se ve así:
Los flujos de trabajo de los creadores a menudo incluyen avatares personalizados, portadas de libros y elementos visuales para redes sociales, por lo que una plataforma que ya admita esas tareas puede ahorrar tiempo. starryai ofreceEntrenamiento de Estilos, lo que permite a los usuarios cargarde 5 a 60 imágenesde un estilo, objeto o estética coherente para entrenar un modelo de estilo personalizado. Eso la convierte en una opción práctica cuando el objetivo es lograr una apariencia repetible en lugar de un proyecto de ingeniería completo.
La monitorización importa después del lanzamiento. Comprueba la deriva en la precisión, los casos límite extraños y los cambios en calidad a medida que alimentas al modelo con nuevas indicaciones. Si los resultados comienzan a degradarse, un pequeño conjunto seleccionado de ejemplos difíciles suele ser más útil que empezar de cero.
El modelo nunca está «terminado». Solo sigue siendo útil si sigues comparando los resultados con la apariencia que realmente deseas.
Si estás listo para convertir una idea visual aproximada en algo repetible, empieza constarryai, prueba un conjunto de estilos enfocado y comprueba si tu proyecto se adapta a un flujo de trabajo de creador ligero antes de comprometerte con una ruta de entrenamiento más pesada.


