

Escrito porMo Kahnel


La IA de texto a imagen no busca una foto guardada: un codificador de texto convierte tu aviso en números, y luego la eliminación de ruido repetida convierte el ruido aleatorio en una imagen guiada por esos números. La difusión latente, introducida en investigaciones influyentes en 2022, hace que ese proceso sea más eficiente al trabajar con una representación comprimida en lugar de cada píxel.
El consejo popular de "simplemente escribe un mejor aviso" pasa por alto una parte del panorama. Tus palabras guían una conjetura iterativa, no una búsqueda directa ni un collage, por lo que el resultado puede tomar tiempo, cambiar entre ejecuciones o fallar en las manos, el recuento de objetos y las letras. Comprender los pasos te ayuda a escribir avisos más claros y a decidir qué arreglar cuando una generación falla.
Una aplicación de texto a imagen no recupera una imagen terminada ni ensambla un collage a partir de tus palabras. Utiliza tu aviso para guiar una serie de conjeturas, comenzando con ruido aleatorio y dándole forma gradualmente hasta convertirlo en una imagen. Lainvestigación de 2022 sobre la difusión latente y el proceso de generación de imágenesdescribe cómo este proceso pasa del ruido a una imagen que se ajusta al aviso.
| Etapa | Lo que hace el modelo | Lo que ves |
|---|---|---|
| Codificación de texto | Un codificador de lenguaje convierte el aviso en incrustaciones numéricas | Nada visible todavía |
| Inicio de ruido | La generación comienza a partir de ruido gaussiano aleatorio | Estática gris sin objetos |
| Eliminación de ruido temprana | Los primeros pasos establecen la forma general, los objetos y el diseño | Una composición borrosa |
| Eliminación de ruido tardía | Los pasos posteriores añaden color, textura y detalles finos | Superficies y bordes más nítidos |
| Decodificar | Un decodificador convierte la representación latente nuevamente en píxeles | La imagen terminada |
Las etapas explican por qué una vista previa temprana puede verse borrosa pero aun así mostrar la composición de la escena. La codificación de texto prepara instrucciones numéricas, mientras que el ruido inicial no contiene objetos reconocibles. La reducción de ruido temprana establece la composición general; los pasos posteriores refinan principalmente los colores, las superficies y los bordes.
Guía de textodescribe con qué fuerza el indicador guía la reducción de ruido. Algunas aplicaciones exponen esto como una escala de guía. Una configuración más alta acerca el resultado a la redacción, aunque puede hacer que la imagen se vea áspera. Una configuración más baja le da a la generación más margen para desviarse. El mensaje establece el objetivo; la configuración de guía afecta la firmeza con la que el proceso lo sigue.
Reducir el ruido de cada píxel directamente requeriría más cálculo y memoria. La difusión latente primero comprime una imagen en una representación más pequeña, ejecuta la reducción de ruido allí y luego decodifica el resultado nuevamente en píxeles. Esto hace que sea más práctico generar imágenes de alta resolución sin refinar cada píxel durante todo el proceso.
Puedes leer una vista previa como un trabajo en progreso: busca primero la composición y luego verifica si los detalles llegan a medida que la imagen se vuelve más nítida. La asistencia de la inteligencia artificial para la investigación académica es otro ejemplo de inteligencia artificial que apoya un proceso de trabajo paso a paso.
Los pares de entrenamiento son lecciones, no un estante de imágenes terminadas esperando que la aplicación las copie. Cada par conecta un ejemplo visual con palabras que lo describen, ayudando a un modelo a aprender asociaciones entre el lenguaje y los patrones visuales. Esas asociaciones pueden incluir un sujeto, sus atributos, la disposición de una escena y un estilo visual.
La escala de los datos de entrenamiento importa, pero también la calidad de sus subtítulos. LAION-5B, un conjunto de datos disponible públicamente utilizado en la investigación de imagen a texto, contiene aproximadamente5 mil millones de imágenes, con alrededor de2 mil millonesque tienen subtítulos en inglés correspondientes, según lainvestigación del conjunto de datos de imagen a texto LAION-5B. El modelo aprende patrones de estos ejemplos; no los usa como una tabla de búsqueda de imágenes terminadas.
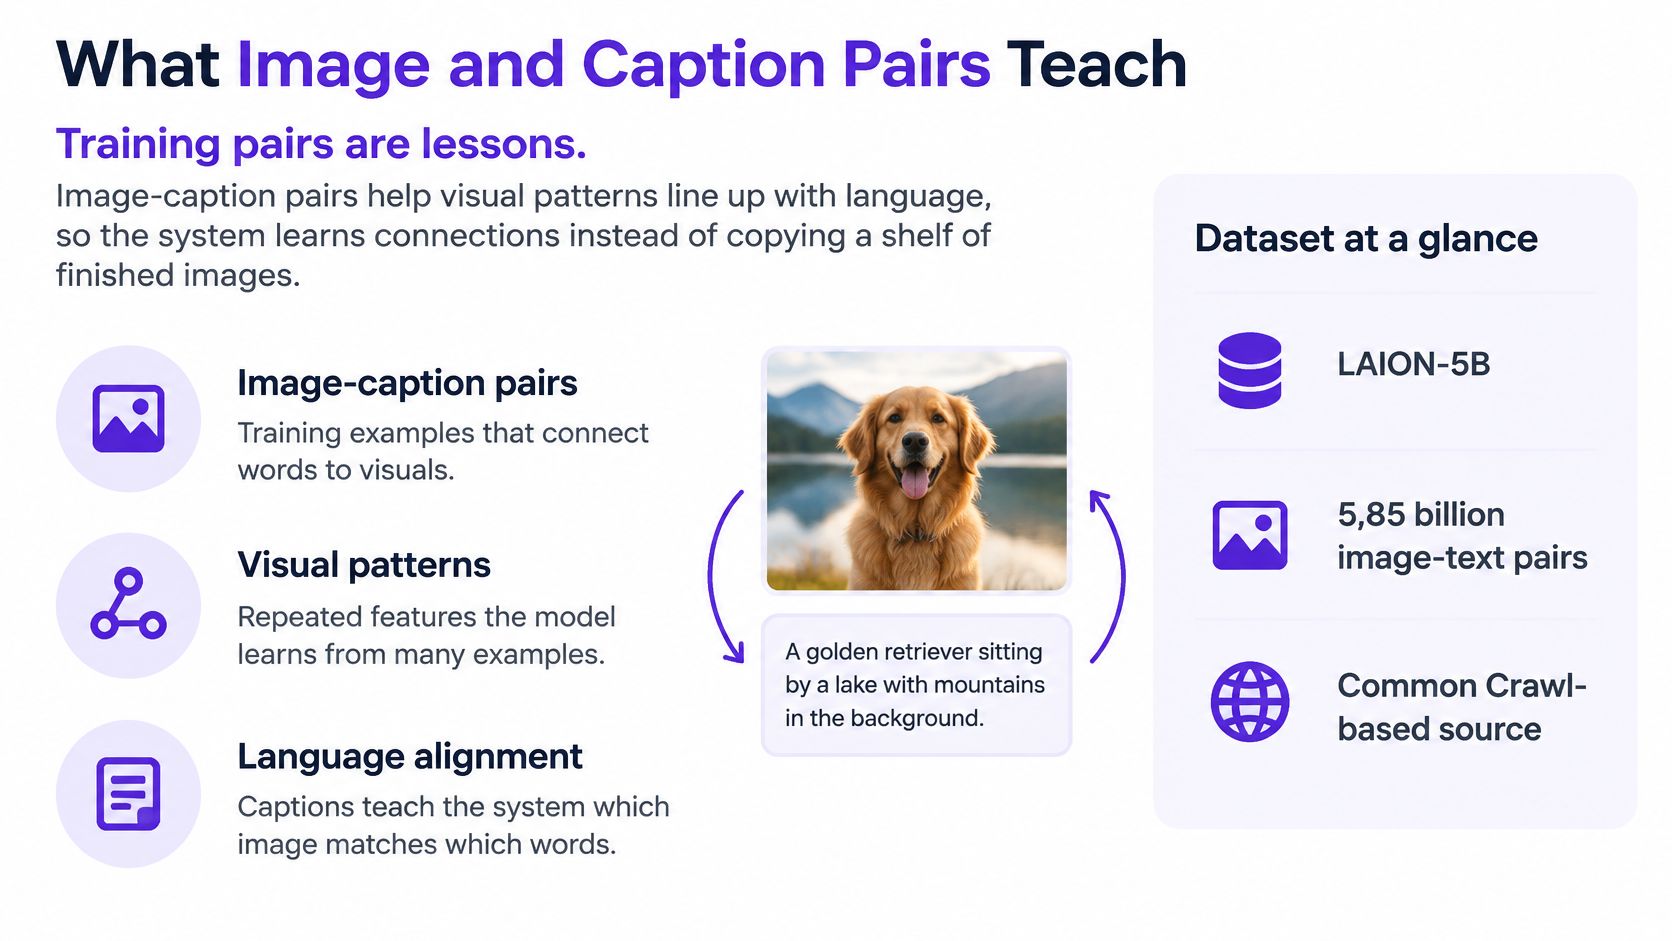
Los subtítulos afectan lo que el modelo puede aprender a asociar con una imagen. Los subtítulos densos y de alta calidad pueden mejorar la fidelidad con la que las imágenes generadas siguen al texto. La contrapartida es que también pueden reducir la calidad estética y la diversidad de resultados. Un sistema que aprende de descripciones más precisas puede ser mejor para hacer coincidir los detalles indicados, sin producir una gama más amplia de estilos.
Esto ayuda a explicar por qué seguir las indicaciones no es solo una cuestión de hacer que un modelo visual sea más grande. El modelo también depende de si sus subtítulos de entrenamiento describieron cada imagen con la suficiente claridad. Si un disfraz inusual, una criatura de juego de nicho o una marca distintiva aparecen en pocos ejemplos bien descritos, el sistema puede tener patrones más débiles en los que basarse.
Para un sujeto oscuro, divide la idea en características visuales que el modelo pueda expresar: la forma de un disfraz, sus materiales y colores, las partes del cuerpo de la criatura o la posición de una marca similar a un logotipo. Un mensaje que describa esas partes visibles le da al sistema más con qué trabajar que un nombre interno por sí solo.
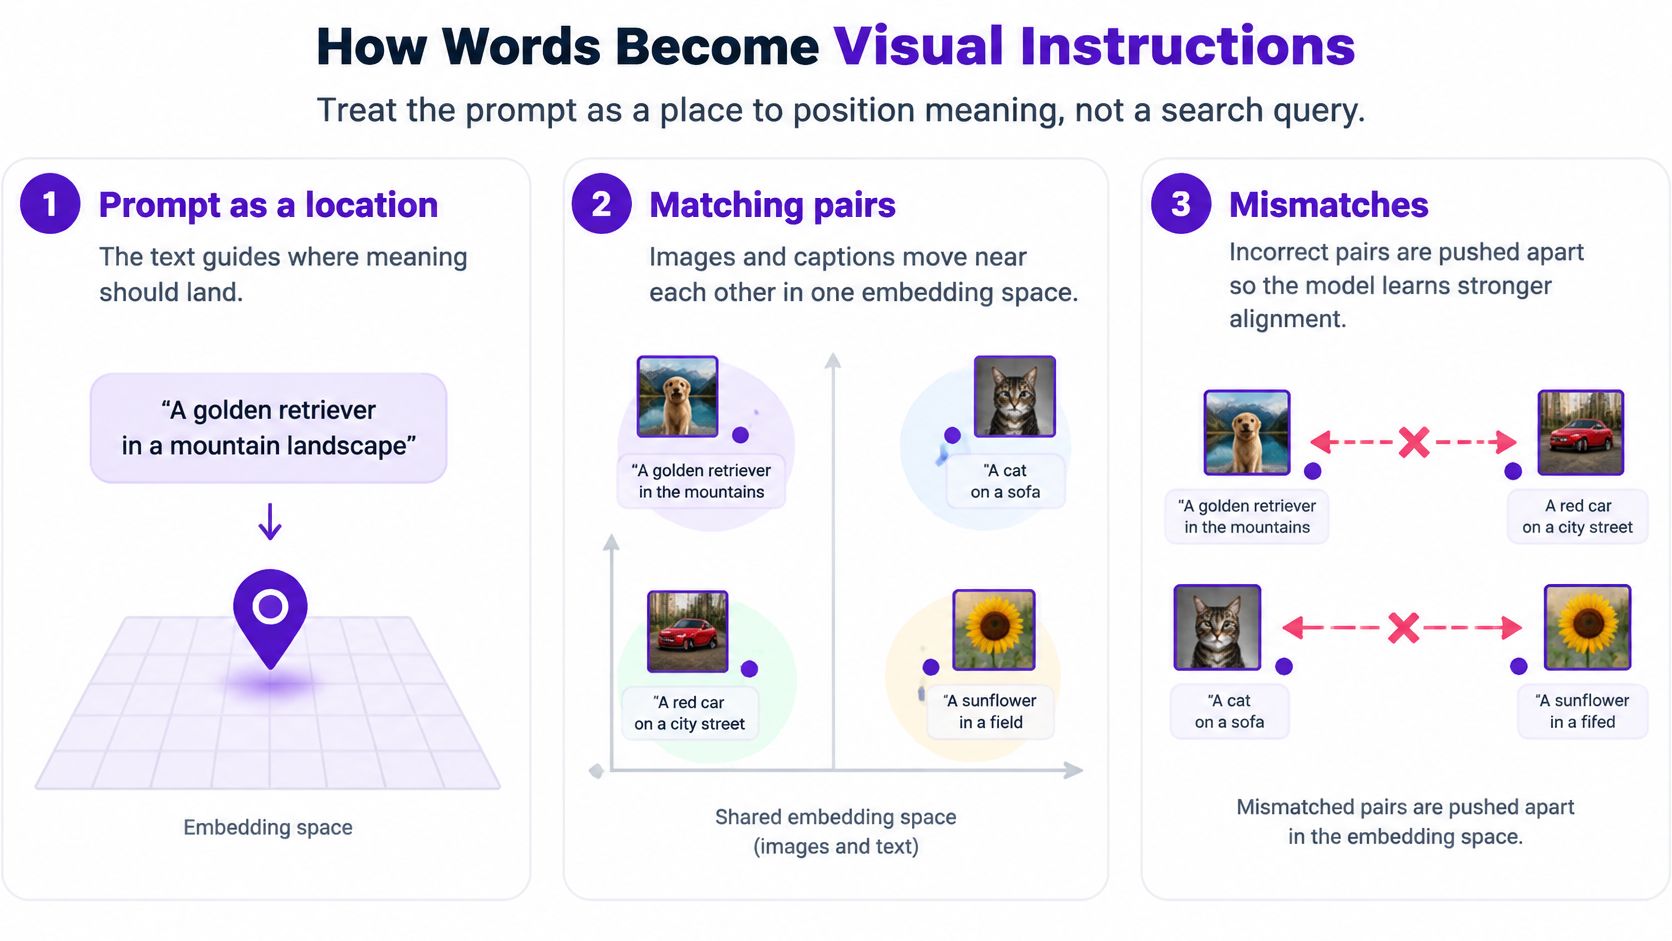
Piense en una habitación compartida donde las imágenes y sus subtítulos tienen un lugar. Un buen subtítulo se sienta cerca de la foto que describe; un subtítulo incorrecto se sienta más lejos. En un enfoque al estilo CLIP, las imágenes y los subtítulos coincidentes se acercan en un espacio de incrustación compartido, mientras que los pares no coincidentes se separan. Elrelato del aprendizaje contrastivo en los sistemas de texto a imagenexplica cómo se mide esta coincidencia en ambas direcciones, imagen a texto y texto a imagen.
En el momento de la generación, el indicador se convierte en una representación numérica que transporta conceptos como sujeto, atributos y estilo. El modelo de difusión utiliza esa representación para guiar la formación de la imagen, en lugar de tratar el indicador como una cadena no estructurada. En términos sencillos, el modelo intenta mantener el significado nombrado mientras lo convierte en estructura visual.
Considere dos avisos para una imagen de café:
“Bonita foto de café”.
“Taza de esmalte rojo en el alféizar de una ventana, luz lateral de la mañana, sin texto”.
El primero le da al modelo un destino amplio, pero deja muchas opciones abiertas. El segundo nombra el objeto, su color y material, su relación con el alféizar de la ventana, la iluminación y una restricción. Esos detalles le dan a la representación del mensaje anclajes más claros.
Un mensaje de texto a imagen no es una consulta de búsqueda que busca la foto existente más cercana. Es un conjunto de instrucciones que guía el proceso de creación de imágenes. Nombra lo que debe aparecer, cómo se relacionan los elementos y qué opciones visuales importan más. Unaguía para la optimización de avisos de IApuede ayudarle a desarrollar ese hábito para la creación de imágenes.
La guía de texto también afecta la fuerza con la que el mensaje tira en cada paso de reducción de ruido. Un mensaje preciso le da al modelo conceptos más claros para preservar; la configuración de la guía determina con qué firmeza esos conceptos influyen en la imagen emergente. Ninguno garantiza que cada detalle sea correcto.
Pruebe este hábito de escritura: nombre el sujeto, una relación, un punto de vista o fuente de luz, y algo que omitir. Por ejemplo, “taza roja en el alféizar de la ventana, vista a la altura de los ojos, luz lateral suave de la mañana, sin letras” es más procesable que una serie de cumplidos generales. Esa claridad no elimina la incertidumbre, pero le da al proceso un objetivo más específico.
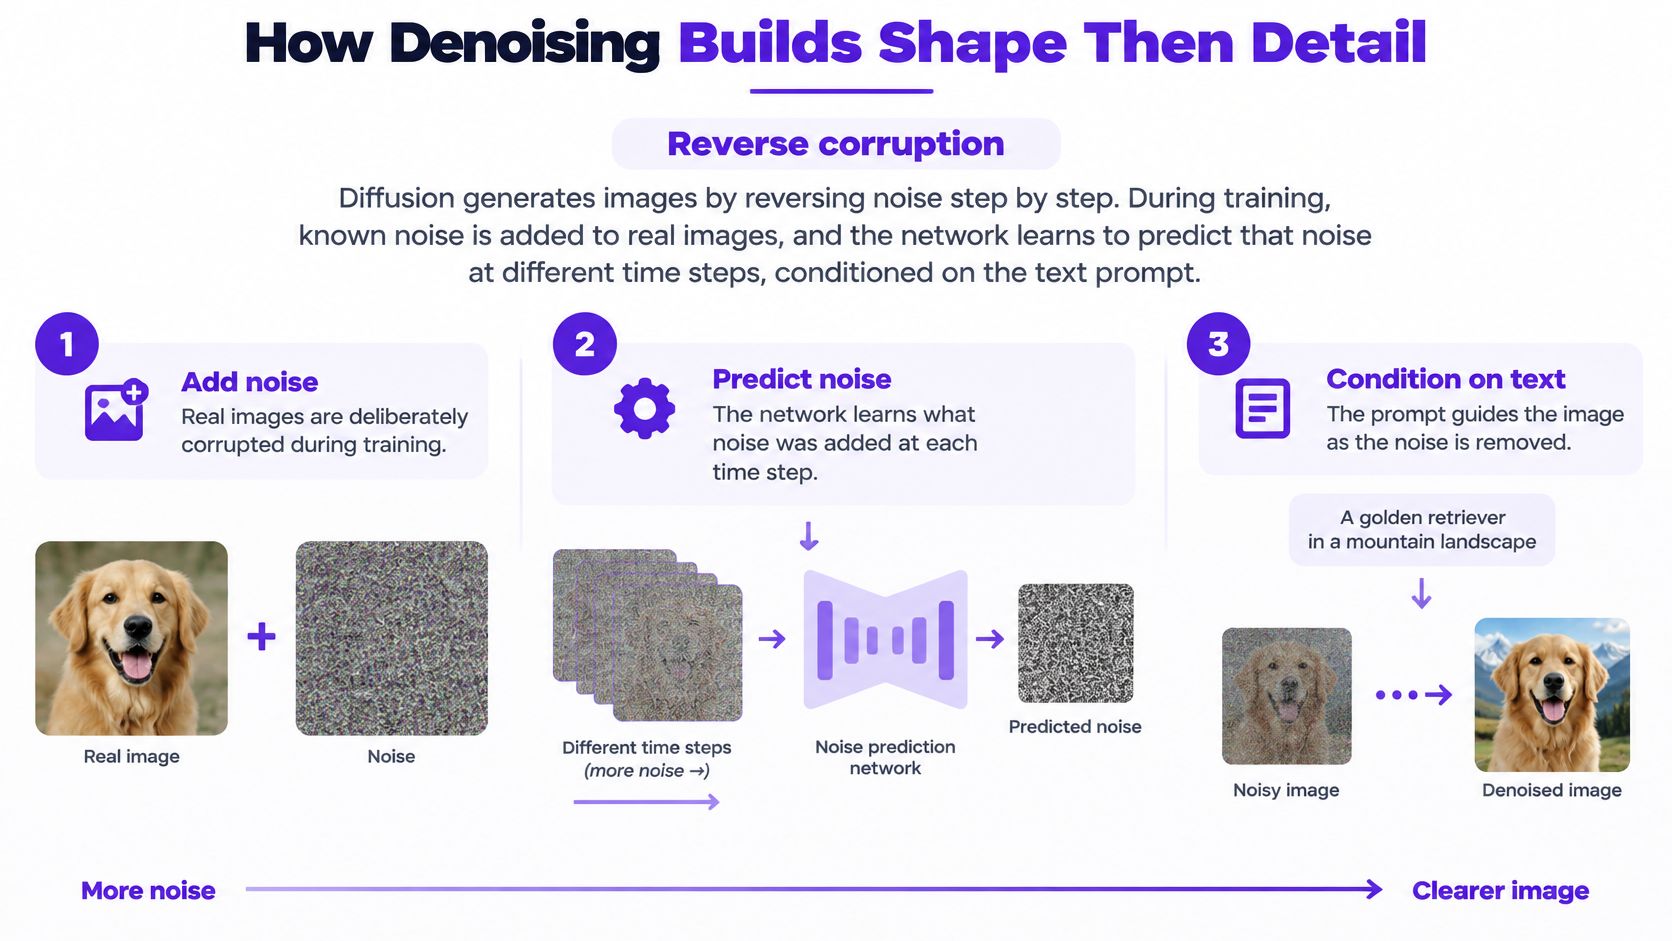
Durante el entrenamiento, el modelo ve imágenes alteradas deliberadamente con ruido conocido. Aprende a predecir el ruido en diferentes pasos de tiempo mientras usa la representación del texto como condición. La generación invierte esa corrupción: el modelo comienza a partir del ruido y aplica su operación de reducción de ruido aprendida repetidamente, avanzando hacia una imagen que se ajuste al mensaje.
No hay una foto original escondida debajo del punto de partida aleatorio. En la inferencia, el modelo no está recuperando una imagen en particular que haya visto antes. Cada paso hace una predicción sobre cómo debe verse la imagen emergente, dado el estado ruidoso actual y la guía de texto.
Un sistema de difusión basado en píxeles funciona directamente en los píxeles de la imagen, lo que puede exigir un cálculo sustancial. La difusión latente comprime primero la imagen, ejecuta los pasos de reducción de ruido en esa representación más pequeña y luego usa un decodificador para convertir el resultado en píxeles. El cambio a este enfoque en 2022 redujo los requisitos de cálculo y memoria al tiempo que admitía la síntesis de alta resolución.
La eficiencia viene con una compensación. El modelo no refina cada píxel directamente durante su bucle de generación principal, y el proceso de compresión y decodificación puede limitar la calidad final. La difusión latente hace que la generación sea más práctica, pero no hace que cada resultado sea impecable.
Los primeros pasos de reducción de ruido establecen la composición global y la geometría del objeto. Los posteriores rellenan principalmente los detalles, como la superficie de una tela, un reflejo o un borde. Unaintroducción en lenguaje sencillo a Stable Diffusionofrece otra forma de explorar un enfoque de difusión ampliamente utilizado.
Este orden es útil cuando se evalúa una vista previa. Si la postura de un corredor o la posición de un personaje de la portada de un libro se ve mal mientras la imagen aún está borrosa, agregar más textura no es la solución. El modelo puede refinar una suposición inicial incorrecta en lugar de corregirla mágicamente. Piense en el progreso visible comoprimero el diseño, segundo las superficies y último los píxeles.
Un aviso no se convierte directamente en píxeles en una sola operación. El modelo comienza con ruido aleatorio y hace una secuencia de predicciones, por lo que volver a ejecutar las mismas palabras puede conducir a un resultado diferente. Incluso los enfoques de difusión acelerada suelen requerir aproximadamente20–50 pasos de reducción de ruido secuenciales por imagen, según unanálisis de la velocidad, la inconsistencia y los problemas prácticos en la generación de texto a imagen.
El mismo proceso iterativo ayuda a explicar por qué un aviso puede pasar por alto una instrucción. Una predicción sobre la alineación del texto, la anatomía o la cantidad de objetos puede afectar los pasos posteriores. Un aviso más largo también puede empeorar las cosas si combina sujetos o estilos competidores, dejando al modelo con un conjunto confuso de direcciones.
| Lo que notas | Por qué el mecanismo lo hace | Qué probar a continuación |
|---|---|---|
| Mismo aviso, imagen diferente | Cada ejecución comienza a partir de un nuevo ruido aleatorio y se aproxima | Nombre la composición y el punto de vista, luego vuelva a generar |
| Manos, extremidades o conteos extraños | Los errores pueden acumularse en unos 20 a 50 pasos | Use menos personas, simplifique la pose y luego haga una pasada de edición |
| Letras rotas o adicionales | El texto es difícil de mantener alineado en los píxeles | Use palabras muy cortas o agregue tipografía fuera del modelo |
| Más detalle lo empeoró | Conceptos contrapuestos separan el embedding | Elija un solo sujeto, relaciones claras y un estilo |
| La generación se siente lenta | Los pasos se ejecutan en secuencia, no como una sola escritura de píxeles | Planee varios intentos en lugar de una pasada perfecta |
Una representación latente comprimida puede reducir el cálculo, pero también crea un límite máximo de calidad impuesto por el codificador automático. Si la compresión pierde algo, la denuación posterior no siempre puede recuperarla. Por eso, una imagen atractiva es evidencia de un resultado exitoso, no una prueba de que el modelo resolverá de manera confiable cada instrucción.
La destilación y el modelado de consistencia son desarrollos a tener en cuenta. Su objetivo es reducir la generación a una o dos evaluaciones en lugar de muchos pasos de difusión, lo que podría hacer que la creación de imágenes sea más receptiva para flujos de trabajo creativos móviles y de alto volumen. Esa dirección no significa que todas las aplicaciones de imágenes actuales ya se generen en uno o dos pasos.
Para los creadores, la respuesta práctica es especificar la composición, las relaciones entre los sujetos, la cámara o el punto de vista y las restricciones de salida. Luego, trate un resultado defectuoso como una inferencia fallida, no como un veredicto sobre la idea: vuelva a generar cuando la composición esté desviada o edite la parte que falló. Al comparar herramientas, concéntrese en cuál maneja su tarea recurrente y flujo de trabajo de corrección; esteresumen de modelos de texto a imagenproporciona otro punto de partida.
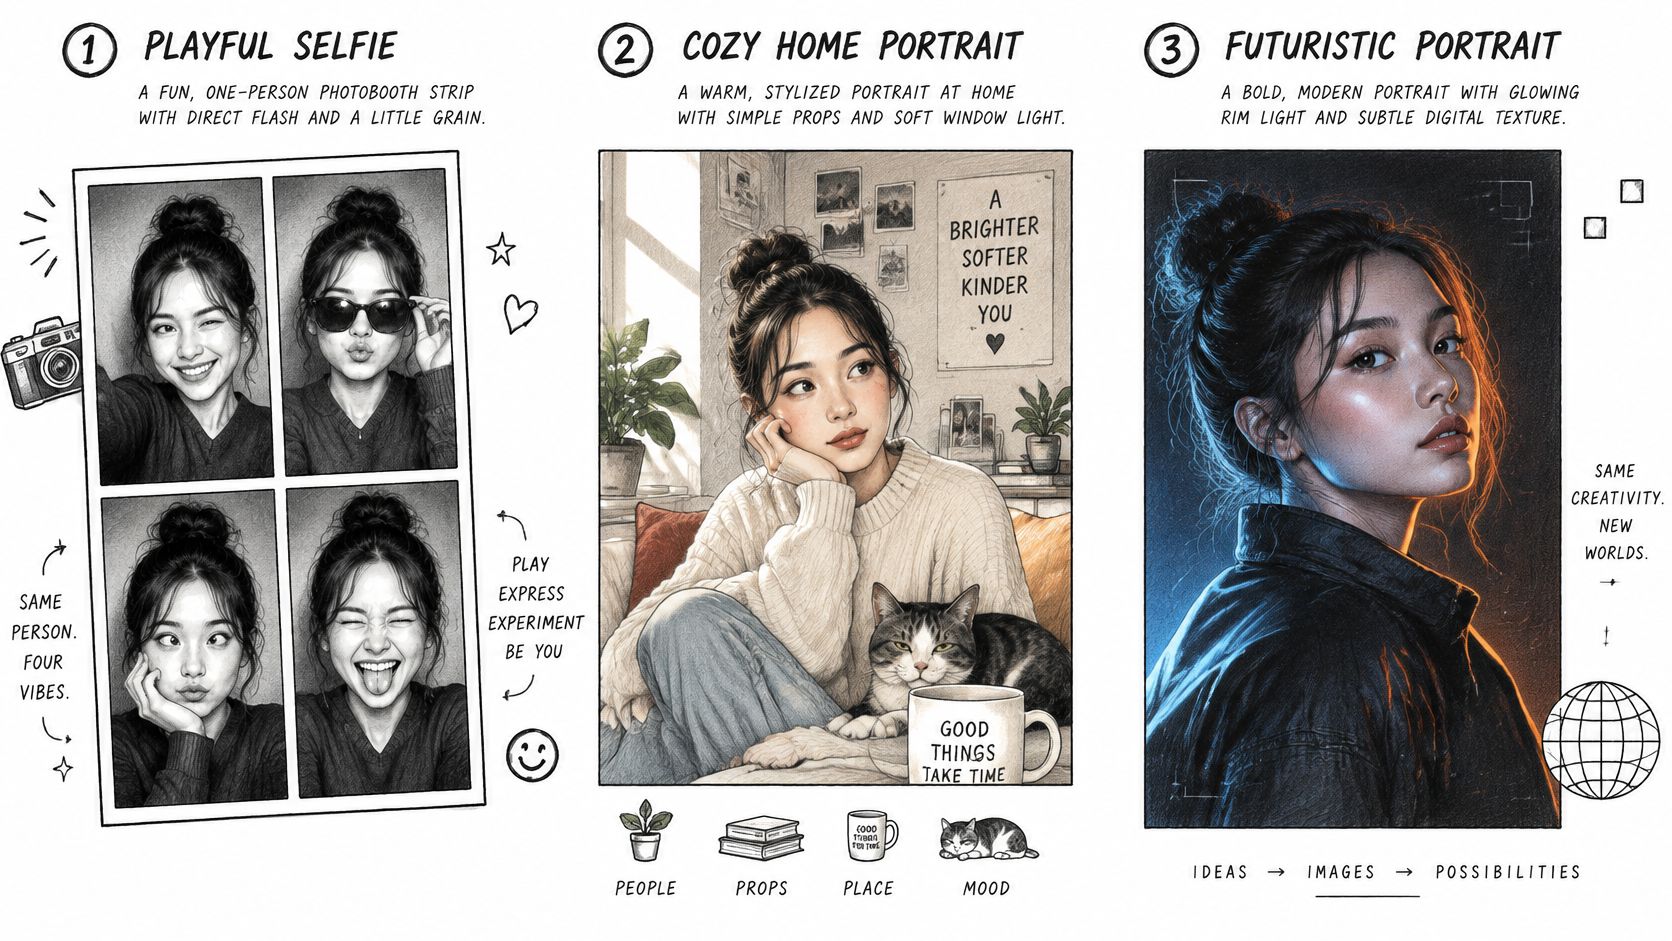
El mismo hábito de redacción de avisos puede servir para la transformación de una selfi, un retrato atlético o el concepto de un personaje. En cada caso, proporcione al modelo las instrucciones estructurales primero y luego use detalles que respalden el aspecto deseado. Aquí hay tres avisos que puede adaptar.
Selfi estilo fotomatón:“Una persona con una expresión juguetona, flash de cámara directo, diseño de tira de fotos de cuatro fotogramas, ligero grano de película”. Las palabras “una persona” y “diseño de tira de fotos de cuatro fotogramas” le dan al modelo el sujeto y la composición inicial para establecer. El “flash de cámara directo” define la iluminación; el “ligero grano de película” es un detalle de superficie. Omita etiquetas de estilo adicionales que compitan con el aspecto de tira de fotos.
Para ver el tipo de transformaciones de retratos que pueden inspirar nuevas ideas, eche un vistazo al siguiente ejemplo.
Retrato atlético:“Corredor a mitad de zancada en una pista, postura decidida, ropa deportiva oscura y sencilla, luz lateral”. “Corredor a mitad de zancada” y “postura decidida” ayudan a determinar la posición del cuerpo y la forma general. La pista y la luz lateral ubican al sujeto en un entorno claro. No apile varios estilos de ropa o estados de ánimo en un aviso que ya necesita una pose legible.
Personaje para una portada o mercancía:“Un personaje de fantasía, abrigo verde bosque y bufanda de cobre, fondo crema liso, sin texto”. El sujeto y los detalles de la ropa le dan al generador un objetivo visual conciso; el fondo liso mantiene la atención en el personaje. Omitir el título es deliberado. Agregue letras precisas después en lugar de confiar en que el modelo de imagen deletree el título de una portada.
Para un flujo de trabajo diario, starryai le permite comenzar a partir de un aviso de texto o una selfi, generar variaciones de imagen y usar Editar cuando una mano, un fondo o un recorte no den en el blanco. Mantenga el sujeto, el diseño y el fondo claros en el aviso inicial. Luego, ajuste solo el detalle fallido en lugar de reescribir todo.
Una señal de procedencia puede mostrar que una imagen fue generada o procesada por IA. No establece que tenga permiso para usar cada elemento, que un mercado permita la imagen o que su contexto sea veraz. Las Credenciales de contenido y las marcas de agua invisibles pueden registrar o señalar el historial de una imagen, aunque el recorte, la compresión o la edición sustancial pueden hacer que una marca de agua sea difícil de detectar. Ninguna señal visible prueba que una imagen sea una fotografía.
Para portadas de libros, mercancías, avatares y publicaciones de marcas, guarde cómo se hizo la imagen y revísela antes de publicar:
Una etiqueta puede explicar el proceso de una imagen, pero aún debe juzgar qué representa y si tiene derecho a usar sus ingredientes. En starryai, guarde su aviso junto a la imagen generada, luego vuelva a generar o edite la anatomía o el texto defectuosos. Revise el archivo final antes de publicarlo o venderlo.
starryai ofrece un generador de imágenes de IA gratuito y un conjunto creativo para convertir avisos de texto, selfis y emojis en imágenes. Pruebe con un aviso claro, compare los resultados yvisite starryaipara experimentar con el flujo de trabajo de generación y edición.


