

Escrito porMo Kahnel


Has encontrado la imagen de referencia. La iluminación es exactamente la correcta, el sujeto tiene la expresión que deseas y la composición se siente natural. Luego intentas describirla y el resultado sale como un retrato genérico con luz plana, colores aleatorios y nada de la tensión original.
Ese es el desafío principal detrás de los flujos de trabajo deimagen a aviso. Una herramienta puede identificar una cara, una silla o una puesta de sol, pero una recreación útil depende de detalles como la dirección de la luz, la sensación de la lente, la jerarquía espacial, la textura y el estilo visual. La ingeniería inversa manual te da control sobre esos detalles, mientras que el análisis automatizado aún puede acelerar las partes que los humanos encuentran tediosas.
Todo creador eventualmente guarda una imagen que no puede explicar del todo. Puede ser un retrato melancólico con una franja estrecha de luz de ventana, una foto de producto con sombras inusualmente suaves o una composición editorial donde el espacio vacío hace que el sujeto se vea costoso. Sabes que la imagen funciona, pero "mujer en el escritorio, iluminación cinematográfica, alta calidad" no capturará el porqué.
El problema es que las descripciones de imágenes suelen comenzar con objetos en lugar de relaciones. Un pie de foto puede identificar a una persona, un escritorio, un cuaderno y una lámpara. Puede pasar por alto que la persona está sentada fuera del centro, la lámpara crea un charco cálido contra una habitación más fría y el escritorio guía la mirada diagonalmente hacia la cara. Esas omisiones importan más que la lista de objetos.
La mayoría de los sistemas de imagen a aviso siguen un patrón sensato. Un modelo de visión y lenguaje analiza la referencia, luego un LLM propone texto que podría recrearla. Un enfoque documentado utiliza un proceso de dos etapas que compara la referencia con una imagen generada antes de redactar avisos inversos candidatos, lo que hace que el flujo de trabajo sea más útil que la simple generación de pies de foto por sí sola (el enfoque de aviso inverso descrito).
Otros conductos combinan el etiquetado BLIP con la búsqueda de similitud CLIP. El sistema crea un pie de foto, recupera palabras clave cercanas de una base de datos de avisos utilizando incrustaciones de imágenes y combina esas palabras clave con el pie de foto (un conducto estilo CLIPInterrogator documentado). Eso puede revelar un lenguaje de estilo útil, pero también puede producir un aviso lleno de términos vagamente relacionados.
Regla práctica:Utiliza la extracción para generar pistas, no para tomar la decisión creativa por ti.
La historia más amplia explica por qué estos sistemas se volvieron prácticos. El conjunto de datos Conceptual Captions de Google, introducido en 2018, contenía aproximadamente3.3 millones de imágenes de entrenamiento, junto con28,000 imágenes de validación22,500 imágenes de prueba22,500 test images, creating the scale needed for image-text systems to connect visual patterns with language (cuenta histórica de OpenAI sobre DALL·E y el aprendizaje de imagen a texto). OpenAI's DALL·E announcement on5 de enero de 2021ayudó a trasladar la generación de imágenes guiada por texto de las demostraciones de investigación a una categoría de productos convencional.
Esa escala no elimina la brecha de descripción. Hace posible la asistencia automatizada, pero el ojo humano aún tiene que decidir qué hechos visuales definen la referencia. Un flujo de trabajo híbrido útil combina la amplitud de una máquina con el criterio de un creador. Para obtener contexto sobre por qué las imágenes y el lenguaje funcionan juntos en primer lugar, consulta esta guía sobreIA multimodal.
Una descripción sólida no informa de todo lo visible. Identifica los detalles que controlan la identidad de la imagen generada. Comienza con el sujeto, pero no te detengas ahí. Una traducción útil de imagen a indicación suele necesitar cuatro capas conectadas:iluminación, composición, color y estilo.
Pregunta de dónde viene la luz, qué tan grande parece la fuente y qué ocurre en las sombras. Una luz frontal suave produce un rostro diferente al de una pequeña fuente direccional colocada en alto a un lado. Una luz de contorno dura separa un sujeto del fondo, mientras que la luz ambiental nublada reduce el contraste y otorga a los materiales una apariencia más apagada.
Describa la calidad en lugar de recurrir inmediatamente a un adjetivo de moda. «Luz principal cálida desde la izquierda de la cámara, relleno ambiental frío, sombra suave bajo la barbilla» le proporciona a un generador una dirección más útil que «hermosa iluminación cinematográfica». Si la imagen contiene luces prácticas, ventanas o reflejos, inclúyalos únicamente cuando influyan en la escena.
La composición es la disposición del peso visual. Observe si el sujeto está centrado, colocado en un tercio, encuadrado de forma cerrada o rodeado de un espacio negativo deliberado. Registre el ángulo de la cámara, la distancia aparente, la posición del horizonte y las relaciones de profundidad.
Un ángulo contrapicado puede hacer que un objeto ordinario se sienta monumental. Una vista cenital convierte una mesa en un patrón gráfico. Un primer plano poco profundo con un fondo distante crea un orden de lectura diferente al de una escena plana y enfocada de manera uniforme. Estas relaciones a menudo importan más que enumerar cada objeto.
Extraiga primero la paleta dominante y luego identifique los acentos. Es posible que vea salvia apagado, crema y carbón con un solo detalle en naranja. O la escena podría basarse en azules profundos, tonos de piel pálidos y reflejos ámbar. Evite nombrar colores que estén tecnicamente presentes pero que sean visualmente irrelevantes.
El color también tiene una distribución. Pregunte si la paleta está concentrada en el fondo, reservada para el sujeto o repetida a través de pequeños acentos. Una «chaqueta roja» aporta menos información que «una única chaqueta roja saturada contra una arquitectura gris desaturada».
El estilo incluye el medio, la época, el acabado y la referencia cultural. Decida si la imagen se siente como una fotografía de estudio, un reportaje de moda editorial, un fotograma de película analógica, un cartel gráfico, una pintura al óleo, un renderizado 3D o un arte conceptual dibujado a mano. A continuación, describa las cualidades de la superficie que respaldan esa lectura, como el grano, el halo, la textura de pincel, los reflejos brillantes, las fibras de papel o los bordes vectoriales limpios.
Los mejores *prompts* describen cómo las elecciones visuales funcionan en conjunto, no solo lo que aparece en el encuadre.
Una secuencia práctica esel sujeto, la acción, el escenario, la composición, la iluminación, el color, el material y el estilo. Este orden mantiene el *prompt* legible y le proporciona al modelo una jerarquía en lugar de un cúmulo de descriptores desconectados. Para obtener una base más amplia, utilice esta introducción a laingeniería de *prompts* para principiantes.
La extracción manual funciona mejor cuando retrasas la escritura. Observa la imagen primero, redúcela a decisiones visuales y solo entonces convierte esas decisiones en lenguaje. El objetivo no es describir cada píxel. Es identificar los atributos que otra imagen debe conservar.
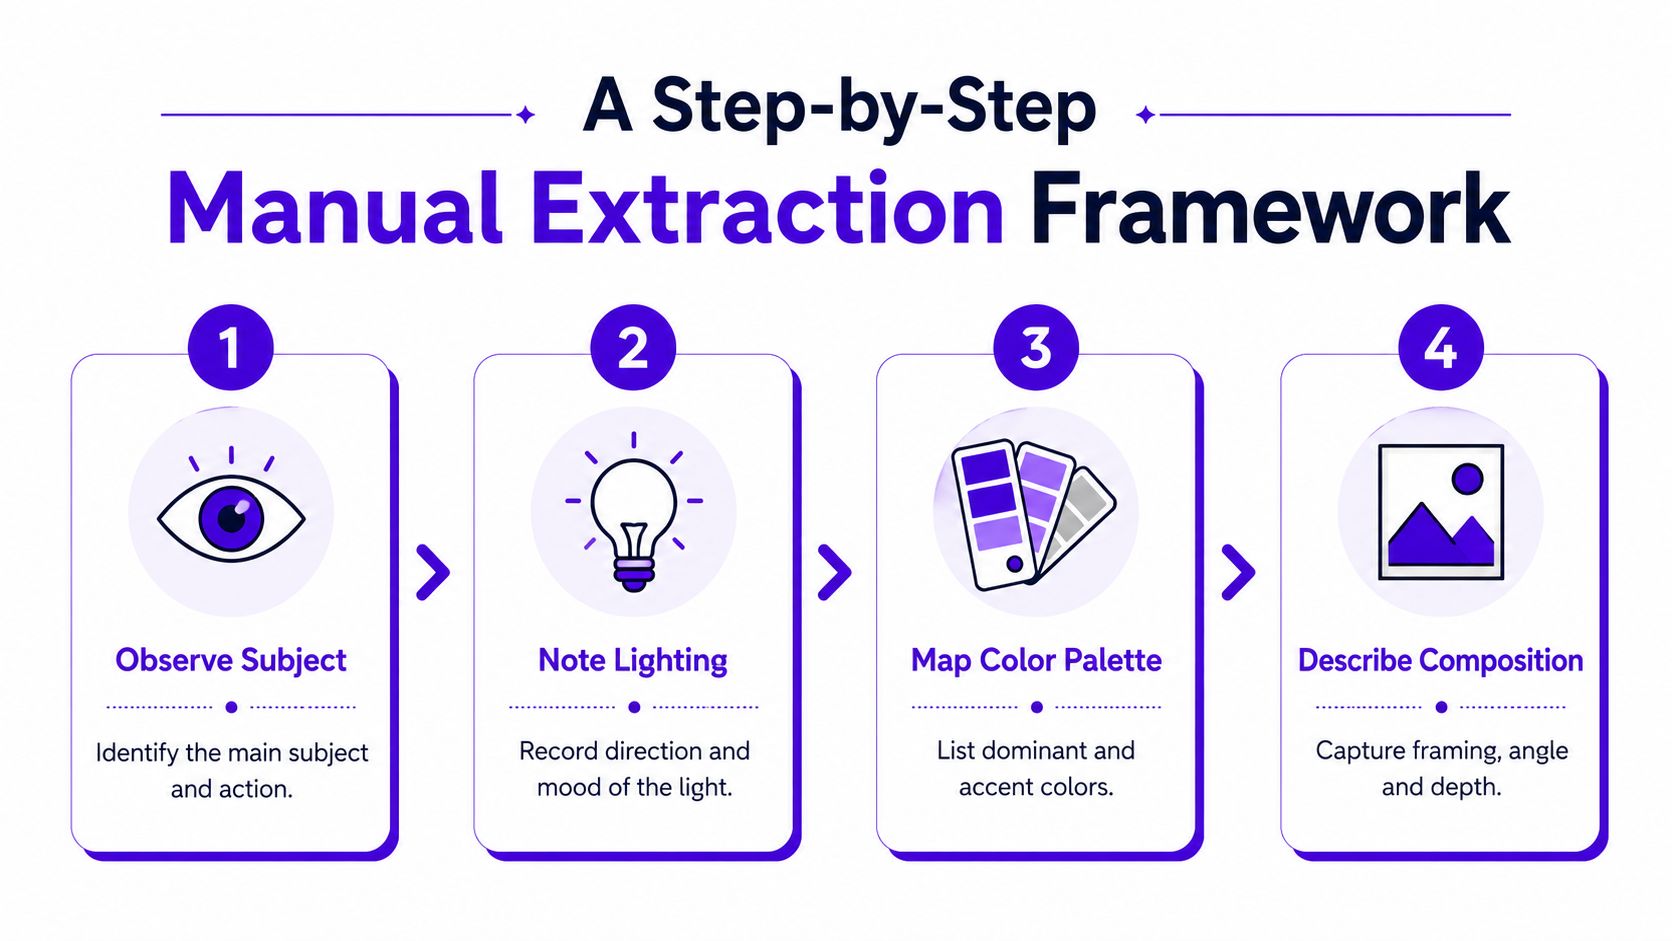
Nombrar el sujeto principal en términos concretos y luego indicar qué está haciendo. «Persona» es débil. «Joven inclinada sobre un escritorio de madera, mirando hacia un cuaderno de bocetos» te da identidad, postura y acción.
Separar los elementos principales de los secundarios. El sujeto focal recibe la descripción más clara. Los objetos de fondo solo deben aparecer si establecen el lugar, la escala o el ambiente. Un retrato puede necesitar a la persona, la pose, la ropa y la expresión, pero no cada libro en el estante.
Encontrar la región más brillante y trazar la dirección de las sombras. ¿La fuente está cenital, lateral, frontal, a contraluz o dispersa por toda la escena? Luego describe la calidad: dura, difusa, brumosa, brillante, de bajo contraste o esculpida con nitidez.
Para un retrato evocador, podrías registrar una fuente de luz cálida y estrecha desde la ventana a la derecha, una caída profunda en la mejilla opuesta y un fondo oscuro. Para una toma de producto comercial, podrías notar una iluminación frontal amplia, reflejos controlados, un fondo pálido y una sombra suave de apoyo. El mismo objeto puede sentirse íntimo o comercial dependiendo de esta capa.
Anota el color de fondo dominante, el color principal del sujeto y el acento más fuerte. Luego añade observaciones de material. El papel mate, el metal cepillado, el vidrio mojado, la lana tejida, la piel, el plástico pulido y el hormigón rugoso responden a la luz de manera diferente.
El lenguaje de los materiales ayuda a evitar que un «prompt» se vuelva visualmente genérico. «Botella negra» describe un objeto. «Botella de vidrio negro mate con un reflejo contenido y gotas de condensación» describe cómo debe renderizarse el objeto.
Registra el encuadre, el ángulo, el recorte y la profundidad. ¿Es un primer plano, un plano medio, una disposición cenital, una escena amplia o una composición de producto centrada? Observa si el sujeto mira a la cámara y si el fondo es comprimido o expansivo.
Inspecciona el texto incrustado por separado. Las letras legibles, las etiquetas, los letreros y los elementos de la interfaz necesitan su propia pasada porque los generadores de imágenes pueden tratarlos como textura visual en lugar de lenguaje. La OCR puede ayudar a identificar las palabras, pero aun así debes decidir si el texto pertenece al resultado final o debe agregarse más tarde en una herramienta de diseño.
Una hoja de trabajo de extracción compacta podría verse así:
Convierte esas notas en un primer «prompt», luego compara el resultado con la referencia. No añadas todos los detalles faltantes a la vez. Cambia la capa que causó la discrepancia para saber qué ajuste ayudó.
Una vez que las notas visuales estén claras, puede utilizarlas como información de guía en lugar de esperar que una imagen cargada transmita todo el concepto. starryai le permite trabajar a partir de selfis, indicaciones de texto y emojis, mientras que su flujo de trabajo de guía por imagen combina una imagen cargada con instrucciones escritas. Esto la hace adecuada para probar el ambiente, la pose, la paleta o la transformación de una referencia sin tratar la imagen fuente como un conjunto de instrucciones completo.
Cargue la referencia o una imagen base relacionada, y luego comience con el sujeto y la composición. Una primera indicación práctica podría describir unretrato de tres cuartos de una mujer sentada en un escritorio de madera, inclinada hacia un cuaderno de bocetos, con el sujeto ubicado en el tercio derecho del encuadre. Agregue únicamente la iluminación y la paleta que definen la referencia.
La primera generación es diagnóstica. Si la pose es incorrecta, revise la acción y el lenguaje de la cámara. Si la escena se siente demasiado brillante, ajuste la calidad de la luz y la profundidad de las sombras. Si la imagen pierde su identidad, elimine los términos de estilo decorativo y refuerce el sujeto, el encuadre y los materiales clave.
Los creadores suelen empezar con «soñador», «viral» o «cinematográfico», y luego se preguntan por qué el resultado se siente intercambiable. El estilo funciona mejor después de que el generador comprende la escena. Agregue «ilustración digital editorial», «sutil grano de papel» o «bordes suaves y pictóricos» después de la descripción estructural, no antes.
También puede utilizar el flujo de trabajo de transferencia de estilo de starryai cuando el tratamiento visual de la imagen de destino importa más que su contenido literal. Su flujo de trabajo de bocetos comienza con una foto cargada y una indicación que describe el estilo de boceto deseado, lo que le ofrece otra forma de separar la guía del sujeto de la dirección estética.
Utilice las herramientas de edición para corregir un problema a la vez. Una secuencia útil es:
Este video ofrece una referencia visual para pasar de una idea a un resultado generado:
Para una introducción más sencilla a la interfaz y al flujo de trabajo básico, utilice esta guía sobre ungenerador de imágenes de IA para principiantes. El objetivo no es forzar una referencia a convertirse en un duplicado exacto. Consiste en preservar las decisiones visuales que importan mientras se deja espacio para que una nueva imagen desarrolle sus propios detalles.
El fallo más común es el desorden en las indicaciones. Un creador ve una imagen compleja, anota cada objeto visible, añade varios nombres de estilo y luego adjunta términos de calidad por si acaso. El generador recibe demasiadas prioridades en competencia y produce una imagen que contiene los ingredientes pero pierde el ritmo original.
Cuando un resultado se sienta genérico, no alargue automáticamente la indicación. Elimine primero los adjetivos débiles. «Deslumbrante», «épico» y «de alta calidad» rara vez explican qué hace que la referencia funcione. Reemplácelos con instrucciones observables sobre el encuadre, la luz, la sensación de la lente, la textura y las relaciones espaciales.
Los descriptores contradictorios crean un problema similar. «Collage editorial minimalista maximalista» puede sonar creativamente ambicioso, pero le da al modelo direcciones incompatibles. Elija la lógica visual dominante y luego describa los detalles de apoyo que concuerden con ella.
Compare la imagen generada con la referencia utilizando una lista de verificación fija:
Cambie una categoría por iteración. Si altera la pose, la paleta, la iluminación y el estilo al mismo tiempo, no sabrá qué cambio mejoró el resultado. Elestudio de la ACM sobre optimización de indicacionesdescubrió queentre 100 y 500 iteraciones de optimización pueden ser suficientes para una iteración rápida, y que el recuento de iteraciones y la duración de la optimización no se correlacionaron significativamente con la satisfacción del usuario. Más pruebas no son automáticamente mejores. Las pruebas enfocadas sí lo son.
Las suposiciones legales también pueden crear problemas cuando se realiza ingeniería inversa en una referencia para un trabajo comercial. Una indicación no es un documento mágico de propiedad, y el resultado generado puramente por IA generalmente no es elegible para derechos de autor en los Estados Unidos sin una autoría humana significativa. La edición, composición o disposición humana pueden ser protegibles, así que revise laguía de derechos de autor sobre trabajos generados por IAantes de utilizar un visual recreado con fines comerciales.
El flujo de trabajo confiable es simple: observar, priorizar, generar, comparar y editar. La automatización puede proponer lenguaje, pero el análisis humano deliberado decide qué merece quedarse.
starryai le ofrece un lugar práctico para combinar una imagen cargada con una indicación de texto cuidadosamente extraída, y luego explorar estilos, transformaciones y ediciones sin reconstruir el elemento visual desde cero. Visitestarryaicon una imagen de referencia, anote su sujeto, luz, composición y paleta, y pruebe con una indicación enfocada en lugar de una saturada.


