

Escrito porMo Kahnel
1 de julio de 2026


La IA multimodal es un tipo de inteligencia artificial que puede entender y procesar información de múltiples fuentes a la vez, como texto, imágenes y sonido, de forma similar a como lo hacemos los humanos. Ya es una categoría de mercado real, con una estimación de la industria que valora el mercado global de IA multimodal en1.600 millones de USD en 2024y proyectaalrededor de 27.000 millones de USD para 2034.
Probablemente ya estés sintiendo la brecha que esto resuelve. Escribes un mensaje, obtienes una imagen que se acerca, y luego deseas poder subir también una foto de referencia, describir el ambiente que deseas, tal vez agregar notas de voz y hacer que la herramienta entienda todo eso en conjunto.
Esa es la gran idea detrás de la IA multimodal. No trata la creatividad únicamente como texto. Comienza a funcionar más como un colaborador que puede leer tus palabras, mirar tus referencias y conectar las piezas en una sola respuesta. Para artistas, creadores de contenido, autores independientes, emprendedores y gestores de redes sociales, eso cambia lo que la IA puede hacer en un flujo de trabajo diario.
Muchas herramientas de IA más antiguas se sentían como trabajar con alguien que solo podía leer notas pasadas por debajo de una puerta. Si escribías una instrucción fuerte, podían responder. Pero si querías mostrar una selfie, señalar una paleta de colores y decir "haz que esto se sienta como un póster de fantasía de ensueño", el sistema a menudo no podía combinar bien esas señales.
Es por eso quequé es la IA multimodalimporta para los creadores. Marca un cambio desde los sistemas de entrada única hacia herramientas que pueden trabajar a través detexto, imágenes, audio y videoen lugar de tratar cada formato como un mundo separado.
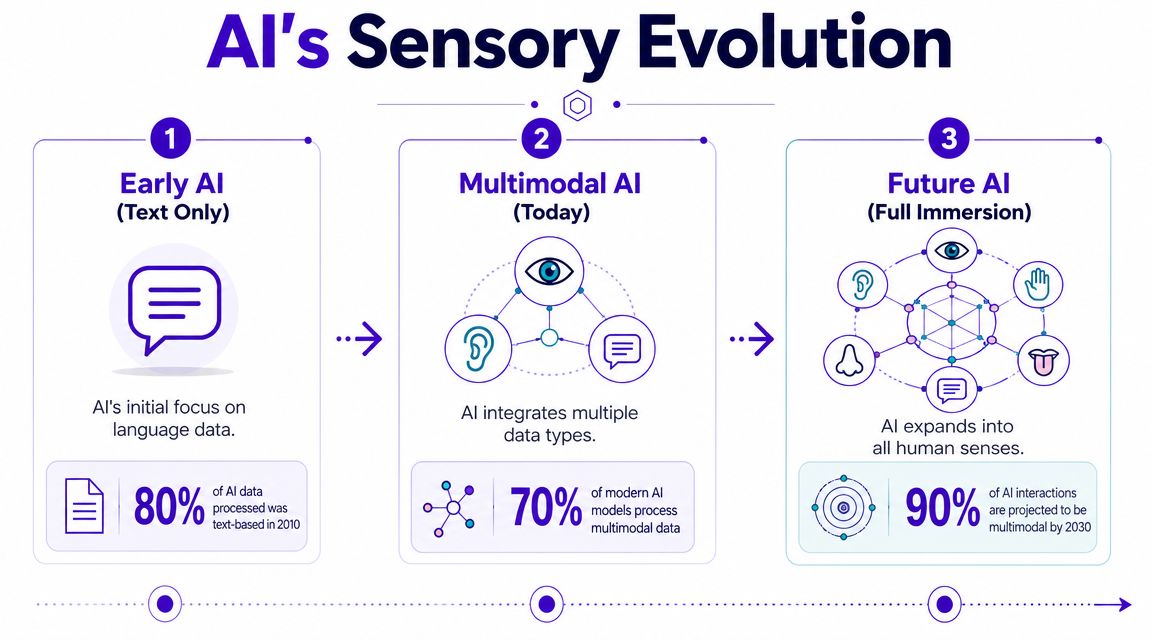
Los creadores rara vez trabajan en un solo formato a la vez. Un concepto para TikTok puede empezar como una idea para un texto, convertirse en un tablero de referencias, transformarse en una voz en off y terminar como un video corto. La portada de un libro puede comenzar con notas de personajes, luego imágenes de inspiración y después experimentos tipográficos.
La IA multimodal se adapta mejor a esa realidad que las herramientas más antiguas porque puede manejar un contexto más rico.
Si quieresoptimizar la producción de video con TTS, el pensamiento multimodal empieza a volverse efectivo. Ya no estás lidiando con tareas aisladas. Estás combinando tipos de medios en un solo sistema creativo.
Regla práctica:Cuanto más dependa tu idea de las relaciones entre palabras, imágenes y sonido, más probable será que la IA multimodal resulte útil en lugar de ser un truco publicitario.
El lado comercial también refleja ese cambio. Una estimación de la industria valora el mercado global de IA multimodal en1.600 millones de USD en 2024y proyecta que alcanzaráalrededor de 27.000 millones de USD para 2034, lo que implica unaTCAC del 32,7%según elanálisis del mercado de IA multimodal de Global Market Insights.
Si ya trabajas con elementos visuales generados por IA, ayuda entender primero el aspecto de las imágenes, especialmente en guías comoqué es una imagen de IA. La IA multimodal se basa en esa fundación y luego añade más sentidos a la conversación.
La forma más sencilla de entender la IA multimodal es comparándola con tu propia percepción. Cuando conoces a un perro, no procesas una sola señal. Ves su forma, escuchas el ladrido, tal vez lees el nombre en una placa, y tu cerebro combina esas pistas en una sola comprensión.
Un sistema de IAunimodalfunciona más como un especialista de un solo sentido. Puede que solo lea texto o solo clasifique imágenes. Un sistemamultimodalpuede conectar varios tipos de entradas y razonar entre ellas.
A menudo los lectores se confunden aquí. Multimodal no significa únicamente “la aplicación acepta archivos subidos”. Muchas herramientas te permiten adjuntar una imagen y pegar texto, pero no necesariamente entienden la relación entre ellos.
Un sistema multimodal hace algo más profundo. Puede mirar una foto, interpretar instrucciones escritas o habladas sobre esa foto y generar una respuesta que refleje ambas entradas juntas.
Ese cambio se convirtió en un hito definitorio en el campo. Las principales descripciones de investigación y de la industria enmarcan la IA multimodal en torno a modelos que procesan conjuntamentetexto, imágenes, audio y video, lo que hizo que la IA pasara de una especialización limitada a sistemas que se asemejan más a la percepción humana, como se explica enla guía de TileDB sobre IA multimodal.
| Tipo | Lo que maneja | Dónde se siente limitada |
|---|---|---|
| IA unimodal | Un tipo de datos a la vez | Puede perder contexto que reside en otro formato |
| IA multimodal | Múltiples tipos de datos juntos | Es más compleja, pero puede producir respuestas más ricas |
Para un creador, esa diferencia es práctica.
La IA multimodal empieza a sentirse útil cuando la relación entre las entradas importa más que cualquier entrada individual por sí sola.
La dirección creativa suele estructurarse en capas. Es posible que quieras "este rostro", "ese estado de ánimo pictórico", "este tono de subtítulo" y "esa energía de banda sonora". Los colaboradores humanos entienden esas combinaciones de forma natural. La IA multimodal intenta hacer algo similar en el software.
Por eso está apareciendo en campos como el diagnóstico médico, los vehículos autónomos, la moderación de contenido, el servicio al cliente y la robótica en el mercado en general. Para los creadores, la conclusión es más sencilla. La IA está mejorando en el contexto, y el contexto es donde habita el estilo.
Bajo el capó, la IA multimodal es menos magia y más coreografía. Piénsalo como un pequeño equipo de traductores trabajando tras el telón.
Un traductor entiende el texto. Otro entiende las imágenes. Otro maneja el audio. Cada especialista toma un tipo diferente de entrada sin procesar y la convierte en una forma que el sistema pueda comparar y combinar.
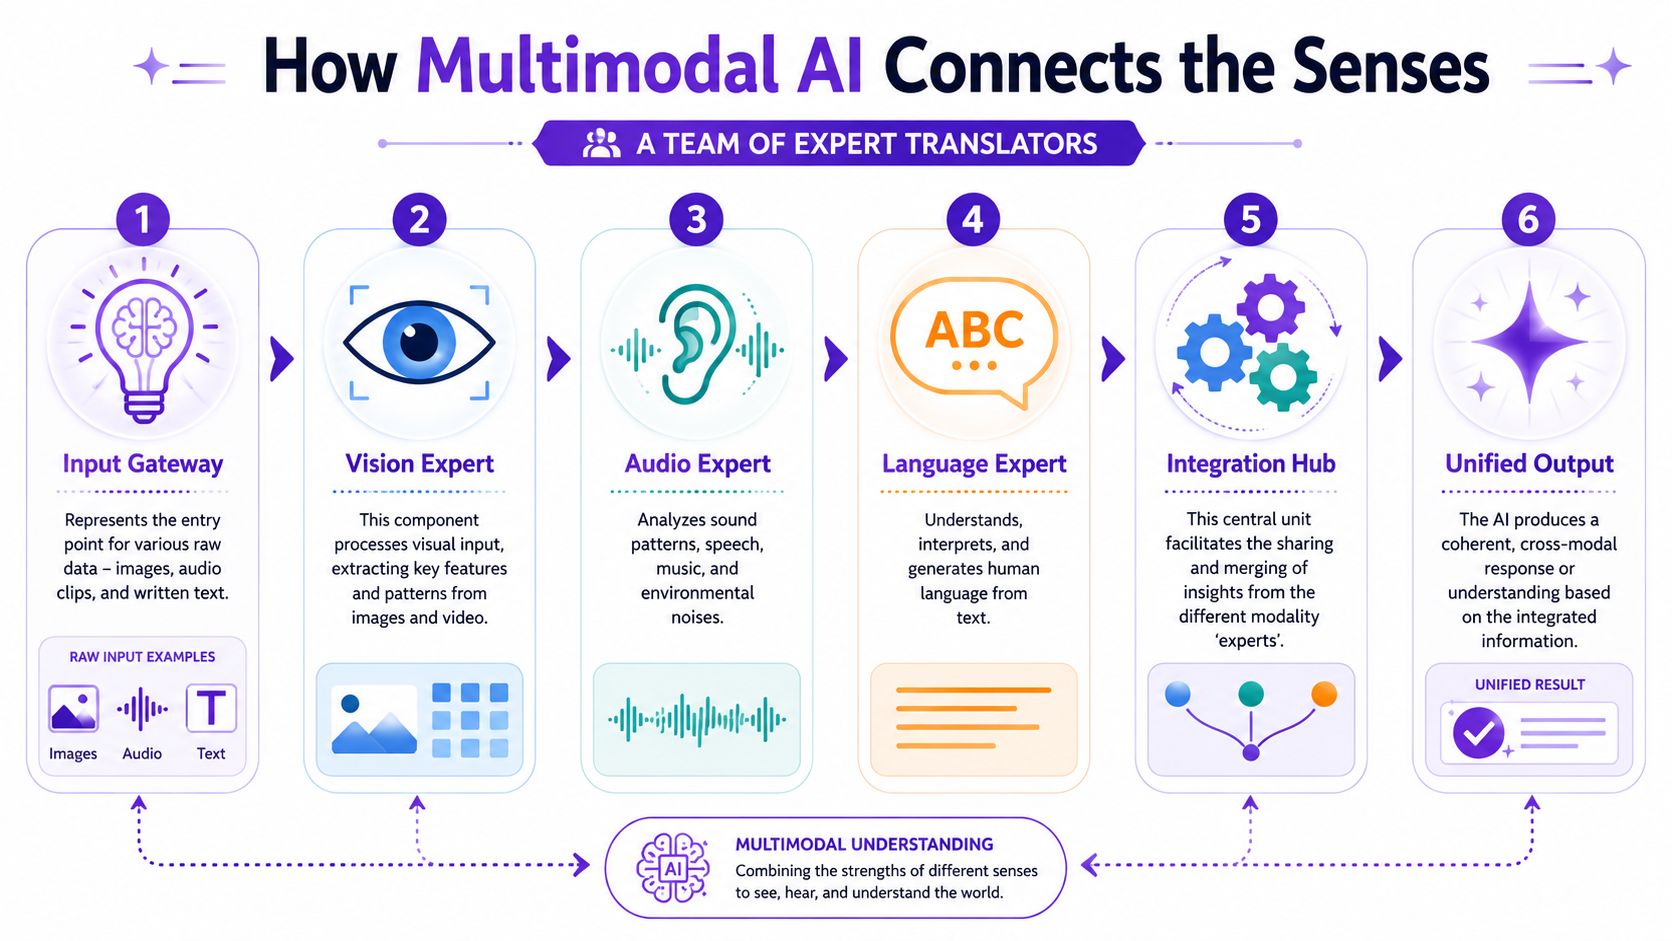
Una arquitectura multimodal común incluye unmódulo de entrada, unmódulo de fusióny unmódulo de salida. En términos más técnicos, estos sistemas suelen construirse a partir decodificadores específicos de modalidadademás de unacapa de fusiónque mapea texto, imágenes, audio o video en un espacio de incrustación compartido, como se describe en el artículo explicativo de McKinsey sobre IA multimodal.
Aquí está la versión en un lenguaje sencillo:
Entrada
Diferentes codificadores manejan diferentes medios. El texto se divide en tokens. Las imágenes se redimensionan y codifican. El audio a menudo se transforma en características que el modelo puede interpretar.
Fusión
Este es el paso intermedio esencial. El sistema mapea esas diferentes entradas en un espacio compartido para poder comparar el significado entre formatos.
Salida
Un modelo posterior produce la respuesta. Esa respuesta podría ser texto, una imagen, instrucciones, una clasificación u otro resultado generado.
Sin la fusión, la IA multimodal sería solo un montón de especialistas separados. La capa de fusión es lo que permite que el sistema conecte tu instrucción con tu imagen en lugar de tratarlas como archivos no relacionados.
Eso es lo que permite el razonamiento cruzado entre modalidades. Un modelo puede usar una imagen y una instrucción de texto juntas para responder a una pregunta o generar una respuesta que refleje a ambas.
Piensa en la capa de fusión como la mesa de reuniones donde cada especialista trae notas en el mismo idioma.
Esta idea de espacio compartido también explica por qué la tecnología puede admitir salidas flexibles. Una vez que las diferentes modalidades se incrustan en la misma representación de alta dimensión, el modelo puede admitirgeneración de cualquier cosa a cualquier cosa, lo que significa que puede aceptar una o más modalidades y producir otra modalidad como salida, según Milvus sobre los requisitos computacionales multimodales.
Si subes un retrato y añades "convierte esto en un póster ciberpunk de neón", el sistema no se limita a apilar una instrucción sobre un archivo. Está intentando alinear las características visuales del retrato con el significado semántico de la instrucción antes de generar el resultado.
Es por eso que algunos resultados se sienten extrañamente fieles al encargo, mientras que otros se desvían. El modelo tiene que alinear múltiples señales correctamente.
Si deseas una base más amplia sobre el ecosistema que rodea a estos sistemas,modelos de IA generativa explicadoses una lectura complementaria útil. Los modelos generativos crean el resultado. El diseño multimodal les ayuda a comprender una combinación más amplia de entradas antes de hacerlo.
La forma más rápida de entender la IA multimodal es usarla para algo que ya te importa. Para los creadores, eso suele significar identidad, estilo, velocidad o narrativa.
Este es uno de los casos de uso más claros para creadores. Comienzas con una imagen tuya y luego agregas texto que dirige la transformación.
Una instrucción como "convierte este retrato en un montaraz élfico iluminado por la luna con armadura de plata e iluminación pictórica" le da al modelo dos cosas a la vez: pistas de identidad de la foto y pistas de estilo del lenguaje. El resultado puede funcionar como un avatar, una actualización de perfil, un concepto de póster o arte de fandom.
Para este tipo de flujo de trabajo, herramientas comostarryai texto a imagenson relevantes porque admiten la creación de imágenes basada en instrucciones y se adaptan a los creadores que desean resultados visuales sin una configuración técnica.
A veces el objetivo no es "hazme lucir diferente". Es "haz que esta idea se parezca más a esa estética".
Eso podría significar subir una imagen de estado de ánimo y escribir una instrucción que especifique el tono, la paleta o el género. Un creador que vende impresiones en Etsy podría usar esto para probar direcciones para colecciones de estilo cottagecore, ciencia ficción retro o academia oscura. Un autor independiente podría usar el mismo patrón para conceptos de personajes o exploración de portadas.
Si estás en el mundo editorial, esta guía sobreselección de generadores de IA para autopublicadoreses útil porque enmarca la elección de herramientas en torno a flujos de trabajo reales de portadas y conceptos en lugar de la exageración abstracta de la IA.
La IA multimodal no solo genera. También puede interpretar.
Puedes introducir una imagen y solicitar:
Eso es útil cuando te atascas al nombrar, publicar o perfeccionar una idea que puedes ver pero que aún no has articulado.
Una breve demostración hace que esto sea más concreto:
Para los creadores de videos de formato corto, el salto interesante es combinar guion, elementos visuales y voz. Un concepto puede comenzar como un gancho escrito, convertirse en imágenes generadas y luego incorporar narración o diseño de sonido.
Eso no significa que todos los creadores necesiten una infraestructura de producción completa. Significa que la barrera entre "escribir", "diseñar" y "editar" se está reduciendo. La misma idea central ahora puede moverse de manera más fluida entre formatos, razón por la cual la IA multimodal resulta especialmente natural para TikTok, reels, tráileres y la narración visual.
Un buen comando creativo ya no tiene que cargar con todo el trabajo por sí solo. Los medios de referencia ahora pueden compartir la carga.
La IA multimodal abre nuevas puertas creativas, pero también eleva el costo de hacer las cosas bien. Estos sistemas son más exigentes que los modelos de una sola entrada porque deben procesar varios flujos de información y alinearlos de forma coherente.
En comparación con los sistemas unimodales, los modelos multimodales requierensustancialmente más capacidad de cálculo y memoriaporque deben procesar múltiples codificadores y mantener arquitecturas más grandes. Eso aumenta la latencia y eleva la demanda de entrenamiento e inferencia, como se señala en la referencia de Milvus vinculada anteriormente.
Cuando un sistema puede combinar imagen, texto, audio y video, también se puede utilizar para hacer que el contenido engañoso sea más convincente. Eso incluye imágenes falsas, contenido de voz manipulado o publicaciones de medios mixtos diseñadas para parecer auténticas.
El sesgo es otra preocupación. Si el material de entrenamiento contiene representaciones sesgadas, el modelo puede transmitir esos patrones a través de múltiples formatos a la vez en lugar de hacerlo en un solo canal.
Una forma fundamentada de usar la IA multimodal es sencilla:
Los creadores no necesitan temer a la tecnología. Sí necesitan usarla con criterio.
No.La IA generativadescribe sistemas que crean resultados como imágenes, texto, audio o video.IA multimodaldescribe sistemas que pueden comprender o trabajar con múltiples tipos de entrada. Algunas herramientas son ambas cosas. Otras son solo una.
Una aplicación de texto a imagen puede ser generativa. Un sistema que analiza una imagen, lee tu comando y luego genera un resultado es tanto generativo como multimodal.
Sí. No necesitas construir modelos ni entender matemáticas de aprendizaje automático para empezar. La mayoría de los principiantes pueden aprender el concepto probando flujos de trabajo simples, como subir una foto, añadir un comando y comparar resultados.
Empieza con experimentos pequeños:
Reduce la brecha entre la idea en tu cabeza y los materiales que ya tienes. En lugar de forzar todo en texto, puedes combinar referencias, lenguaje y, a veces, sonido o movimiento.
Eso es especialmente útil para los creadores que piensan primero de forma visual o que construyen a través de plataformas donde un único concepto necesita convertirse en una publicación, una miniatura, una portada, una voz en off o un video corto.
La dirección probable es una interacción más natural. Los creadores trabajarán cada vez más con herramientas que puedan aceptar entradas mixtas en un solo flujo, y luego devolver resultados que parezcan más conscientes del contexto.
El cambio importante no es solo una mejor calidad. Es una mejor colaboración entre tu intención y los medios que proporcionas.
Si quieres probar ese tipo de flujo de trabajo por ti mismo,starryaies una opción para convertir indicaciones, selfies e ideas visuales en imágenes generadas por IA sin necesidad de una configuración técnica.


