

Écrit parMo Kahnle
26 juillet 2026


Vous en êtes probablement au point où vos prompts sont corrects, vos idées sont solides, et les résultats semblent encore un peu trop génériques. Peut-être que le héros de votre roman indépendant ressemble toujours à un personnage de fantaisie générique, ou que vos maquettes Etsy ont toutes tendance vers la même esthétique fade, peu importe la précision de la formulation de votre prompt. C'est généralement le moment où l'entraînement de modèles d'IA personnalisés commence à ressembler moins à une curiosité technique qu'à une décision créative que vous devez maîtriser.
Un auteur indépendant souhaite qu'un personnage récurrent ait la même apparence sur une couverture, une image promotionnelle et une carte de personnage. Un vendeur Etsy souhaite une gamme de produits dérivés qui ne ressemble pas à la même esthétique d'Internet que tout le monde utilise. Dans les deux cas, la question n'est pas « l'IA peut-elle aider », mais « quelle voie correspond à la tâche ».
Il y a quatre options réelles.Les modèles prêts à l'emploiconstituent le point de départ le plus rapide et le moins cher, et ils suffisent lorsque le résultat n'a pas besoin d'une identité strictement contrôlée.La personnalisation basée sur la recherche d'informationsfonctionne lorsque l'assistant doit répondre à partir de fichiers approuvés, de sites Web ou de sources cloud au lieu de modifier le modèle lui-même, ce qui correspond souvent à la signification par défaut de « s'entraîner sur vos données » dans les environnements professionnelsl'entraînement et la recherche de GPT personnalisés. Le fine-tuningajuste un modèle préentraîné existant pour une voix de marque, un style visuel ou un schéma spécifique à une tâche.L'entraînement à partir de zéroest la voie la plus lourde, et la plupart des créateurs n'en ont pas besoin.
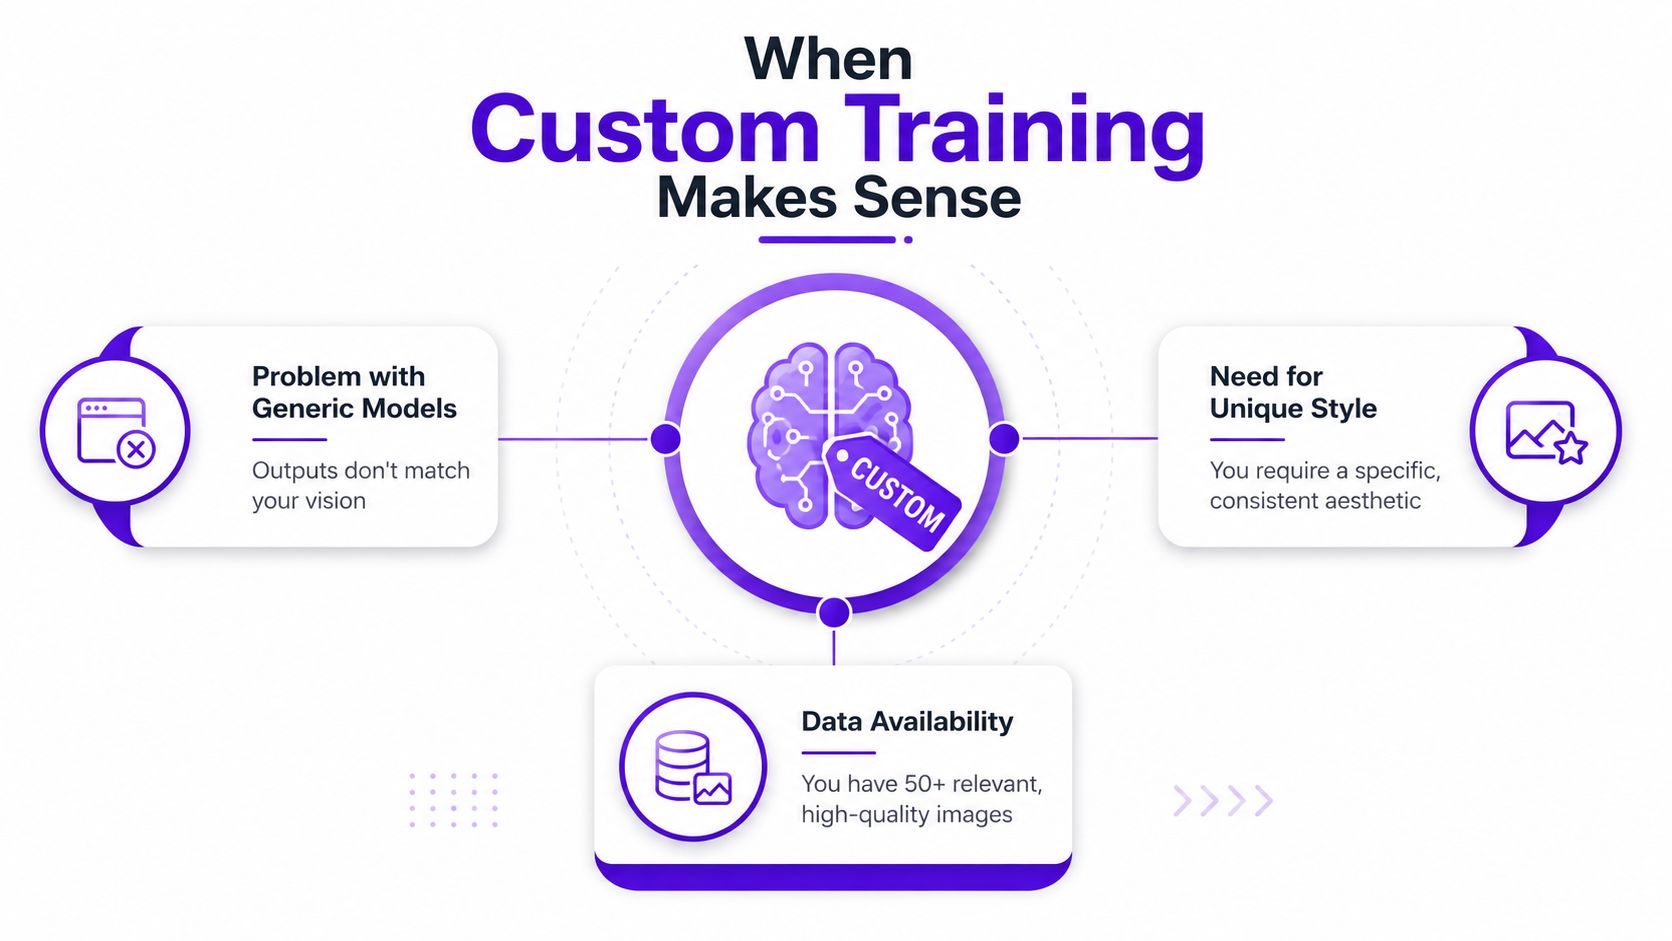
Règle pratique :n'effectuez un entraînement personnalisé que lorsque le résultat générique continue de rater votre domaine, que votre volume d'inférence mensuel est suffisamment élevé pour justifier le travail supplémentaire, ou que vos exigences de latence et de cohérence de marque sont strictes.
Un repère historique utile estBERT en 2018, qui a contribué à normaliser le fine-tuning spécifique à une tâche par-dessus les modèles de fondation préentraînés. Les travaux originaux de Google sur BERT ont rapportédes résultats de pointe sur 11 tâches NLP, incluant un bond de90,9 % à 94,9 %sur lebenchmark GLUEà l'époque, montrant comment des modèles adaptés pouvaient surpasser les approches génériques lorsqu'ils étaient réglés pour une tâche spécifiqueAperçu d'Oracle sur l'entraînement des modèles d'IA. C'est ce même changement qui permet aujourd'hui à de petites équipes de personnaliser un modèle au lieu d'en construire un à partir de zéro.
Une vérification mentale rapide aide :
L'ensemble de données détermine généralement si votre modèle semble soigné ou bizarrement décalé. C'est particulièrement vrai pour les flux de travail des créateurs, où une seule image floue, une légende mal étiquetée ou une référence dupliquée peut orienter le résultat vers la monotonie plutôt que vers le style.
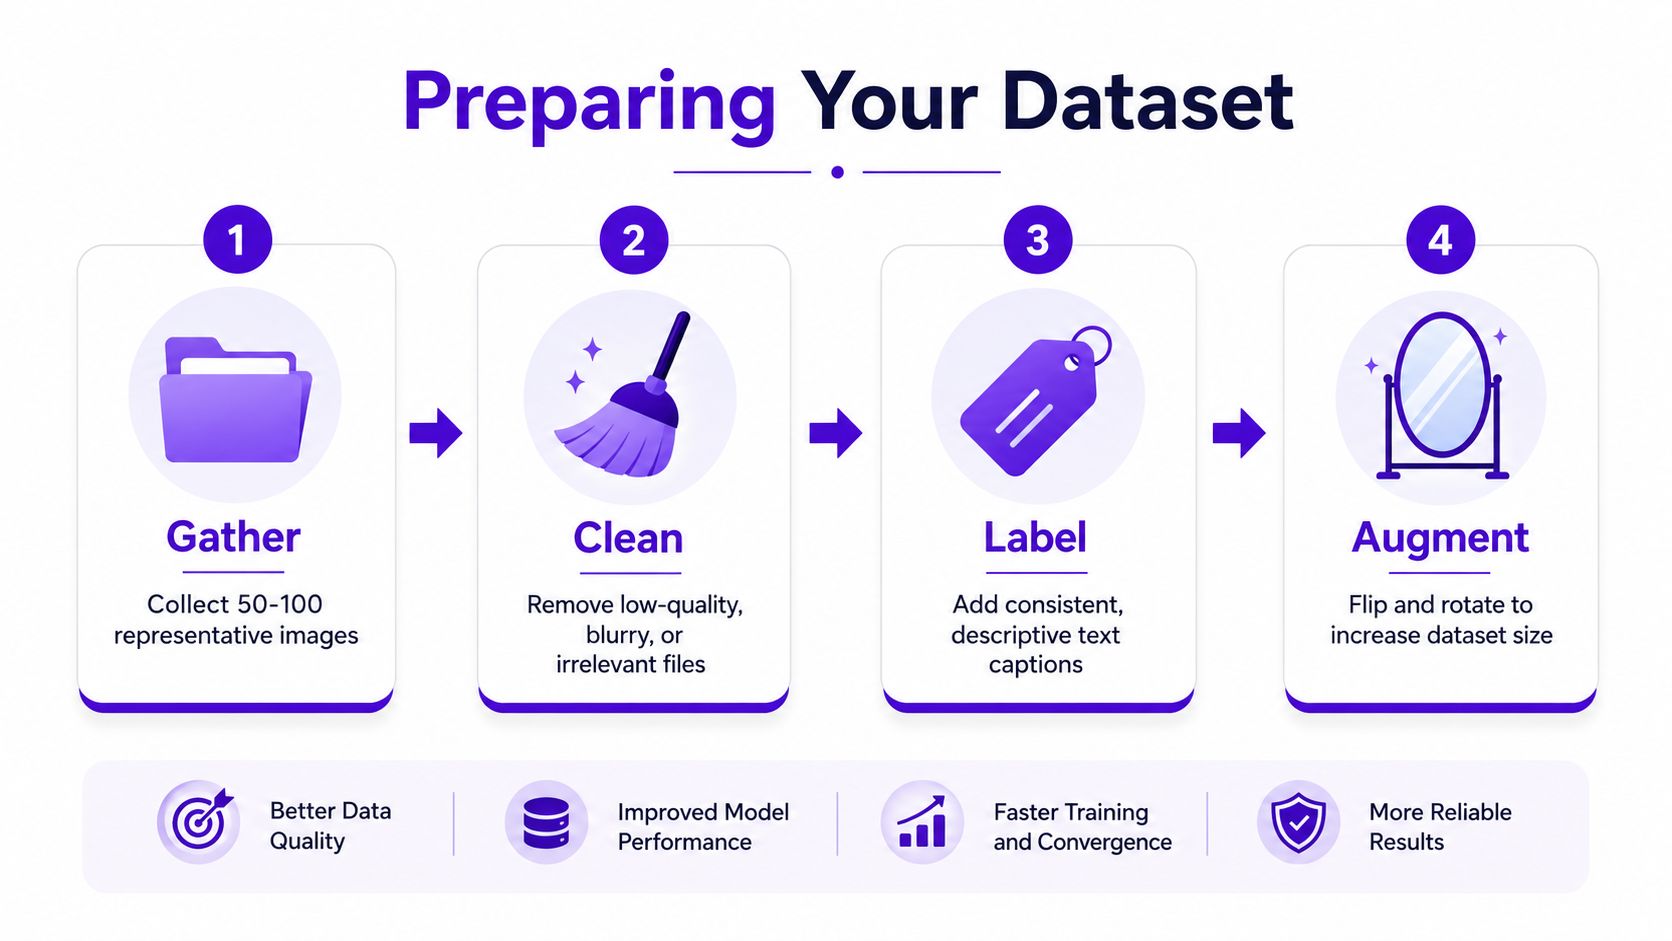
Commencez par rassembler uniquement les images ou le texte qui appartiennent au modèle. Un ensemble ciblé l'emporte sur un vaste ensemble de documents de référence mélangés, car le modèle apprend le modèle que vous lui montrez le plus souvent. Pour le travail d'image de créateur, un point de départ pratique est12 à 20 imagesavec des légendes, et le matériel source recommande également unminimum de 10 imageslorsque des légendes sont inclusesconfiguration de l'entraînement des images.
Ensuite, nettoyez rigoureusement l'ensemble. Supprimez les doublons, les fichiers de faible qualité, les valeurs aberrantes non pertinentes et les légendes cassées. La raison est simple : le modèle ne peut pas faire la distinction entre « important » et « accidentel » à moins que vos données ne fassent déjà ce travail pour lui. La structure la plus claire reste la division classique,70 à 80 %pour l'entraînement,10 à 15 %pour la validation, et10 à 15 %pour les testsrecommandations sur la division des ensembles de données.
Votre ensemble de validation compte plus que beaucoup de débutants ne le pensent. La perte d'entraînement peut continuer à diminuer tandis que la perte de validation commence à dériver vers le haut, et cet écart est le premier signe de surapprentissage. Si le modèle mémorise votre ensemble de données au lieu d'apprendre le style, vous obtiendrez généralement des exemples d'entraînement superbes et des résultats nouveaux décevants.
L'aspect le plus opérationnel concerne le biais et la couverture. Un modèle de créateur doit inclure des variations dans la pose, l'éclairage, l'angle, l'arrière-plan et le cadrage afin que le résultat ne se bloque pas sur un seul look restreint. Une référence de flux de travail interne que de nombreuses équipes utilisent pour l'organisation des ensembles de données estle guide de gestion des collections, car le problème consiste souvent moins à générer des images qu'à garder la bibliothèque source suffisamment propre pour s'entraîner à partir de celle-ci.
Gardez une note à côté de chaque ensemble de données : d'où il vient, ce que vous avez supprimé et pourquoi vous avez gardé les exemples finaux. Cet enregistrement permet d'économiser des heures plus tard lorsqu'un modèle se comporte bizarrement et que vous devez en retrouver la cause.
Les créateurs n'ont généralement pas besoin de la méthode la plus lourde possible. Ils ont besoin de la méthode qui préserve le style qui les intéresse sans engloutir de temps, de puissance de calcul ou leur santé mentale. C'est pourquoi le bon choix dépend du fait que vous essayez d'enseigner au modèle un comportement complet, un style léger ou simplement un mot déclencheur pour un concept visuel.
| Méthode | Données nécessaires | Temps d'entraînement | Idéal pour |
|---|---|---|---|
| Réglage fin | Exemples plus curatés, couverture plus large | Plus long | Voix de marque, spécialisation des tâches, changements de comportement plus profonds |
| LoRA | Ensemble de données modéré et ciblé | Plus court | Personnages, styles, visuels de créateurs, itérations rapides |
| Inversion textuelle | Petit ensemble de concepts | Le plus court | Nouveaux jetons, indices de style simples, déclencheurs visuels étroits |
Le fine-tuningmodifie une plus grande partie du comportement du modèle, c'est donc l'option la plus lourde lorsque vous avez besoin d'une adaptation plus profonde. C'est utile lorsque le modèle sous-jacent continue de rater le domaine, mais cela demande également plus de vos données et de votre patience. Un bon point de départ pour comprendre conceptuellement les flux de travail de style diffusion est l'explication plus large surBases de l'entraînement de Stable Diffusion, car de nombreux créateurs d'images découvrent d'abord ces méthodes au sein de cet écosystème.
LoRAest l'option vers laquelle de nombreux créateurs se tournent naturellement. Elle est plus légère, plus rapide et plus facile à itérer lorsque vous entraînez le visage d'un personnage, un avatar récurrent ou une esthétique de couverture distincte. Elle vous donne généralement suffisamment de contrôle pour verrouiller un style sans forcer une réécriture complète du modèle.
L'inversion textuelleest la méthode la plus délicate. Elle fonctionne mieux lorsque vous avez simplement besoin d'un jeton qui évoque de manière fiable une idée visuelle spécifique. Si votre objectif est de « faire en sorte que celui-ci ressemble à ma mascotte de dragon originale », cela peut suffire. Si votre objectif est de « faire comprendre à mon modèle l'ensemble de mon système de marque », ce n'est généralement pas le cas.
Si l'objectif est un personnage reproductible, commencez par la méthode la plus légère qui vous y conduise. Passer directement à un réglage fin complet (fine-tuning) ajoute souvent de la complexité avant d'ajouter de la qualité.
Une règle de décision simple fonctionne bien. Choisissezl'inversion textuellepour un concept restreint,LoRApour la plupart des travaux de style ou de personnages orientés créateur, etle réglage fin (fine-tuning)lorsque vous avez besoin d'un contrôle comportemental plus large et que vous possédez déjà la discipline de jeu de données nécessaire pour le soutenir.
Un premier entraînement est moins dramatique que les gens ne le pensent. Vous ne « lancez pas un modèle magique », vous testez si votre jeu de données, vos légendes (captions) et vos paramètres peuvent orienter le résultat dans la bonne direction sans altérer la cohérence du style.
Commencez par un modèle de base qui ressemble déjà à votre cas d'utilisation cible. Pour un personnage de série de livres fantastiques, cela signifie généralement une fondation visuellement cohérente plutôt que la plus générale disponible. Définissez un taux d'apprentissage conservateur afin que le modèle ne dépasse pas le style que vous essayez de lui enseigner. S'il est trop agressif, les résultats deviennent souvent fragiles ou sur-entraînés (overfit) rapidement.
Utilisez la création de points de contrôle (checkpointing) après chaque époque. Cela vous donne un point de restauration lorsque le modèle commence à dériver et facilite grandement la comparaison côte à côte. Le flux de travail pratique décrit dans le matériel source recommande égalementla validation basée sur des trancheset les ablations, ce qui signifie vérifier de petits sous-ensembles d'images ou de légendes pour voir quel composant aideguide du flux de travail d'entraînement.
Une boucle simple de type créateur ressemble à ceci :
Une augmentation simple aide, mais elle ne doit pas prendre le pas sur l'identité du jeu de données. Les inversions, les recadrages modestes et les légers ajustements de couleurs peuvent améliorer la force. Une forte distorsion nuit généralement à la fidélité du style, en particulier lorsque l'objectif d'entraînement est un visage, une tenue ou un look de marque reconnaissable.
Si le modèle est superbe sur les exemples d'entraînement mais commence à aplatir les visages ou à répéter des artefacts d'arrière-plan sur de nouvelles invites, arrêtez l'exécution et inspectez les légendes avant d'ajouter d'autres époques.
Pour un premier essai, la question la plus utile n'est pas « est-ce que ça a entraîné », mais « est-ce que cela a amélioré le type de résultat dont j'ai besoin ». C'est la différence entre un travail techniquement réussi et un outil de création utile.
L'entraînement personnalisé devient coûteux lorsque les gens sautent l'étape de planification. Un créateur n'a pas besoin d'une équipe financière, mais il a besoin d'une idée approximative du moment où une configuration personnalisée cesse d'être une expérience amusante pour devenir une décision d'infrastructure récurrente.
Un guide estime que l'entraînement personnalisé devient économiquement attractif au-delà d'environ5 à 10 millions d'appels par mois, ou lorsque la latence doit rester inférieure à50 ms guide d'entraînement de modèle personnalisé. Pour la plupart des créateurs, cela va bien au-delà d'un flux de travail typique de couverture de livre ou d'avatar. Une API hébergée ou un flux de travail personnalisé léger dans starryai est généralement beaucoup plus facile à justifier à plus petite échelle.
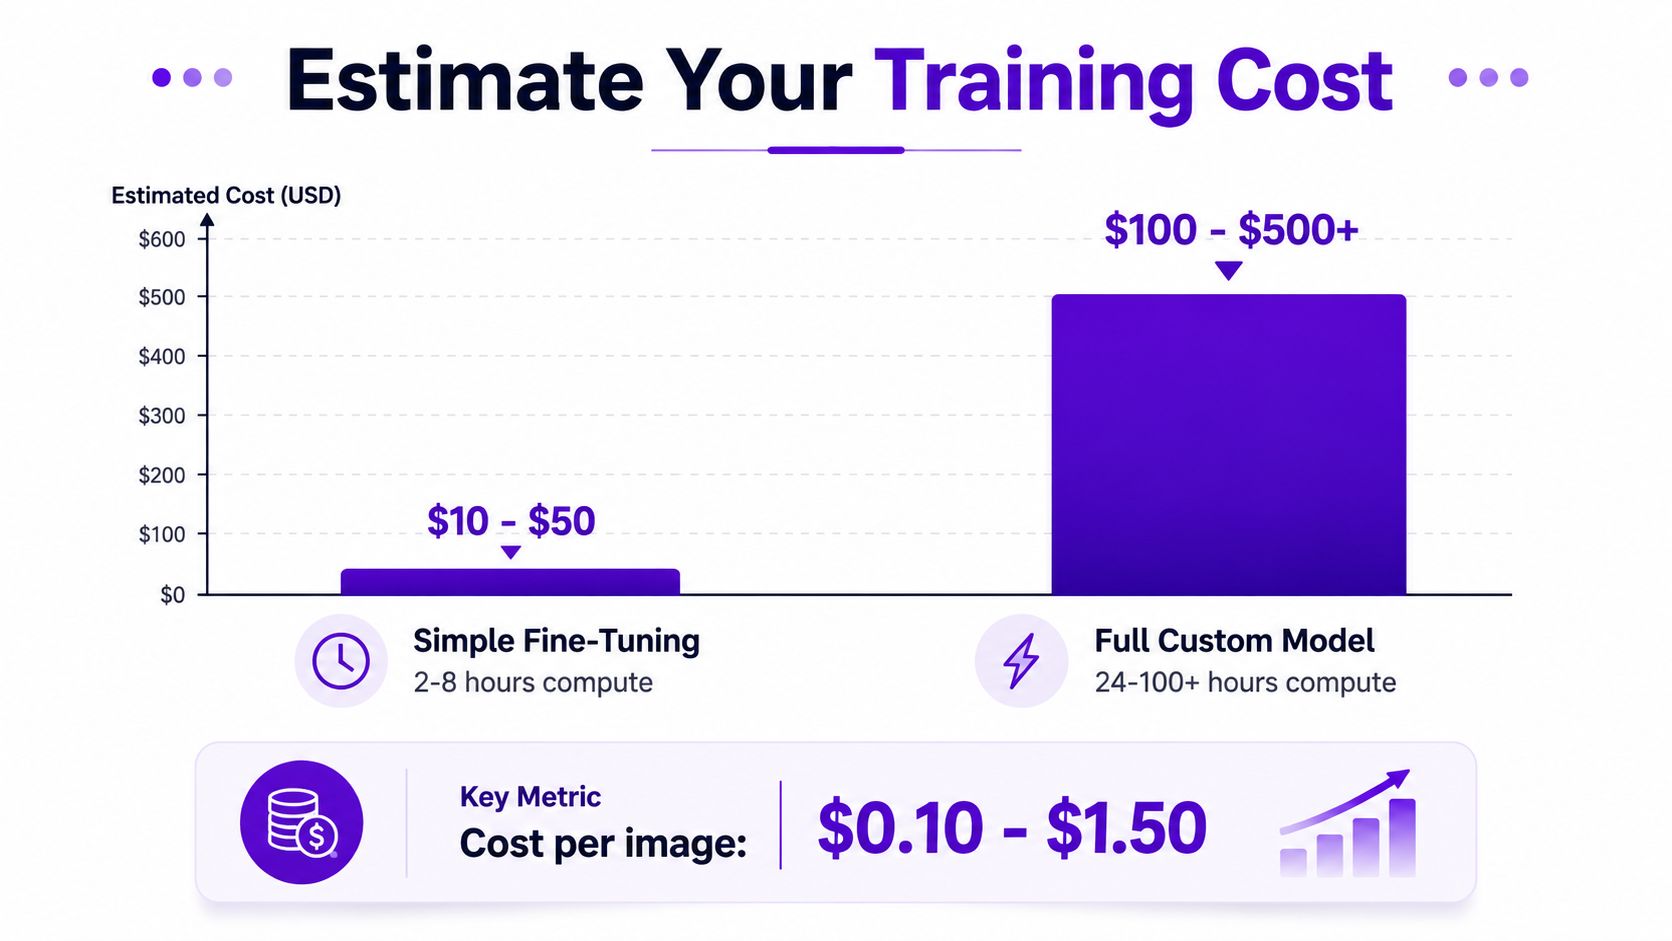
Une façon pratique de penser aux dépenses est par niveau :
| Niveau d'entraînement | Sensation de calcul typique | Résultat attendu | Adéquation pour le créateur |
|---|---|---|---|
| Léger | Une courte exécution avec un jeu de données restreint | Alignement du style ou du concept | Avatars, concepts de mascottes, graphismes de produits dérivés simples |
| Moyen | Plus d'itérations et de comparaisons de points de contrôle | Apparence de personnage ou de marque plus cohérente | Couvertures de livres indépendants, visuels de produits récurrents |
| Lourd | De nombreux cycles d'expérimentation et un réglage plus précis | Contrôle de modèle plus approfondi | Équipes ayant des besoins stricts en matière de latence, de domaine ou d'échelle |
Le matériel source note également uncoût par image pratique de 0,10 $ à 1,50 $dans le contexte d'entraînement présenté dans son graphiquegraphique d'estimation des coûts. Ce n'est pas une formule de facture universelle, mais c'est un point de repère utile pour la planification lorsque vous décidez de former un concept ou cinq.
Si vous expérimentez chez vous, l'entraînement local sur un GPU grand public peut suffire pour de petits tests. Les plateformes hébergées sont préférables lorsque vous souhaitez un temps de configuration plus court et moins de problèmes d'environnement. La question n'est pas de savoir « ce qui est le moins cher en théorie », mais « ce qui me permet d'obtenir un résultat utilisable sans gaspiller une semaine en configuration ».
Prévoyez un budget pour l'itération, et pas seulement pour le premier essai. La plupart des modèles utiles arrivent après avoir comparé quelques petits essais au lieu de tout miser sur une seule passe géante.
Un modèle peut sembler superbe et rester inutilisable si les données d'entraînement ont été collectées sans soin. C'est la partie que de nombreux créateurs sous-estiment, en particulier lorsqu'ils prévoient de vendre des impressions, des couvertures, des packs d'avatars ou des produits dérivés basés sur le résultat.
La règle d'or est de respecter les conditions d'utilisation relatives audroit d'auteur, aux conditions d'utilisationet auxréglementations sur la protection de la vie privéelors de la collecte de contenu Web. Les conseils du CIO recommandent également de conserver des dossiers détaillés sur les sources et le prétraitement, ainsi qu'une validation rigoureuse, la déduplication, le nettoyage et des audits réguliers pour réduire les biaisle CIO sur la gouvernance des données d'entraînement. Ce ne sont pas des points d'éthique abstraits, ce sont des contrôles opérationnels.
Vous devez également séparer la licence du modèle de base des droits relatifs à votre résultat entraîné. Un modèle affiné n'hérite pas automatiquement de toutes les autorisations commerciales attachées au modèle de fondation, et les entreprises de créateurs se font souvent avoir en supposant le contraire. Si vous n'êtes pas sûr de ce qu'une plateforme autorise, lesconditions de licence de starryaidoivent être vérifiées avant d'expédier du travail payant.
Pour les ressemblances et les personnages de fans, le consentement est important. Si votre modèle apprend à connaître une personne reconnaissable, ou si vous vous entraînez autour de la conception d'un personnage protégé appartenant à quelqu'un d'autre, vous devez considérer cela comme une question de droits, et non seulement comme un choix esthétique. C'est particulièrement important lorsque le résultat est destiné à la vente.
Les contrôles des biais sont également pratiques. Recherchez des distorsions systématiques dans le genre, l'âge, le teint de la peau, le type de corps ou les indices culturels dans l'ensemble de vos résultats. Si un groupe continue d'être cadré de la même manière, le jeu de données dit probablement au modèle de le faire, même si ce n'était pas votre intention.
Une liste de contrôle rapide des droits est utile :
Pour une perspective politique plus large, les mêmes préoccupations d'équité apparaissent également dans d'autres systèmes d'IA, y comprisl'équité dans le recrutement alimenté par l'IA. La catégorie est différente, mais la leçon est la même : si les données sont biaisées, le résultat le sera aussi.
L'entraînement n'est que la moitié du travail. Un modèle qui ne vit que dans un bloc-notes ou un cycle d'entraînement n'aide pas un auteur, un vendeur ou un créateur social à expédier quoi que ce soit.
L'évaluation doit commencer visuellement. Comparez les résultats côte à côte, utilisez des balayages d'invites et demandez à quelques vrais utilisateurs quels résultats semblent les plus proches du look souhaité. Pour les projets de créateurs, ce type d'examen permet de détecter les erreurs que les mesures numériques peuvent manquer, en particulier lorsque le résultat doit être fidèle à la marque plutôt que simplement techniquement valide.
Après cela, optimisez pour la manière dont le modèle sera utilisé.La quantificationpeut réduire la taille du fichier et aider avec les limites de mémoire.La distillationpeut accélérer l'inférence. L'ingénierie des invites reste également importante, car un modèle bien entraîné peut donner de piètres résultats si l'invite ignore la manière dont il a été conditionné.
Une séquence de déploiement qui fonctionne en pratique ressemble à ceci :
Les flux de travail des créateurs incluent souvent des avatars personnalisés, des couvertures de livres et des visuels pour les réseaux sociaux. Par conséquent, une plateforme qui prend déjà en charge ces tâches peut faire gagner un temps précieux. starryai proposel'entraînement de styles, ce qui permet aux utilisateurs de télécharger5 à 60 imagesd'un style, d'un objet ou d'une esthétique cohérents pour entraîner un modèle de style personnalisé. Cela en fait une option pratique lorsque l'objectif est d'obtenir un rendu reproductible plutôt qu'un projet d'ingénierie complexe.
La surveillance est essentielle après le lancement. Vérifiez la dérive de la précision, les cas limites inhabituels et les variations de qualité au fur et à mesure que vous soumettez de nouvelles instructions au modèle. Si les résultats commencent à se dégrader, un petit ensemble sélectionné d'exemples difficiles est généralement plus utile que de tout recommencer à zéro.
Le modèle n'est jamais « terminé ». Il ne reste utile que si vous continuez à comparer les résultats avec le style que vous souhaitez réellement obtenir.
Si vous êtes prêt à transformer une idée visuelle brute en un rendu reproductible, commencez parstarryai, testez un ensemble de styles ciblés et voyez si votre projet s'intègre dans un flux de travail de créateur léger avant de vous engager dans une voie d'entraînement plus lourde.


