

Écrit parMo Kahnle


L'IA texte-vers-image ne va pas chercher une photo enregistrée : un encodeur de texte transforme votre invite en chiffres, puis un débruitage répété transforme le bruit aléatoire en une image guidée par ces chiffres. La diffusion latente, introduite par des recherches influentes en 2022, rend ce processus plus efficace en travaillant avec une représentation compressée au lieu de chaque pixel.
Le conseil populaire « écris simplement une meilleure invite » rate une partie du tableau. Vos mots guident une supposition itérative, et non une recherche directe ou un collage, de sorte que le résultat peut prendre du temps, changer d'une exécution à l'autre, ou se tromper sur les mains, le nombre d'objets et le lettrage. Comprendre les étapes vous aide à rédiger des invites plus claires et à décider quoi corriger lorsqu'une génération échoue.
Une application texte-vers-image ne récupère pas une image finie et n'assemble pas un collage à partir de vos mots. Elle utilise votre invite pour guider une série de suppositions, en commençant par un bruit aléatoire et en le façonnant progressivement en une image. Larecherche de 2022 sur la diffusion latente et le processus de génération d'imagesdécrit comment ce processus passe du bruit à une image qui correspond à l'invite.
| Étape | Ce que fait le modèle | Ce que vous voyez |
|---|---|---|
| Encodage du texte | Un encodeur de langage transforme l'invite en incorporations numériques | Rien de visible pour l'instant |
| Début du bruit | La génération commence à partir d'un bruit gaussien aléatoire | Un parasite gris sans objets |
| Débruitage précoce | Les premières étapes définissent la forme globale, les objets et la disposition | Une composition floue |
| Débruitage tardif | Les étapes ultérieures ajoutent de la couleur, de la texture et des détails fins | Des surfaces et des bords plus nets |
| Décodage | Un décodeur transforme la représentation latente en pixels | L'image finale |
Les étapes expliquent pourquoi un aperçu précoce peut sembler flou tout en montrant la disposition de la scène. L'encodage de texte prépare des instructions numériques, tandis que le bruit initial ne contient aucun objet reconnaissable. Le débruitage précoce établit la composition générale ; les étapes ultérieures affinent principalement les couleurs, les surfaces et les contours.
Le guidage textueldécrit à quel point l'invite (le prompt) oriente le débruitage. Certaines applications exposent cela sous forme d'échelle de guidage (guidance scale). Un paramètre plus élevé rapproche le résultat de la formulation, bien qu'il puisse donner à l'image un aspect brut ou rigide. Un paramètre plus bas laisse à la génération plus de liberté pour dériver. L'invite définit la cible ; le paramètre de guidage affecte la fermeté avec laquelle le processus la suit.
Débruiter chaque pixel directement nécessiterait davantage de calculs et de mémoire. La diffusion latente compresse d'abord une image en une représentation plus petite, y exécute le débruitage, puis décode le résultat en pixels. Cela rend plus pratique la génération d'images à plus haute résolution sans avoir à affiner chaque pixel tout au long du processus.
Vous pouvez lire un aperçu comme un travail en cours : observez d'abord la composition, puis vérifiez si les détails apparaissent à mesure que l'image devient plus nette. L'assistance de l'IA pour la recherche universitaire est un autre exemple d'IA soutenant un processus de travail étape par étape.
Les paires d'entraînement sont des leçons, et non une étagère d'images finies attendant que l'application les copie. Chaque paire relie un exemple visuel à des mots qui le décrivent, aidant un modèle à apprendre des associations entre le langage et les motifs visuels. Ces associations peuvent inclure un sujet, ses attributs, l'agencement d'une scène et un style visuel.
L'échelle des données d'entraînement a son importance, mais la qualité de leurs légendes aussi. LAION-5B, un jeu de données public utilisé dans la recherche image-texte, contient environ5 milliards d'images, dont environ2 milliardspossèdent des légendes en anglais correspondantes, selon larecherche sur le jeu de données image-texte LAION-5B. Le modèle apprend des motifs à partir de ces exemples ; il ne les utilise pas comme une table de consultation d'images finies.
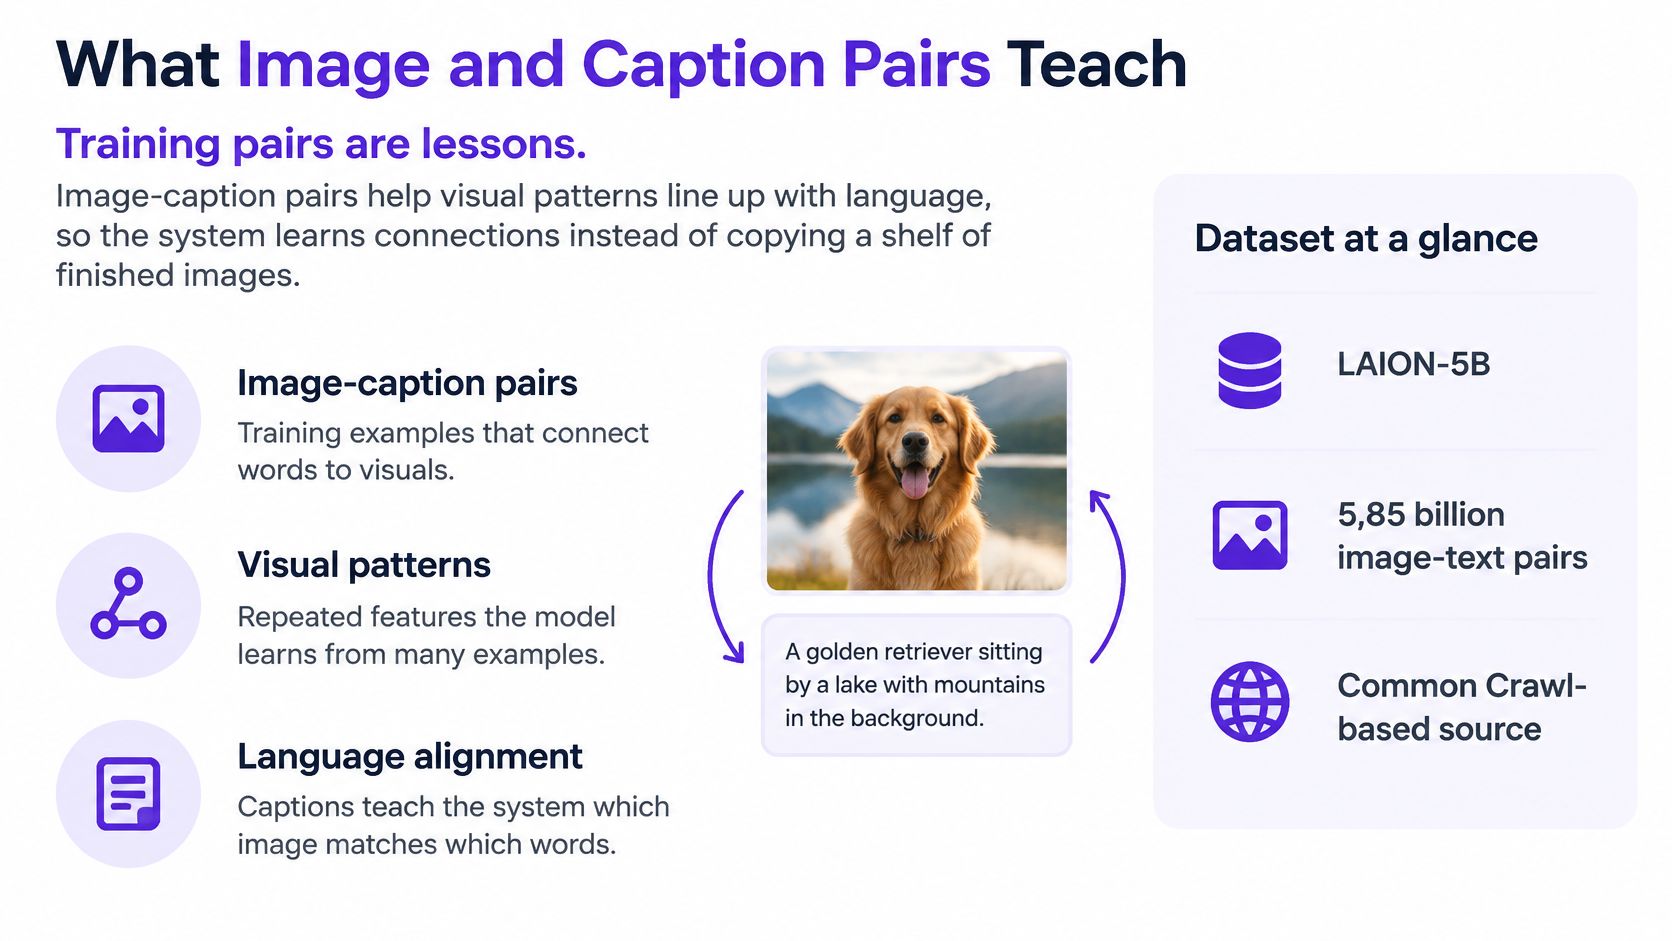
Les légendes influencent ce que le modèle peut apprendre à associer à une image. Des légendes denses et de haute qualité peuvent améliorer la fidélité des images générées par rapport au texte. Le compromis est qu'elles peuvent également réduire la qualité esthétique et la diversité des résultats. Un système qui apprend à partir de descriptions plus précises peut être meilleur pour correspondre aux détails indiqués, sans pour autant produire une plus grande variété de styles.
Cela aide à expliquer pourquoi le suivi des invites ne se résume pas à grossir un modèle visuel. Le modèle dépend également de la clarté avec laquelle ses légendes d'entraînement ont décrit chaque image. Si un costume inhabituel, une créature de jeu de niche ou une marque distinctive apparaît dans un petit nombre d'exemples bien décrits, le système disposera de motifs plus faibles sur lesquels s'appuyer.
Pour un sujet obscur, décomposez l'idée en caractéristiques visuelles que le modèle peut exprimer : la forme d'un costume, ses matériaux et ses couleurs, les parties du corps de la créature, ou la position d'une marque ressemblant à un logo. Une invite décrivant ces parties visibles donne au système plus de matière sur laquelle travailler qu'un simple nom d'initié.
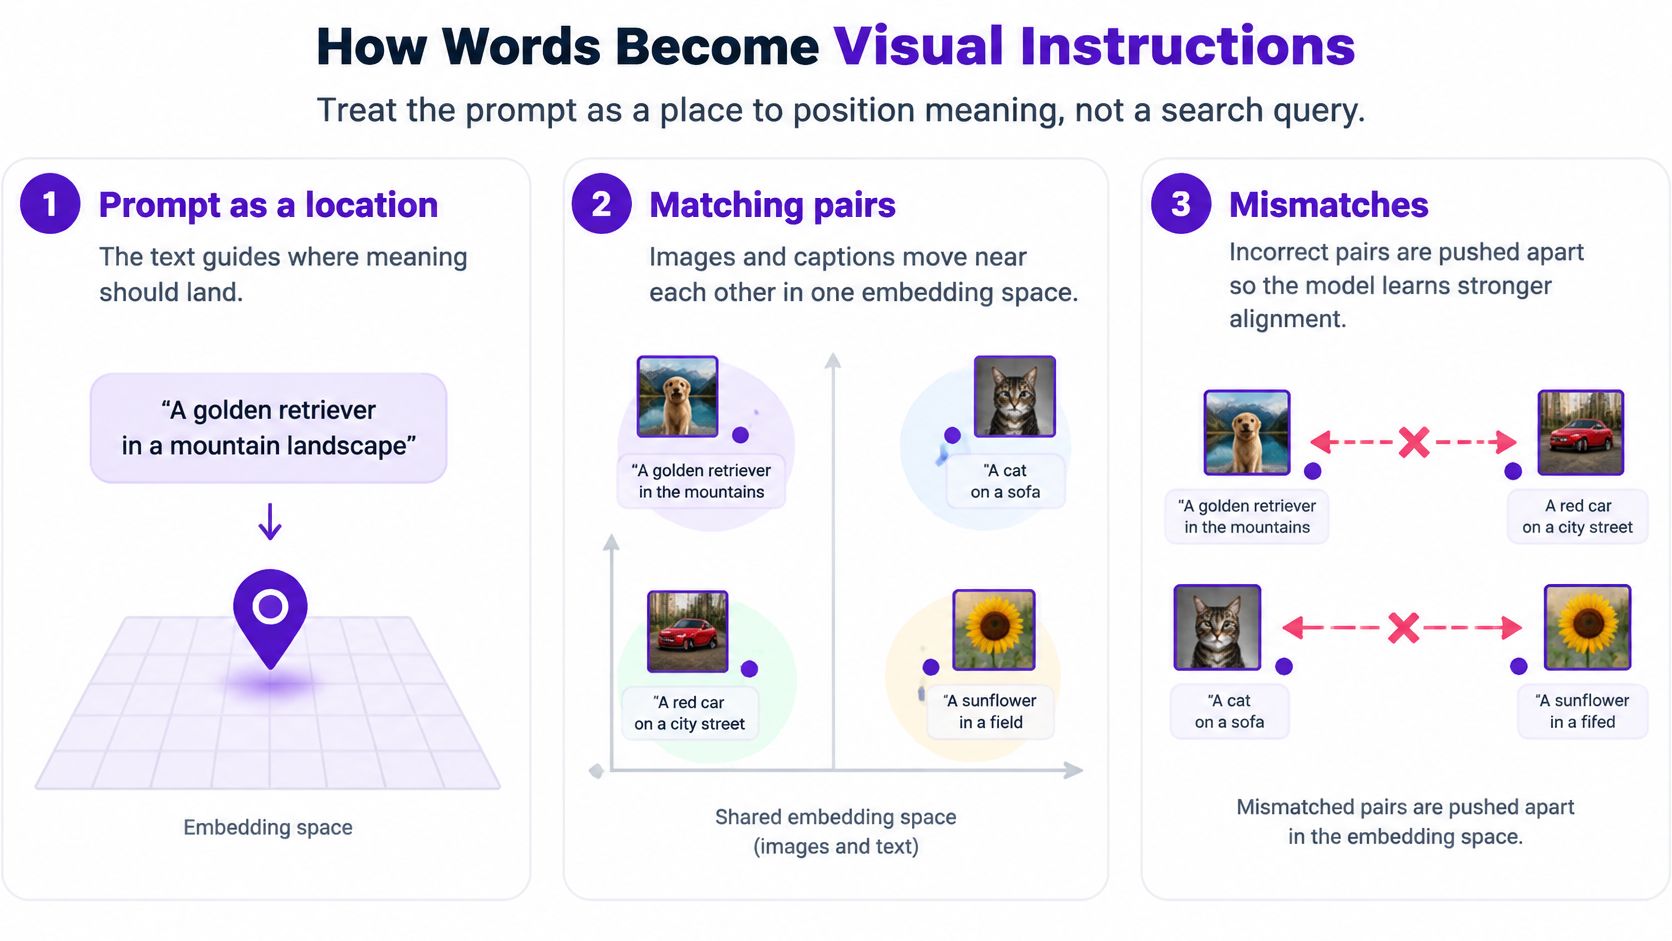
Imaginez une pièce partagée où les images et leurs légendes ont chacune une place. Une bonne légende se place près de la photo qu'elle décrit ; une légende incorrecte se place plus loin. Dans une approche de type CLIP, les images et les légendes correspondantes sont rapprochées dans un espace d'incorporation (embedding) partagé, tandis que les paires non assorties sont écartées. Lecompte rendu de l'apprentissage contrastif dans les systèmes de texte à imageexplique comment cette correspondance est mesurée dans les deux sens, de l'image au texte et du texte à l'image.
Au moment de la génération, l'invite se transforme en une représentation numérique qui transporte des concepts tels que le sujet, les attributs et le style. Le modèle de diffusion utilise cette représentation pour guider la formation de l'image, plutôt que de traiter l'invite comme une chaîne non structurée. En termes simples, le modèle essaie de préserver le sens nommé tout en le transformant en structure visuelle.
Considérez deux invites pour une image de café :
« Belle photo de café. »
« Mug en émail rouge sur un rebord de fenêtre, lumière matinale latérale, pas de texte. »
La première donne au modèle une destination large, mais laisse de nombreux choix ouverts. La seconde nomme l'objet, sa couleur et son matériau, sa relation avec le rebord de fenêtre, l'éclairage et une contrainte. Ces détails fournissent des points d'ancrage plus clairs à la représentation de l'invite.
Une invite de texte à image n'est pas une requête de recherche qui va chercher la photo existante la plus proche. C'est un ensemble d'instructions qui guide le processus de création d'image. Nommez ce qui doit apparaître, comment les éléments interagissent et quels choix visuels comptent le plus. Unguide pour l'optimisation des invites d'IApeut vous aider à développer cette habitude pour la création d'images.
Le guidage textuel affecte également la force avec laquelle l'invite tire sur chaque étape de débruitage. Une invite précise donne au modèle des concepts plus clairs à préserver ; le paramètre de guidage détermine avec quelle fermeté ces concepts influencent l'image en train d'émerger. Ni l'un ni l'autre ne garantit que chaque détail sera correct.
Essayez cette habitude d'écriture : nommez le sujet, une relation, un point de vue ou une source de lumière, et quelque chose à omettre. Par exemple, « mug rouge sur un rebord de fenêtre, vue à hauteur des yeux, lumière douce du matin de côté, pas de lettrage » est plus exploitable qu'une suite de compliments généraux. Cette clarté ne supprime pas l'incertitude, mais elle donne au processus une cible plus spécifique.
Pendant l'entraînement, le modèle voit des images délibérément altérées par un bruit connu. Il apprend à prédire le bruit à différentes étapes temporelles tout en utilisant la représentation textuelle comme condition. La génération inverse cette corruption : le modèle part du bruit et applique de manière répétée son opération de débruitage apprise, se rapprochant d'une image qui correspond à l'invite.
Il n'y a pas de photo originale cachée sous le point de départ aléatoire. À l'inférence, le modèle ne récupère pas une image particulière qu'il a déjà vue. Chaque étape formule une prédiction sur l'apparence que devrait avoir l'image émergente, compte tenu de l'état bruité actuel et du guidage textuel.
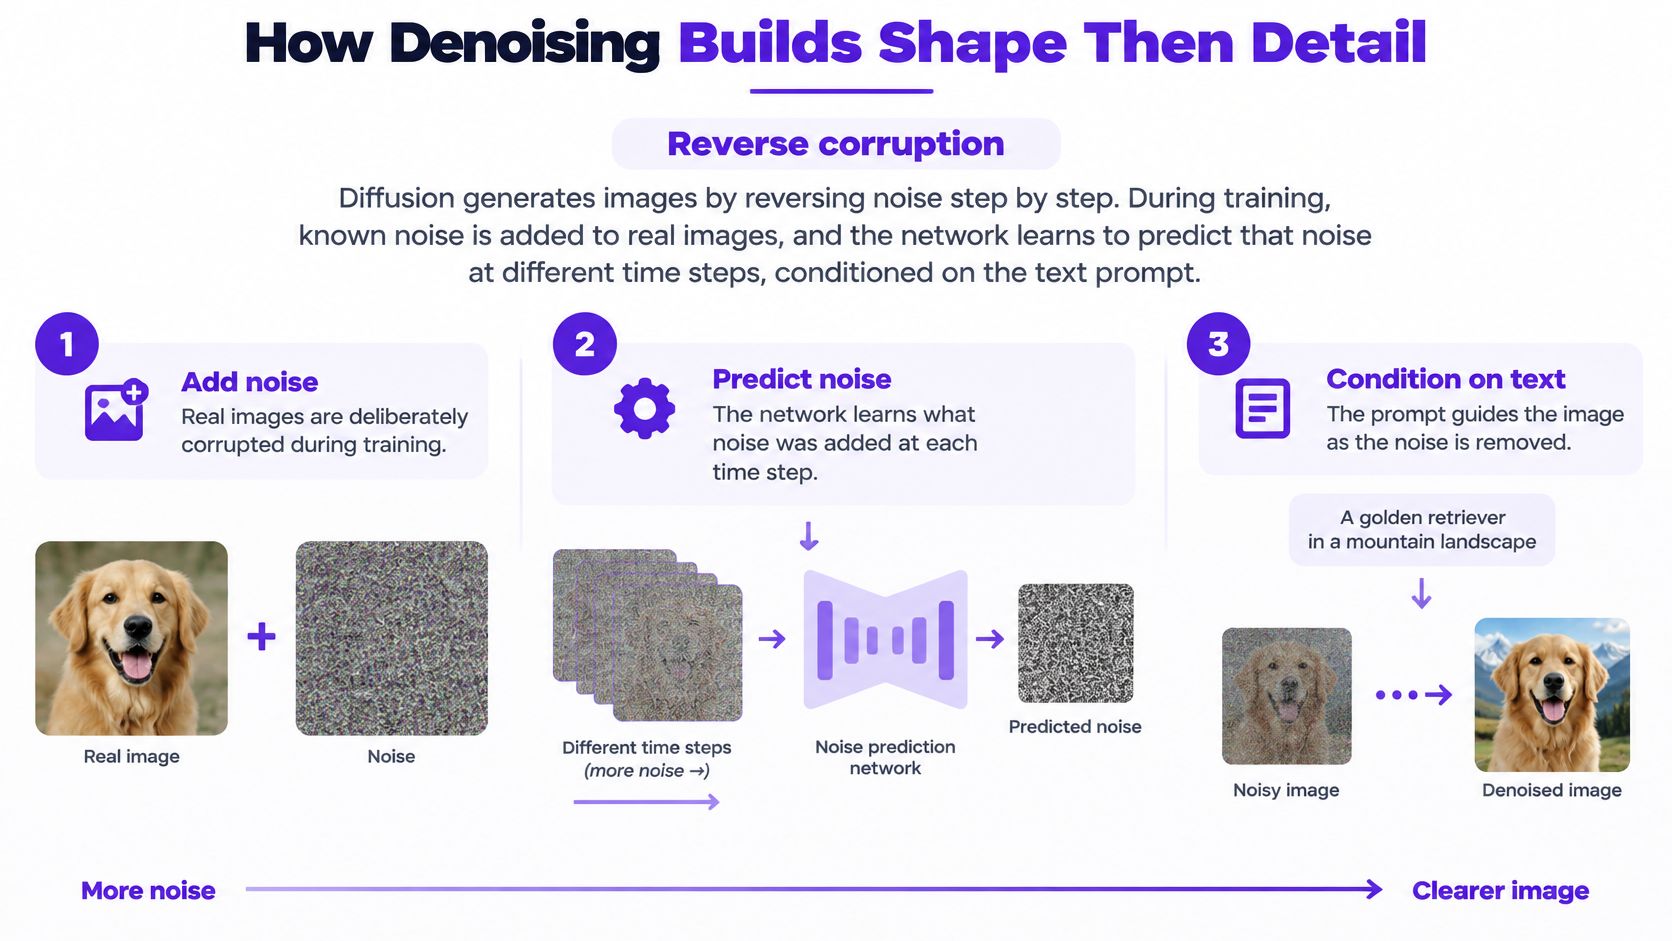
Un système de diffusion basé sur les pixels agit directement sur les pixels de l'image, ce qui peut exiger des calculs importants. La diffusion latente compresse d'abord l'image, exécute les étapes de débruitage sur cette représentation plus petite, puis utilise un décodeur pour transformer le résultat en pixels. Le passage à cette approche en 2022 a réduit les besoins en calcul et en mémoire tout en prenant en charge la synthèse haute résolution.
Cette efficacité s'accompagne d'un compromis. Le modèle n'affine pas chaque pixel directement pendant sa boucle de génération principale, et le processus de compression et de décodage peut limiter la qualité finale. La diffusion latente rend la génération plus pratique, mais elle ne rend pas chaque résultat parfait.
Les étapes de débruitage précoces établissent la composition globale et la géométrie des objets. Les dernières remplissent principalement les détails, tels que la surface d'un tissu, un reflet ou un contour. Uneintroduction en langage clair à Stable Diffusionoffre un autre moyen d'explorer une approche de diffusion largement utilisée.
Cet ordre est utile lorsque vous évaluez un aperçu. Si la pose d'un coureur ou la position d'un personnage de couverture de livre semble fausse alors que l'image est encore floue, ajouter de la texture n'est pas la solution. Le modèle peut affiner une mauvaise estimation initiale au lieu de la corriger par magie. Considérez le progrès visible comme suit :la disposition d'abord, les surfaces ensuite, les pixels à la fin.
Une invite n'est pas convertie directement en pixels en une seule opération. Le modèle commence par un bruit aléatoire et effectue une séquence de prédictions, de sorte que réexécuter les mêmes mots peut mener à un résultat différent. Même les approches de diffusion accélérée nécessitent généralement environ20 à 50 étapes de débruitage séquentiel par image, selon uneanalyse de la vitesse, de l'incohérence et des problèmes pratiques dans la génération de texte à image.
. Ce même processus itératif aide à expliquer pourquoi une invite peut manquer une instruction. Une prédiction concernant l'alignement du texte, l'anatomie ou le nombre d'objets peut affecter les étapes ultérieures. Une invite plus longue peut également aggraver les choses si elle combine des sujets ou des styles concurrents, laissant le modèle avec un ensemble de directions confus.
| Ce que vous remarquez | Pourquoi le mécanisme fait cela | Que essayer ensuite |
|---|---|---|
| Même invite, image différente | Chaque exécution part d'un nouveau bruit aléatoire et approxime | Nommez la composition et le point de vue, puis régénérez |
| Mains, membres ou comptes bizarres | Les erreurs peuvent se cumuler sur environ 20 à 50 étapes | Utilisez moins de personnes, simplifiez la pose, puis effectuez une passe de modification |
| Texte cassé ou supplémentaire | Le texte est difficile à maintenir aligné dans les pixels | Utilisez des mots très courts ou ajoutez du texte en dehors du modèle |
| Plus de détails ont empiré la situation | Des concepts concurrents déchirent l'intégration | Choisissez un sujet, des relations claires et un seul style |
| La génération semble lente | Les étapes s'exécutent en séquence, et non comme une écriture de pixels unique | Prévoyez plusieurs essais au lieu d'une seule passe parfaite |
Une représentation latente compressée peut réduire le calcul, mais elle crée également un plafond de qualité imposé par l'auto-encodeur. Si la compression perd quelque chose, le débruitage ultérieur ne peut pas toujours le ramener. C'est pourquoi une image attrayante est la preuve d'un résultat réussi, et non la preuve que le modèle résoudra de manière fiable chaque invite.
La distillation et la modélisation de la cohérence sont des évolutions à suivre. Elles visent à réduire la génération à une ou deux évaluations au lieu de nombreuses étapes de diffusion, ce qui pourrait rendre la création d'images plus réactive pour les flux de travail créatifs mobiles et à haut volume. Cette direction ne signifie pas que chaque application d'image actuelle génère déjà en une ou deux étapes.
Pour les créateurs, la réponse pratique consiste à spécifier la composition, les relations entre les sujets, la caméra ou le point de vue, et les contraintes de sortie. Traitez ensuite un résultat erroné comme une inférence manquée, et non comme un verdict sur l'idée : régénérez lorsque la composition est défectueuse, ou modifiez la partie qui a échoué. Lors de la comparaison d'outils, concentrez-vous sur celui qui gère votre tâche récurrente et votre flux de travail de correction ; cetaperçu des modèles de texte à imageoffre un autre point de départ.
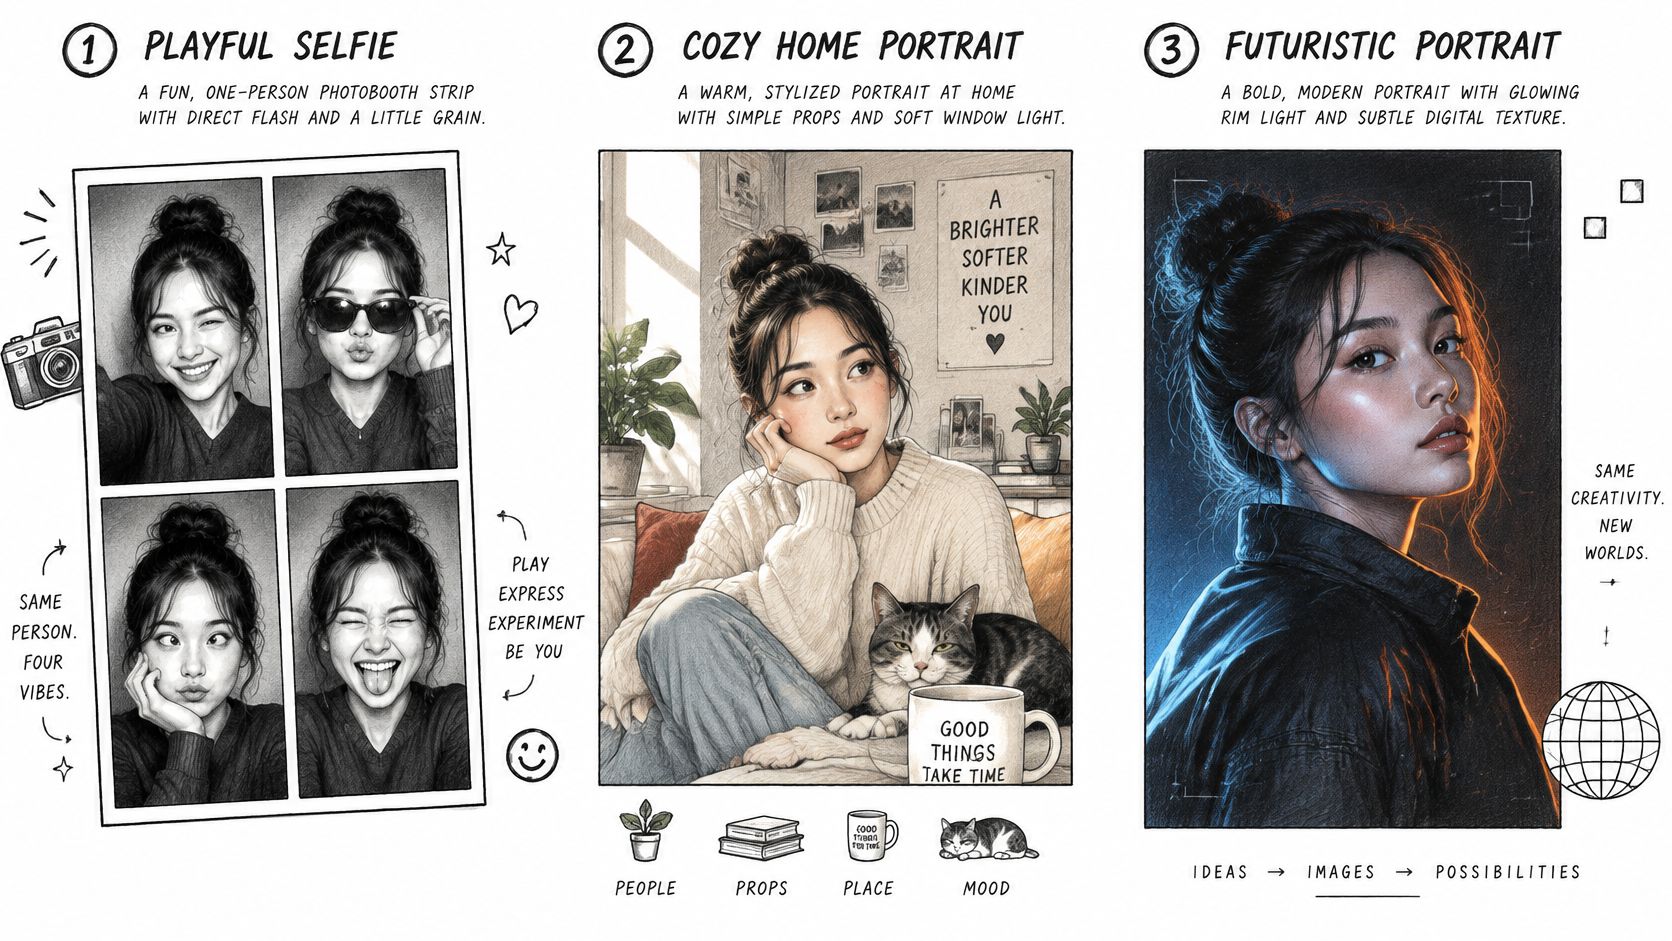
La même habitude de rédaction d'invites peut servir à une transformation de selfie, un portrait athlétique ou un concept de personnage. Dans chaque cas, donnez d'abord au modèle les instructions structurelles, puis utilisez des détails qui soutiennent le look souhaité. Voici trois invites que vous pouvez adapter.
Selfie de style photomaton :« Une personne avec une expression ludique, flash d'appareil photo direct, disposition de bande photo à quatre cadres, léger grain de film. » Les mots « une personne » et « disposition de bande photo à quatre cadres » donnent au modèle le sujet et la composition initiale à établir. « Flash d'appareil photo direct » définit l'éclairage ; « léger grain de film » est un détail de surface. Omettez les étiquettes de style supplémentaires qui entrent en concurrence avec le look de bande photo.
Pour voir le genre de transformations de portraits qui peuvent inspirer de nouvelles idées, jetez un œil à l'exemple ci-dessous.
Portrait athlétique :« Coureur à mi-foulée sur une piste, posture déterminée, vêtements de sport sombres et simples, lumière latérale. » « Coureur à mi-foulée » et « posture déterminée » aident à déterminer la position du corps et la forme globale. La piste et la lumière latérale placent le sujet dans un cadre clair. N'empilez pas plusieurs styles de vêtements ou d'ambiances sur une invite qui nécessite déjà une pose lisible.
Personnage pour une couverture ou des produits dérivés :« Un personnage fantastique, manteau vert forêt et écharpe en cuivre, fond crème uni, pas de texte. » Le sujet et les détails des vêtements donnent au générateur un objectif visuel concis ; le fond uni maintient l'attention sur le personnage. Omettre le titre est délibéré. Ajoutez des lettres précises par la suite plutôt que de compter sur le modèle d'image pour orthographier un titre de couverture.
Pour un flux de travail quotidien, starryai vous permet de commencer à partir d'une invite textuelle ou d'un selfie, de générer des variations d'image et d'utiliser Modifier lorsqu'une main, un arrière-plan ou un recadrage rate la cible. Gardez le sujet, la mise en page et l'arrière-plan clairs dans l'invite initiale. Ajustez ensuite uniquement le détail défectueux au lieu de tout réécrire.
Un signal de provenance peut montrer qu'une image a été générée ou traitée par l'IA. Il n'établit pas que vous avez l'autorisation d'utiliser chaque élément, qu'un marché autorise l'image ou que son contexte est véridique. Les informations d'identification du contenu et les filigranes invisibles peuvent enregistrer ou signaler l'historique d'une image, bien que le recadrage, la compression ou une modification substantielle puissent rendre un filigrane difficile à détecter. Aucun signal visible ne prouve qu'une image est une photographie.
Pour les couvertures de livres, les produits dérivés, les avatars et les publications de marque, enregistrez la façon dont l'image a été créée et examinez-la avant de la publier :
Une étiquette peut expliquer le processus d'une image, mais vous devez toujours juger ce qu'elle représente et si vous avez le droit d'utiliser ses ingrédients. Dans starryai, enregistrez votre invite à côté de l'image générée, puis régénérez ou modifiez l'anatomie ou le texte défectueux. Examinez le fichier final avant de le publier ou de le vendre.
starryai propose un générateur d'images IA gratuit et une suite créative pour transformer des invites textuelles, des selfies et des emojis en visuels. Essayez une invite claire, comparez les résultats etvisitez starryaipour expérimenter le flux de travail de génération et d'édition.


