

Écrit parMo Kahnle
1er juillet 2026


L'IA multimodale est un type d'intelligence artificielle capable de comprendre et de traiter des informations provenant de plusieurs sources à la fois, comme le texte, les images et le son, un peu comme le font les humains. C'est déjà une catégorie de marché bien réelle, une estimation de l'industrie évaluant le marché mondial de l'IA multimodale à1,6 milliard de dollars américains en 2024et prévoyantenviron 27 milliards de dollars américains d'ici 2034.
Vous ressentez probablement déjà le fossé que cela comble. Vous tapez une consigne, obtenez une image proche de vos attentes, puis vous aimeriez pouvoir également télécharger une photo de référence, décrire l'ambiance souhaitée, peut-être ajouter des notes vocales, et faire en sorte que l'outil comprenne le tout simultanément.
C'est là toute l'idée derrière l'IA multimodale. Elle ne traite pas la créativité uniquement sous forme de texte. Elle commence à fonctionner davantage comme un collaborateur capable de lire vos mots, d'observer vos références et d'assembler les pièces en une seule réponse. Pour les artistes, les créateurs de contenu, les auteurs indépendants, les entrepreneurs et les gestionnaires de réseaux sociaux, cela change ce que l'IA peut accomplir dans un flux de travail quotidien.
Beaucoup d'anciens outils d'IA donnaient l'impression de travailler avec quelqu'un qui ne pouvait lire que des notes glissées sous une porte. Si vous tapiez une consigne forte, ils pouvaient répondre. Mais si vous vouliez montrer un selfie, pointer une palette de couleurs et dire « fais en sorte que cela ressemble à une affiche fantastique et rêveuse », le système ne parvenait souvent pas à combiner ces signaux correctement.
C'est pourquoice qu'est l'IA multimodaleimporte aux créateurs. Cela marque un passage de systèmes à entrée unique vers des outils capables de fonctionner à traversle texte, les images, l'audio et la vidéoau lieu de traiter chaque format comme un monde séparé.
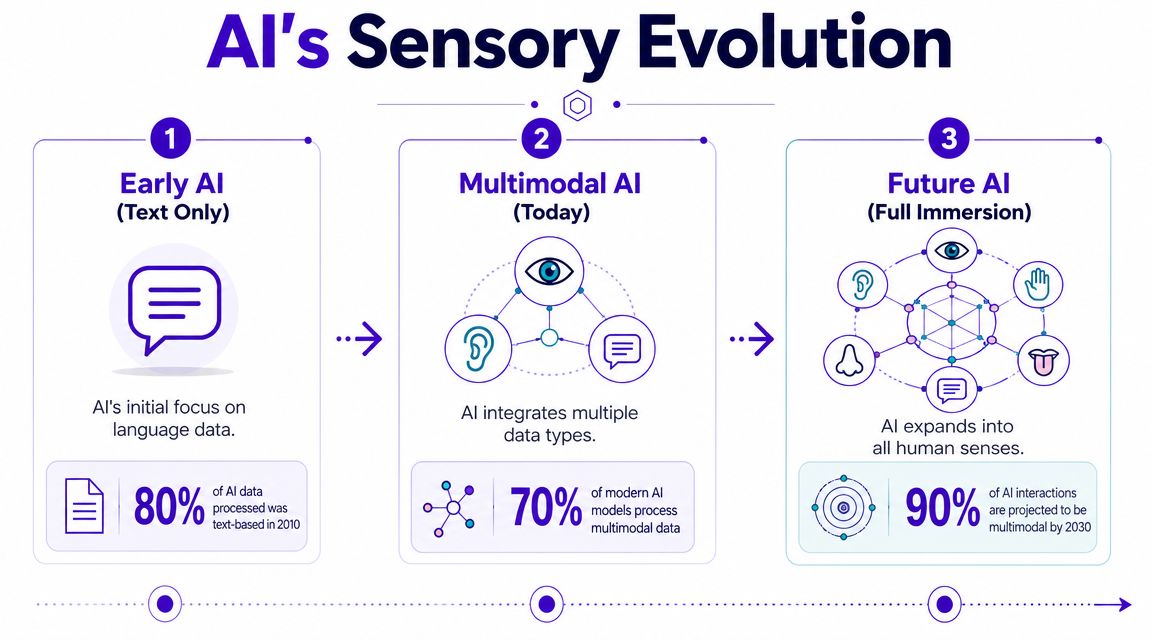
Les créateurs travaillent rarement sur un seul format à la fois. Un concept TikTok peut commencer par une idée de légende, devenir une planche de référence, se transformer en voix off, puis finir en courte vidéo. Une couverture de livre peut débuter par des notes sur les personnages, puis des images d'ambiance, puis des expériences typographiques.
L'IA multimodale correspond mieux à cette réalité que les anciens outils, car elle peut gérer un contexte plus riche.
Si vous souhaitezrationaliser la production vidéo avec la TTS, la pensée multimodale commence à devenir efficace. Vous ne gérez plus des tâches isolées. Vous combinez des types de médias en un seul système créatif.
Règle pratique :Plus votre idée dépend des relations entre les mots, les visuels et le son, plus l'IA multimodale semblera utile plutôt que relever du gadget.
Le versant commercial reflète également ce changement. Une estimation de l'industrie évalue le marché mondial de l'IA multimodale à1,6 milliard de dollars américains en 2024et prévoit qu'il atteindraenviron 27 milliards de dollars américains d'ici 2034, ce qui implique unTCAC de 32,7 %selon l'analyse du marché de l'IA multimodale de Global Market Insights.
Si vous travaillez déjà avec des visuels générés par IA, il est utile de comprendre d'abord l'aspect image, en particulier dans des guides tels quece qu'est une image IA. L'IA multimodale s'appuie sur cette base, puis ajoute d'autres sens à la conversation.
La façon la plus simple de comprendre l'IA multimodale est de la comparer à votre propre perception. Lorsque vous rencontrez un chien, vous ne traitez pas un seul signal. Vous voyez sa forme, entendez l'aboiement, lisez peut-être le nom sur une médaille, et votre cerveau combine ces indices pour n'en faire qu'une seule compréhension.
Un système d'IAunimodalfonctionne plutôt comme un spécialiste doté d'un seul sens. Il peut seulement lire du texte, ou seulement classifier des images. Un systèmemultimodalpeut connecter plusieurs types d'entrées et raisonner à travers elles.
Les lecteurs se font souvent piéger ici. Multimodal ne signifie pas seulement « l'application accepte les téléchargements ». De nombreux outils vous permettent d'attacher une image et de coller du texte, mais ils ne comprennent pas nécessairement la relation entre les deux.
Un système multimodal fait quelque chose de plus profond. Il peut examiner une photo, interpréter des instructions écrites ou parlées concernant cette photo, et générer une réponse qui reflète les deux entrées ensemble.
Ce changement est devenu un jalon déterminant dans le domaine. Les descriptions majeures de la recherche et de l'industrie encadrent l'IA multimodale autour de modèles qui traitent conjointementle texte, les images, l'audio et la vidéo, ce qui a fait passer l'IA d'une spécialisation étroite à des systèmes qui ressemblent davantage à la perception humaine, comme l'explique leguide de l'IA multimodale de TileDB.
| Type | Ce qu'il gère | Où il semble limité |
|---|---|---|
| IA unimodale | Un type de données à la fois | Il peut passer à côté d'un contexte présent dans un autre format |
| IA multimodale | Plusieurs types de données ensemble | C'est plus complexe, mais cela peut produire des réponses plus riches |
Pour un créateur, cette différence est pratique.
L'IA multimodale commence à paraître utile lorsque la relation entre les entrées importe plus que chaque entrée prise isolément.
La direction artistique est généralement superposée. Vous pourriez vouloir « ce visage », « cette ambiance picturale », « ce ton de légende » et « cette énergie de bande sonore ». Les collaborateurs humains comprennent ces ensembles naturellement. L'IA multimodale essaie de faire quelque chose de similaire dans les logiciels.
C'est pourquoi elle apparaît dans des domaines tels que les diagnostics de santé, les véhicules autonomes, la modération de contenu, le service client et la robotique sur le marché élargi. Pour les créateurs, la conclusion est plus simple. L'IA s'améliore en matière de contexte, et le contexte est là où réside le style.
Sous le capot, l'IA multimodale relève moins de la magie que de la chorégraphie. Considérez-la comme une petite équipe de traducteurs travaillant dans les coulisses.
Un traducteur comprend le texte. Un autre comprend les images. Un autre gère l'audio. Chaque spécialiste prend un type différent d'entrée brute et la transforme en une forme que le système peut comparer et combiner.
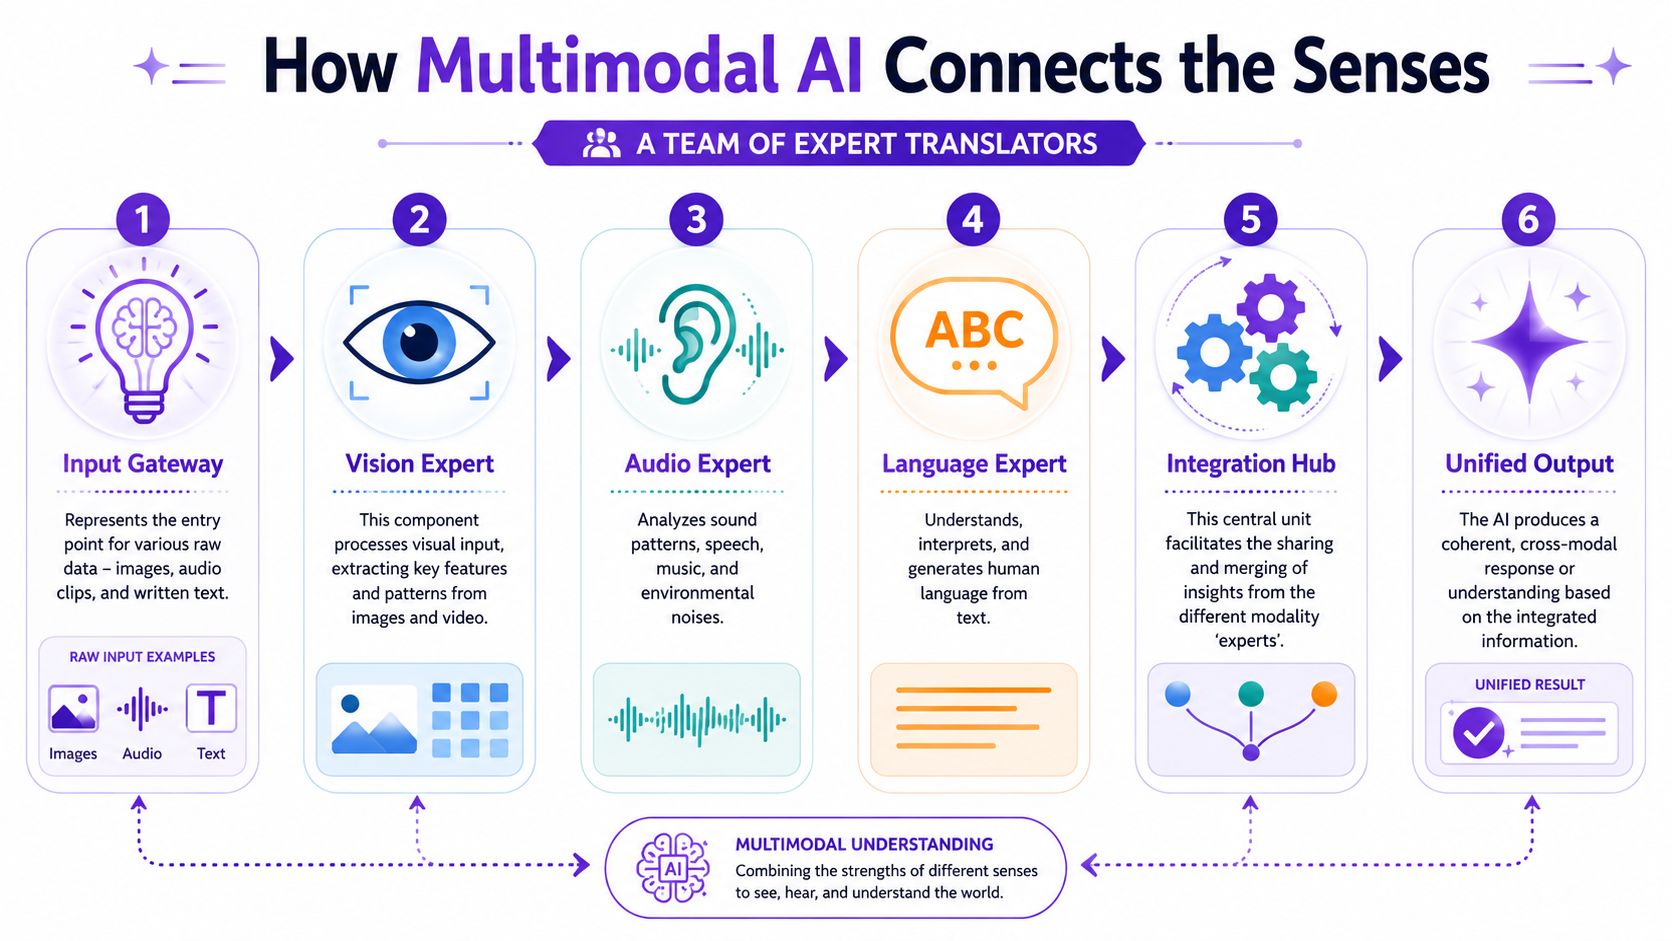
Une architecture multimodale courante comprend unmodule d'entrée, unmodule de fusionet unmodule de sortie. En termes plus techniques, ces systèmes sont généralement construits à partir d'encodeurs spécifiques à la modalitéainsi que d'unecouche de fusionqui mappe le texte, les images, l'audio ou la vidéo dans un espace d'intégration partagé, tel que décrit dans l'explication de McKinsey sur l'IA multimodale.
Voici la version en langage simple :
Entrée
Différents encodeurs gèrent différents médias. Le texte est tokenisé. Les images sont redimensionnées et encodées. L'audio est souvent transformé en caractéristiques que le modèle peut interpréter.
Fusion
C'est l'étape intermédiaire essentielle. Le système mappe ces différentes entrées dans un espace partagé afin de pouvoir comparer la signification entre les formats.
Sortie
Un modèle en aval produit la réponse. Cette réponse peut être du texte, une image, des instructions, une classification ou un autre résultat généré.
Sans fusion, l'IA multimodale ne serait qu'un ensemble de spécialistes séparés. La couche de fusion est ce qui permet au système de connecter votre invite à votre image au lieu de les traiter comme des fichiers sans rapport.
C'est ce qui permet le raisonnement intermodal. Un modèle peut utiliser une image et une invite textuelle ensemble pour répondre à une question ou générer une réponse qui reflète les deux.
Considérez la couche de fusion comme la table de réunion où chaque spécialiste apporte des notes dans la même langue.
Cette idée d'espace partagé explique également pourquoi la technologie peut prendre en charge des sorties flexibles. Une fois que différentes modalités sont intégrées dans la même représentation à haute dimensionnalité, le modèle peut prendre en charge lagénération de n'importe quoi vers n'importe quoi, ce qui signifie qu'il peut accepter une ou plusieurs modalités et produire une autre modalité en sortie, selon Milvus sur les exigences informatiques multimodales.
Si vous téléchargez un portrait et ajoutez « transforme ceci en affiche cyberpunk fluo », le système ne se contente pas empiler une instruction sur un seul fichier. Il essaie d'aligner les caractéristiques visuelles du portrait avec la signification sémantique de l'invite avant de générer le résultat.
C'est pourquoi certaines sorties semblent étrangement adaptées, tandis que d'autres s'écartent du sujet. Le modèle doit aligner plusieurs signaux correctement.
Si vous souhaitez une base plus large dans l'écosystème autour de ces systèmes,les modèles d'IA générative expliquésest une lecture complémentaire utile. Les modèles génératifs créent la sortie. La conception multimodale les aide à comprendre un mélange plus large d'entrées avant de le faire.
Le moyen le plus rapide de comprendre l'IA multimodale est de l'utiliser pour quelque chose qui vous importe déjà. Pour les créateurs, cela signifie généralement l'identité, le style, la vitesse ou la narration.
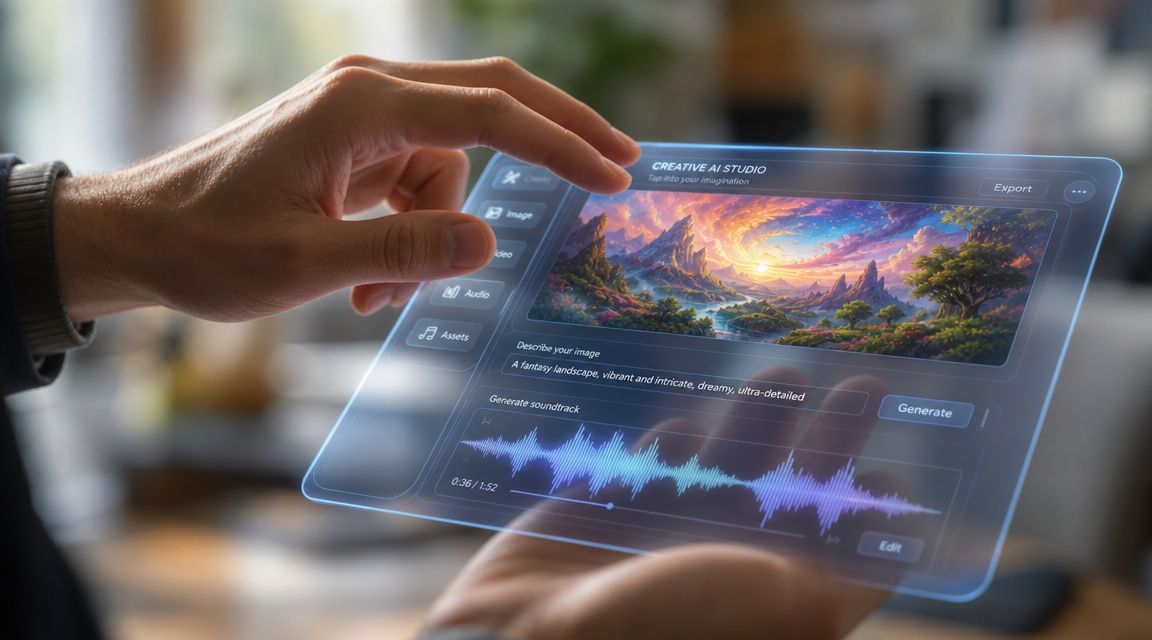
C'est l'un des cas d'utilisation les plus clairs pour les créateurs. Vous commencez par une image de vous-même, puis vous ajoutez du texte qui guide la transformation.
Une invite telle que « transforme ce portrait en elfe rôdeur au clair de lune avec une armure argentée et un éclairage pictural » donne au modèle deux choses à la fois : des indices d'identité de la photo et des indices de style du langage. Le résultat peut fonctionner comme un avatar, une actualisation de profil, un concept d'affiche ou de l'art de fan.
Pour ce type de flux de travail, des outils commestarryai texte vers imagesont pertinents car ils prennent en charge la création d'images basée sur des invites et peuvent convenir aux créateurs qui veulent un résultat visuel sans configuration technique.
Parfois, le but n'est pas « me faire paraître différent ». C'est « faire ressembler cette idée davantage à cette esthétique ».
Cela peut signifier télécharger une image d'ambiance et rédiger une invite qui spécifie le ton, la palette ou le genre. Un créateur vendant des tirages sur Etsy pourrait utiliser cela pour tester des orientations pour des collections cottagecore, science-fiction rétro ou dark academia. Un auteur indépendant pourrait utiliser le même motif pour des concepts de personnages ou l'exploration de couvertures.
Si vous travaillez dans l'édition, ce guide surla sélection de générateurs d'IA pour les auto-éditeursest utile car il structure le choix des outils autour de véritables flux de travail de conception de couvertures et de concepts plutôt que sur le battage médiatique abstrait de l'IA.
L'IA multimodale ne se contente pas de générer. Elle peut également interpréter.
Vous pouvez alimenter une image et demander :
C'est utile lorsque vous bloquez sur la recherche d'un nom, la publication ou l'affinement d'une idée que vous pouvez voir mais pas encore articuler.
Une courte démonstration rend cela plus concret :
Pour les créateurs de vidéos courtes, le saut intéressant consiste à combiner le scénario, les visuels et la voix. Un concept peut commencer comme une accroche écrite, devenir une image générée, puis intégrer une narration ou une conception sonore.
Cela ne signifie pas que chaque créateur a besoin d'une infrastructure de production complète. Cela signifie que la frontière entre « l'écriture », « la conception » et « le montage » s'amincit. La même idée de base peut désormais circuler plus fluidement entre les formats, c'est pourquoi l'IA multimodale semble particulièrement naturelle pour TikTok, les Reels, les bandes-annonces et la narration visuelle.
Une bonne instruction créative n'a plus besoin de porter tout le travail à elle seule. Les médias de référence peuvent désormais partager la charge.
L'IA multimodale ouvre de nouvelles portes créatives, mais elle augmente également le coût de la réussite. Ces systèmes sont plus exigeants que les modèles à entrée unique car ils doivent traiter plusieurs flux d'informations et les aligner de manière cohérente.
Par rapport aux systèmes unimodaux, les modèles multimodaux nécessitentnettement plus de calculs et de mémoirecar ils doivent traiter plusieurs encodeurs et maintenir des architectures plus vastes. Cela augmente la latence et accroît la demande en matière d'entraînement et d'inférence, comme indiqué dans la référence Milvus liée précédemment.
Lorsqu'un système peut combiner image, texte, audio et vidéo, il peut également être utilisé pour rendre du contenu trompeur plus convaincant. Cela inclut de faux visuels, du contenu vocal manipulé ou des publications multimédias conçues pour paraître authentiques.
Les biais constituent une autre préoccupation. Si le matériel d'entraînement contient des représentations biaisées, le modèle peut propager ces schémas sur plusieurs formats à la fois plutôt que dans un seul canal.
Une façon pragmatique d'utiliser l'IA multimodale est simple :
Les créateurs n'ont pas à craindre la technologie. Ils doivent simplement l'utiliser avec discernement.
Non.L'IA générativedécrit des systèmes qui créent des résultats tels que des images, du texte, de l'audio ou de la vidéo.IA multimodaledécrit des systèmes capables de comprendre ou de travailler avec plusieurs types d'entrées. Certains outils font les deux. D'autres ne font qu'un.
Une application de texte à image peut être générative. Un système qui analyse une image, lit votre instruction, puis génère un résultat est à la fois génératif et multimodal.
Oui. Vous n'avez pas besoin de créer des modèles ou de comprendre les mathématiques de l'apprentissage automatique pour commencer. La plupart des débutants peuvent assimiler le concept en essayant des flux de travail simples, comme le téléversement d'une photo, l'ajout d'une instruction et la comparaison des résultats.
Commencez par de petites expériences :
Cela réduit l'écart entre l'idée dans votre tête et les matériaux dont vous disposez déjà. Au lieu de tout forcer sous forme de texte, vous pouvez combiner des références, du langage et parfois du son ou du mouvement.
C'est particulièrement utile pour les créateurs qui pensent d'abord de manière visuelle, ou qui construisent sur plusieurs plateformes où un concept unique doit devenir une publication, une vignette, une couverture, une voix hors champ ou une courte vidéo.
L'évolution probable va vers une interaction plus naturelle. Les créateurs travailleront de plus en plus avec des outils capables d'accepter des entrées mixtes dans un flux unique, pour ensuite renvoyer des résultats plus conscients du contexte.
Le changement important n'est pas seulement une meilleure qualité. C'est une meilleure collaboration entre votre intention et les médias que vous fournissez.
Si vous souhaitez essayer ce type de flux de travail par vous-même,starryaiest une option pour transformer des descriptions, des selfies et des idées visuelles en images générées par IA sans configuration technique requise.


