

Scritto daMo Kahnil
26 luglio 2026


Probabilmente ti trovi nel punto in cui i tuoi prompt sono discreti, le tue idee sono forti e i risultati sembrano ancora un po' troppo generici. Forse il protagonista del tuo romanzo indipendente continua a sembrare un personaggio fantasy da catalogo, o i tuoi mockup per Etsy tendono tutti verso la stessa estetica insipida, non importa quanto attentamente tu formuli il prompt. Di solito è il momento in cui l'addestramento personalizzato di un modello AI inizia a sembrare meno una curiosità tecnica e più una decisione creativa che devi azzeccare.
Un autore indipendente vuole che un personaggio ricorrente abbia lo stesso aspetto su una copertina, un'immagine teaser e una scheda personaggio. Un venditore di Etsy vuole una linea di merchandising che non usi la stessa estetica di internet che usano tutti gli altri. In entrambi i casi, la domanda non è “l'IA può aiutare”, ma “quale strada è adatta al lavoro”.
Ci sono quattro opzioni reali.I modelli pronti all'usosono il punto di partenza più veloce ed economico, e sono sufficienti quando il risultato non richiede un'identità rigorosamente controllata.La personalizzazione basata sul recupero (retrieval)funziona quando l'assistente deve rispondere da file approvati, siti web o fonti cloud invece di modificare il modello stesso, che è spesso il significato predefinito di "addestramento sui tuoi dati" in contesti aziendaliaddestramento di GPT personalizzati e retrieval. Il fine-tuningmodifica un modello pre-addestrato esistente per adattarlo alla voce di un brand, a uno stile visivo o a un pattern specifico per un compito.L'addestramento da zeroè la strada più pesante e la maggior parte dei creator non ne ha bisogno.
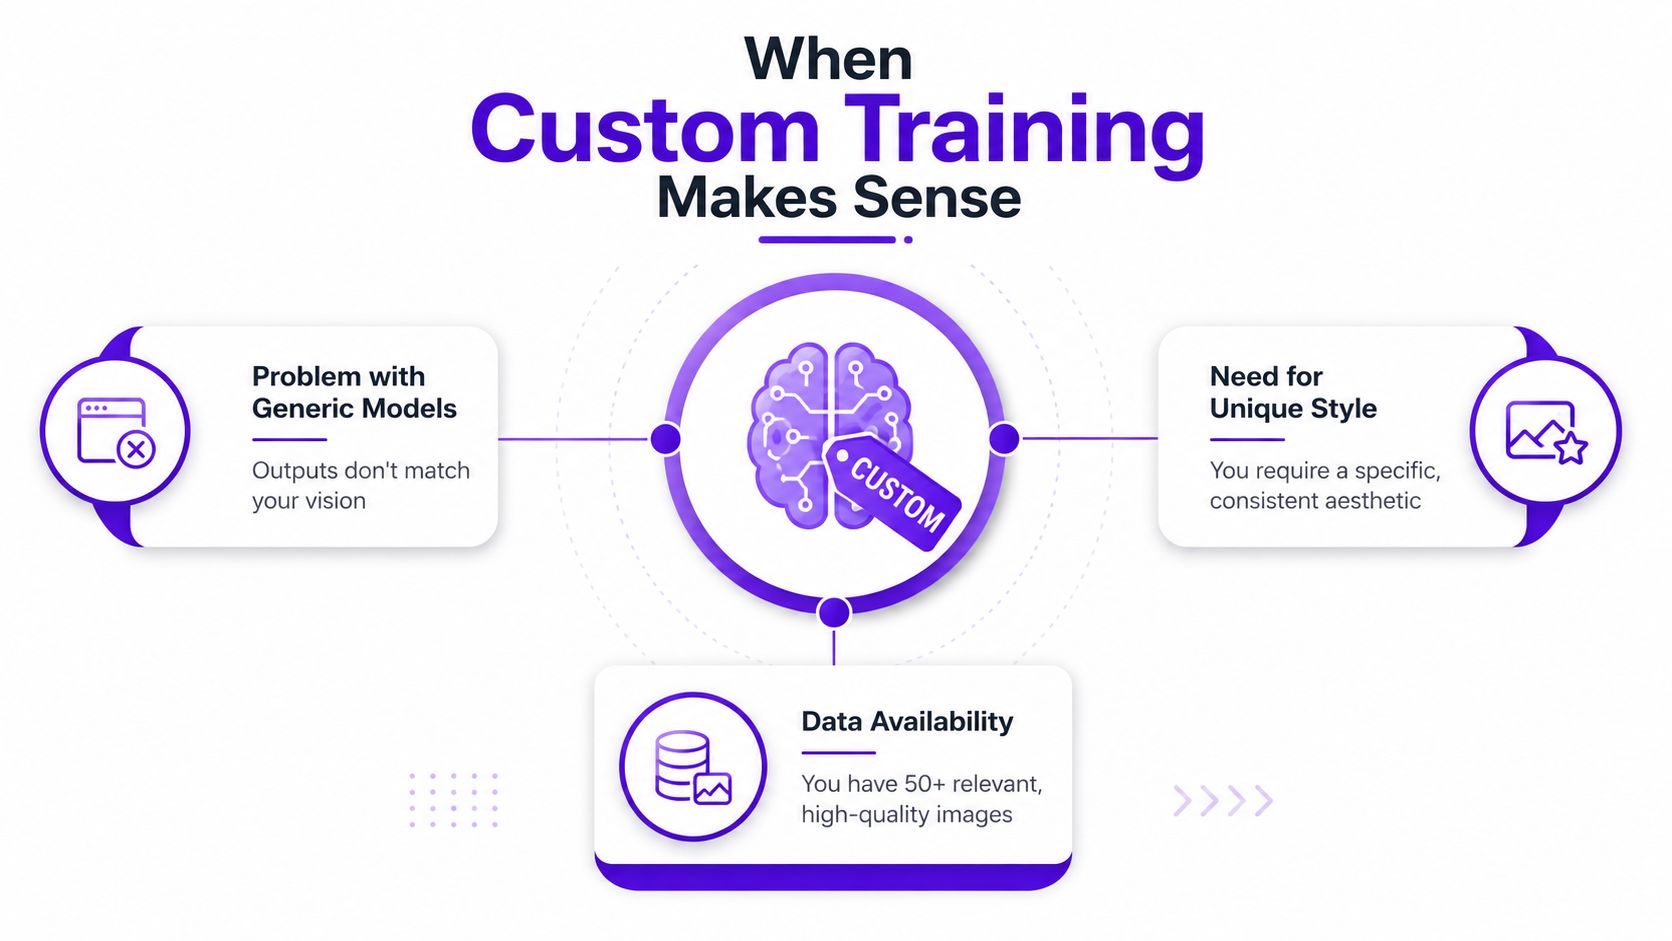
Regola pratica:addestra modelli personalizzati solo quando l'output generico continua a non cogliere il tuo dominio, il tuo volume mensile di inferenza è abbastanza alto da giustificare il lavoro extra, o i tuoi requisiti di latenza e coerenza del brand sono rigidi.
Un utile punto di riferimento storico èBERT nel 2018, che ha contribuito a normalizzare il fine-tuning specifico per task basato su modelli di base pre-addestrati. Il lavoro originale su BERT di Google ha riportatorisultati allo stato dell'arte su 11 task di NLP, inclusi un salto dal90,9% al 94,9%sulbenchmark GLUEdell'epoca, mostrando come i modelli adattati potessero superare gli approcci generici quando venivano messi a punto per un compito specifico.Panoramica di Oracle sull'addestramento dei modelli di IA. Quello stesso cambiamento è il motivo per cui oggi i piccoli team possono personalizzare un modello invece di crearne uno da zero.
Un rapido controllo mentale aiuta:
Il set di dati di solito decide se il vostro modello sembrerà rifinito o stranamente fuori luogo. Questo è particolarmente vero per i flussi di lavoro dei creatori, in cui un'immagine sfocata, una didascalia etichettata male o un riferimento duplicato possono spingere il risultato verso la standardizzazione invece che verso lo stile.
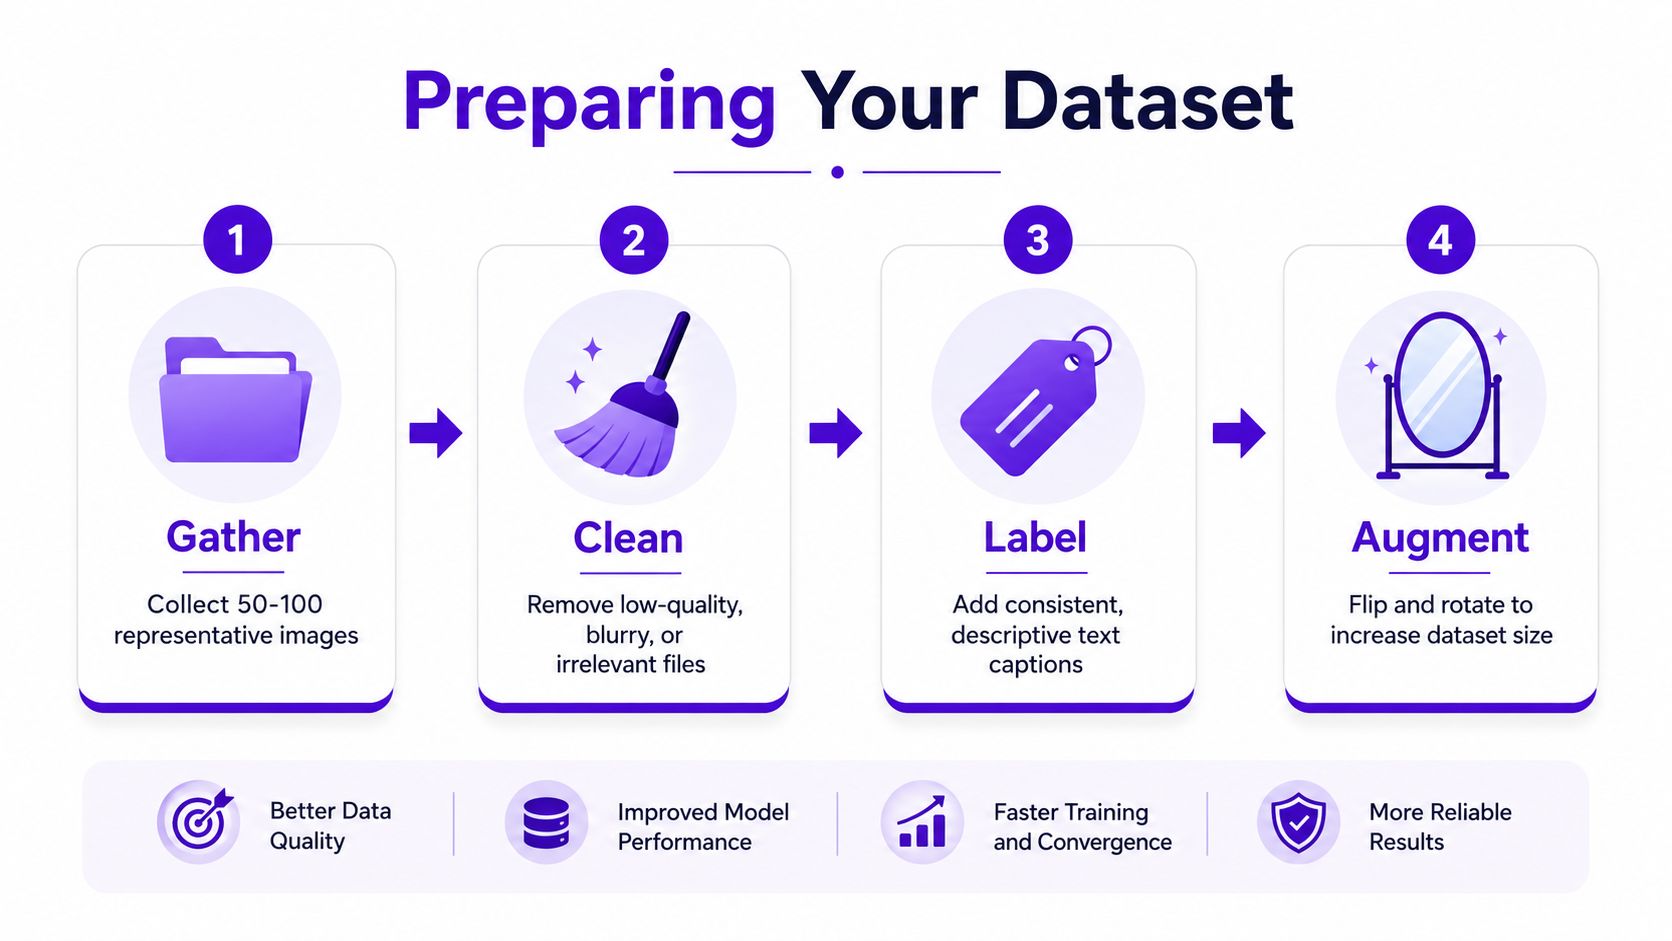
Iniziate raccogliendo solo immagini o testo che appartengono al modello. Un set focalizzato è meglio di un mucchio ampio di materiale di riferimento misto, perché il modello impara il pattern che gli mostrate più spesso. Per il lavoro sulle immagini dei creator, un punto di partenza pratico èda 12 a 20 immaginicon didascalie, e il materiale di origine raccomanda anche unminimo di 10 immaginiquando sono incluse le didascalieconfigurazione dell'addestramento delle immagini.
Successivamente, pulite rigorosamente il set. Rimuovete i duplicati, i file di bassa qualità, i valori anomali irrilevanti e le didascalie corrotte. Il motivo è semplice: il modello non può separare "importante" da "casuale" a meno che i vostri dati non facciano già quel lavoro per lui. La struttura più chiara rimane la classica suddivisione,dal 70 all'80%per l'addestramento,dal 10 al 15%per la validazione, edal 10 al 15%per il testingguida alla suddivisione del set di dati.
Il vostro set di validazione è più importante di quanto molti principianti pensino. La perdita (loss) di addestramento può continuare a diminuire mentre la perdita di validazione inizia a salire, e questo divario è il primo segnale di overfitting. Se il vostro modello sta memorizzando il set di dati invece di imparare lo stile, di solito vedrete campioni di addestramento fantastici e output nuovi deludenti.
La parte più operativa riguarda i bias e la copertura. Un modello per creator dovrebbe includere variazioni di posa, illuminazione, angolazione, sfondo e inquadratura in modo che il risultato non si blocchi su un unico aspetto ristretto. Un riferimento di flusso di lavoro interno che molti team usano per l'organizzazione dei set di dati è laguida alla gestione delle raccolte, perché il problema spesso riguarda meno la generazione di immagini e più il mantenere la libreria di origine abbastanza ordinata da poterci fare l'addestramento.
Conservate una nota accanto a ogni set di dati: da dove proviene, cosa avete rimosso e perché avete tenuto gli esempi finali. Questo registro fa risparmiare ore in seguito quando un modello si comporta in modo strano e dovete risalire alla causa.
I creator di solito non hanno bisogno del metodo più pesante possibile. Hanno bisogno del metodo che preservi lo stile a cui tengono senza consumare tempo, capacità di calcolo o la loro sanità mentale. Ecco perché la scelta giusta dipende dal fatto che stiate cercando di insegnare al modello un comportamento completo, uno stile leggero o semplicemente una parola chiave (trigger word) per un concetto visivo.
| Metodo | Dati necessari | Tempo di addestramento | Ideale per |
|---|---|---|---|
| Fine-Tuning | Esempi più curati, copertura più ampia | Più lungo | Tono del marchio, specializzazione dei task, modifiche comportamentali più profonde |
| LoRA | Set di dati moderato e mirato | Più breve | Personaggi, stili, elementi visivi per creator, iterazioni rapide |
| Textual Inversion | Set di concetti ridotto | Il più breve | Nuovi token, semplici indizi di stile, trigger visivi ristretti |
Il fine-tuningmodifica una parte maggiore del comportamento del modello, quindi è l'opzione più pesante quando avete bisogno di un adattamento più profondo. È utile quando il modello sottostante continua a non cogliere il dominio, ma richiede anche di più dai vostri dati e dalla vostra pazienza. Un buon punto di partenza per comprendere a livello concettuale i flussi di lavoro in stile diffusione è la spiegazione più ampia suNozioni di base sull'addestramento di Stable Diffusion, poiché molti creatori di immagini incontrano per la prima volta questi metodi all'interno di quell'ecosistema.
LoRAè l'opzione verso cui molti creatori convergono. È più leggero, più veloce e più facile da iterare quando si addestra il volto di un personaggio, un avatar ricorrente o un'estetica di copertina distinta. Di solito offre un controllo sufficiente per bloccare uno stile senza imporre una riscrittura completa del modello.
L'inversione testualeè l'approccio più delicato. Funziona meglio quando hai semplicemente bisogno di un token che richiami in modo affidabile un'idea visiva specifica. Se il tuo obiettivo è "fare in modo che questo assomigli alla mia mascotte drago originale", questo può bastare. Se il tuo obiettivo è "fare in modo che il modello comprenda l'intero sistema del mio marchio", di solito non è sufficiente.
Se l'obiettivo è un personaggio ripetibile, inizia con il metodo più leggero che ti permette di ottenerlo. Passare direttamente al fine-tuning completo spesso aggiunge complessità prima di aggiungere qualità.
Una semplice regola decisionale funziona bene. Sceglil'inversione testualeper un concetto ristretto,LoRAper la maggior parte del lavoro sullo stile o sui personaggi orientato al creatore, eil fine-tuningquando hai bisogno di un controllo comportamentale più ampio e disponi già della disciplina sui dataset necessaria a supportarlo.
Un primo ciclo di addestramento è meno drammatico di quanto la gente si aspetti. Non stai "lanciando un modello magico", stai verificando se il tuo dataset, le didascalie e le impostazioni possono spostare l'output nella giusta direzione senza compromettere la coerenza dello stile.
Inizia con un modello di base che assomigli già al tuo caso d'uso di riferimento. Per il personaggio di una serie di libri fantasy, questo di solito significa una base visivamente coerente piuttosto che quella più generale disponibile. Imposta un tasso di apprendimento conservativo in modo che il modello non sorpassi l'aspetto che stai cercando di insegnargli. Se è troppo aggressivo, i risultati diventano spesso fragili o si adattano eccessivamente in fretta.
Usa il salvataggio dei punti di controllo (checkpointing) dopo ogni epoca. Questo ti offre un punto di ripristino quando il modello inizia a deviare e rende il confronto affiancato molto più semplice. Il flusso di lavoro pratico descritto nel materiale di origine raccomanda anche lavalidazione basata su porzioni (slice-based validation)e le ablazioni, il che significa controllare piccoli sottoinsiemi di immagini o didascalie per vedere quale componente sta aiutandoguida al flusso di lavoro di addestramento.
Un semplice ciclo nello stile del creatore si presenta così:
Una semplice aumentazione aiuta, ma non dovrebbe prendere il sopravvento sull'identità del set. Capovolgimenti, ritagli modesti e leggere modifiche cromatiche possono migliorare la forza. Una forte distorsione solitamente danneggia la fedeltà dello stile, soprattutto quando l'obiettivo dell'addestramento è un volto riconoscibile, un abito o l'aspetto di un marchio.
Se il modello ha un ottimo aspetto sugli esempi di addestramento ma inizia ad appiattire i volti o a ripetere artefatti di sfondo con i nuovi prompt, interrompi l'esecuzione e ispeziona le didascalie prima di aggiungere altre epoche.
Per una prima esecuzione, la domanda più utile non è "ha fatto l'addestramento?", ma "ha migliorato il tipo di output di cui ho bisogno?". Questa è la differenza tra un lavoro tecnicamente riuscito e uno strumento utile per il creatore.
L'addestramento personalizzato diventa costoso quando le persone saltano la fase di pianificazione. Un creatore non ha bisogno di un team finanziario, ma ha bisogno di un'idea approssimativa di quando una configurazione personalizzata smette di essere un esperimento divertente e inizia a diventare una decisione infrastrutturale ricorrente.
Una guida stima che l'addestramento personalizzato diventi economicamente interessante al di sopra di circada 5 a 10 milioni di chiamate al mese, o quando la latenza deve rimanere al di sotto di50 ms guida all'addestramento di modelli personalizzati. Per la maggior parte dei creatori, questo va ben oltre il tipico flusso di lavoro per copertine di libri o avatar. Un'API ospitata o un flusso di lavoro personalizzato leggero all'interno di starryai è solitamente molto più facile da giustificare su scala minore.
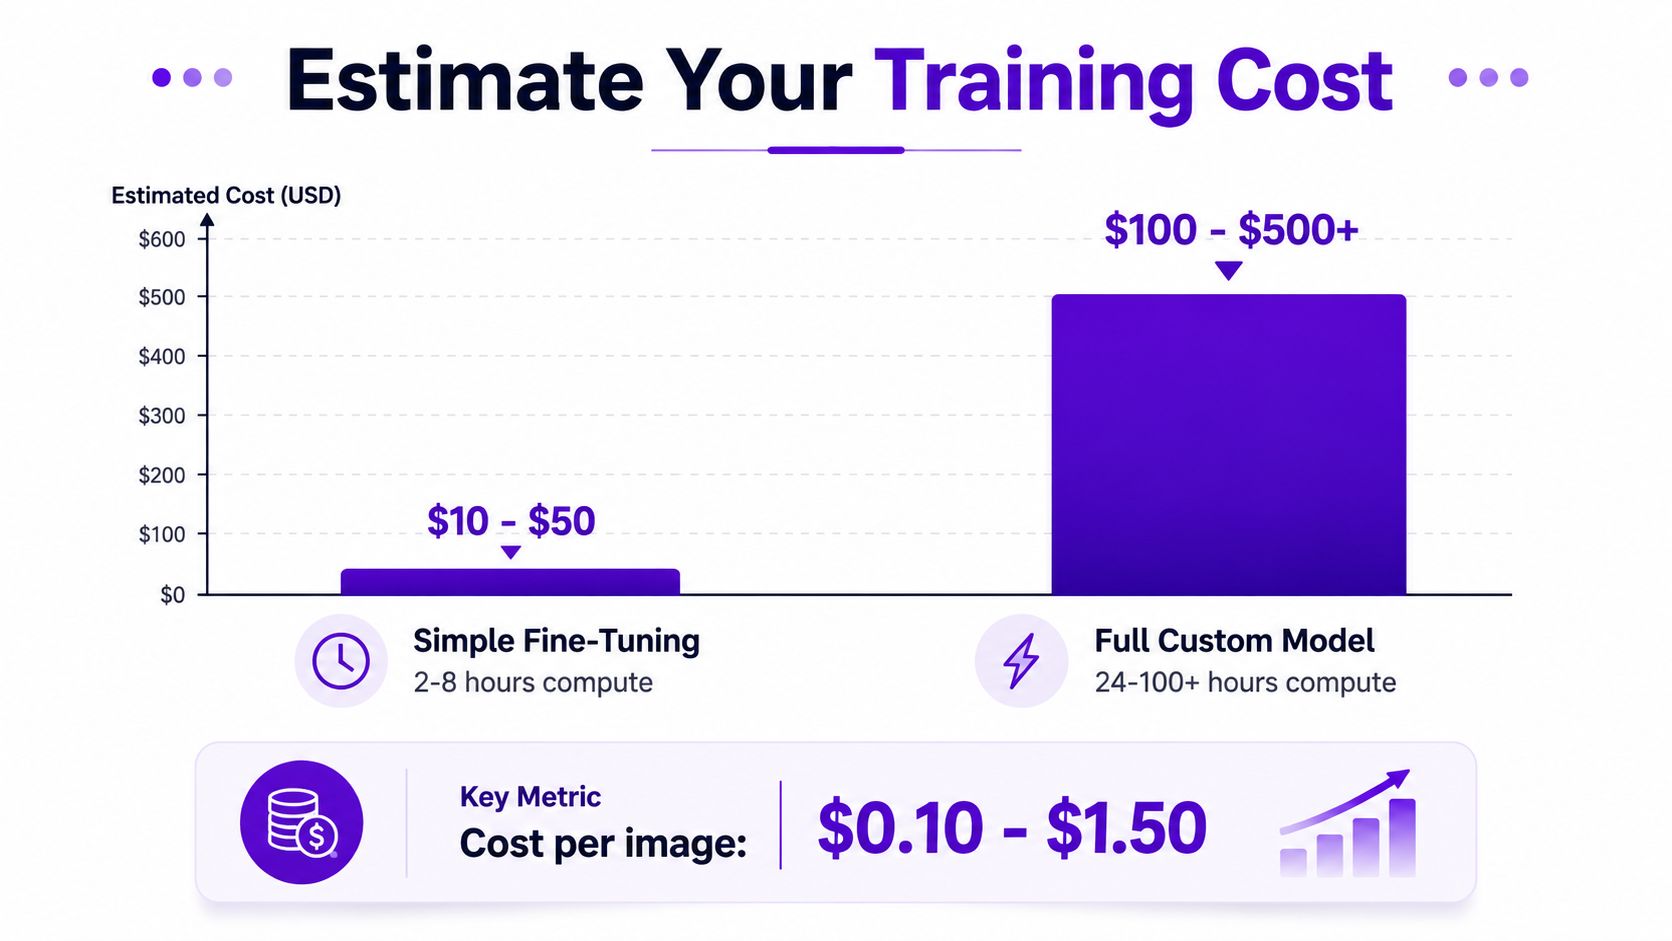
Un modo pratico per pensare alla spesa è suddividerla per livelli:
| Livello di addestramento | Sensazione di calcolo tipica | Risultato previsto | Idoneità per il creatore |
|---|---|---|---|
| Leggero | Un ciclo breve con un dataset ristretto | Allineamento di stile o concetto | Avatar, concetti di mascotte, semplici grafiche per merchandising |
| Medio | Maggiore iterazione e confronto dei punti di controllo | Aspetto del personaggio o del marchio più coerente | Copertine per libri indie, elementi visivi di prodotti ricorrenti |
| Pesante | Molti cicli di esperimenti e una messa a punto più rigorosa | Controllo del modello più approfondito | Team con esigenze rigorose di latenza, dominio o scalabilità |
Il materiale di partenza nota anche un praticocosto per immagine da 0,10$ a 1,50$nel contesto di addestramento mostrato nel suo graficografico di stima dei costi. Questa non è una formula di fatturazione universale, ma è un utile punto di riferimento per la pianificazione quando si decide se addestrare un concetto o cinque.
Se stai sperimentando a casa, l'addestramento locale su una GPU di livello consumer può essere sufficiente per piccoli test. Le piattaforme ospitate sono preferibili quando desideri tempi di configurazione più brevi e meno problemi legati all'ambiente. La domanda non è "qual è la soluzione più economica in teoria", ma "cosa mi permette di ottenere un risultato utilizzabile senza sprecare una settimana per la configurazione".
Budgetta per l'iterazione, non solo per la prima esecuzione. La maggior parte dei modelli utili arriva dopo aver confrontato alcune esecuzioni più piccole invece di puntare tutto su un unico passaggio gigantesco.
Un modello può sembrare fantastico e risultare comunque inutilizzabile se i dati di addestramento sono stati raccolti senza attenzione. Questa è la parte che molti creator sottovalutano, soprattutto quando pianificano di vendere stampe, copertine, pacchetti di avatar o merchandising basati sull'output.
La regola fondamentale è rispettare icopyright, , i termini di servizioe lenormative sulla privacy dei datiquando si raccolgono contenuti dal web. Le linee guida di CIO raccomandano inoltre di mantenere registri dettagliati delle fonti e della pre-elaborazione, insieme a una rigorosa validazione, deduplicazione, pulizia e audit regolari per ridurre i biasCIO sulla governance dei dati di addestramento. Non si tratta di punti etici astratti, ma di controlli operativi.
Devi anche separare la licenza del modello di base dai diritti relativi al risultato addestrato. Un modello ottimizzato (fine-tuned) non eredita automaticamente ogni autorizzazione commerciale associata al modello di fondazione, e le attività dei creator spesso subiscono perdite per aver dato il contrario per scontato. Se non sei sicuro di ciò che una piattaforma consente, è necessario verificare itermini di licenza di starryaiprima di distribuire lavori retribuiti.
Per le sembianze e i personaggi dei fan, il consenso è importante. Se il tuo modello sta imparando a riprodurre una persona riconoscibile, o se stai effettuando l'addestramento sul design di un personaggio protetto di qualcun altro, dovresti trattare la questione come un problema di diritti, non solo come una scelta estetica. Questo è particolarmente importante quando l'output è destinato alla vendita.
Anche i controlli sui bias sono pratici. Cerca distorsioni sistematiche in termini di genere, età, tonalità della pelle, tipo di corpo o segnali culturali nei tuoi output. Se un gruppo continua a essere inquadrato nello stesso modo, probabilmente il dataset sta dicendo al modello di farlo, anche se non era tua intenzione.
Una rapida checklist dei diritti è utile:
Per una prospettiva di policy più ampia, le stesse preoccupazioni di equità si presentano anche in altri sistemi di IA, inclusa l'equità nelle assunzioni basate sull'IA. La categoria è diversa, ma la lezione è la stessa: se i dati sono distorti, lo sarà anche l'output.
L'addestramento è solo metà del lavoro. Un modello che vive solo in un notebook o in un ciclo di addestramento non aiuta un autore, un venditore o un creator di social media a distribuire alcunché.
La valutazione dovrebbe iniziare visivamente. Confronta gli output fianco a fianco, usa i prompt sweep e chiedi ad alcuni utenti reali quali risultati sembrano più vicini al look desiderato. Per i progetti dei creator, questo tipo di revisione individua errori che le metriche numeriche possono perdere, specialmente quando l'output deve sembrare in linea con il marchio anziché solo tecnicamente valido.
Dopodiché, ottimizza per il modo in cui il modello verrà utilizzato. Laquantizzazionepuò ridurre le dimensioni del file e aiutare con i limiti di memoria. Ladistillazionepuò accelerare l'inferenza. Anche il prompt engineering rimane importante, perché un modello ben addestrato può offrire prestazioni inferiori se il prompt ignora il modo in cui è stato condizionato.
Una sequenza di distribuzione che funziona nella pratica è la seguente:
I flussi di lavoro dei creatori spesso includono avatar personalizzati, copertine di libri e grafica per i social, quindi una piattaforma che supporta già queste attività può far risparmiare tempo. starryai offreStyles Training, che consente agli utenti di caricare da5 a 60 immaginidi uno stile, un oggetto o un'estetica coerenti per addestrare un modello di stile personalizzato. Ciò lo rende un'opzione pratica quando l'obiettivo è un look ripetibile anziché un progetto ingegneristico completo.
Il monitoraggio è importante dopo il lancio. Controlla la deriva di accuratezza, i casi limite insoliti e i cambiamenti nella qualità man mano che alimenti il modello con nuovi prompt. Se gli output iniziano a degradare, un piccolo set curato di esempi difficili è solitamente più utile che ricominciare da zero.
Il modello non è mai "finito". Rimane utile solo se continui a confrontare gli output con il look che desideri realmente.
Se sei pronto a trasformare una vaga idea visiva in qualcosa di ripetibile, inizia constarryai, testa un set di stili mirato e verifica se il tuo progetto si adatta a un flusso di lavoro per creatori leggero prima di impegnarti in un percorso di addestramento più pesante.


