

Scritto daMo Kahnil


L'IA da testo a immagine non recupera una foto salvata: un codificatore di testo trasforma il tuo prompt in numeri, poi una serie di rimozioni del rumore ripetute trasforma il rumore casuale in un'immagine guidata da quei numeri. La diffusione latente, introdotta in ricerche influenti nel 2022, rende questo processo più efficiente lavorando con una rappresentazione compressa anziché con ogni singolo pixel.
Il consiglio popolare di "scrivere semplicemente un prompt migliore" tralascia parte del quadro. Le tue parole guidano un tentativo iterativo, non una ricerca diretta o un collage, quindi il risultato può richiedere tempo, variare tra un'esecuzione e l'altra o sbagliare mani, conteggio degli oggetti e scritte. Comprendere i passaggi ti aiuta a scrivere prompt più chiari e a decidere cosa correggere quando una generazione non va a buon fine.
Un'app da testo a immagine non recupera un'immagine finita né assembla un collage a partire dalle tue parole. Usa il tuo prompt per guidare una serie di tentativi, partendo da rumore casuale e modellandolo gradualmente in un'immagine. Laricerca del 2022 sulla diffusione latente e sul processo di generazione di immaginidescrive come questo processo passi dal rumore a un'immagine adatta al prompt.
| Fase | Cosa fa il modello | Cosa vedi |
|---|---|---|
| Codifica del testo | Un codificatore linguistico trasforma il prompt in embedding numerici | Ancora nulla di visibile |
| Inizio del rumore | La generazione inizia da rumore gaussiano casuale | Statica grigia senza oggetti |
| Rimozione del rumore iniziale | I primi passaggi definiscono forma generale, oggetti e layout | Una composizione sfocata |
| Rimozione del rumore avanzata | I passaggi successivi aggiungono colore, texture e dettagli fini | Superfici e bordi più nitidi |
| Decodifica | Un decodificatore riconverte la rappresentazione latente in pixel | L'immagine finita |
Le fasi spiegano perché un'anteprima iniziale può sembrare sfocata ma mostrare comunque la disposizione della scena. La codifica del testo prepara istruzioni numeriche, mentre il rumore iniziale non contiene oggetti riconoscibili. Il denoising iniziale stabilisce la composizione generale; i passaggi successivi raffinano principalmente colori, superfici e bordi.
La guida del testodescrive quanto fortemente il prompt orienta il denoising. Alcune applicazioni espongono questo parametro come scala di guida. Un'impostazione più alta spinge il risultato più vicino alla formulazione, sebbene possa far sembrare l'immagine dura. Un'impostazione più bassa dà alla generazione più margine di movimento. Il prompt definisce l'obiettivo; l'impostazione della guida influisce sulla decisione con cui il processo lo segue.
Eseguire il denoising di ogni singolo pixel direttamente richiederebbe più calcolo e memoria. La diffusione latente comprime prima un'immagine in una rappresentazione più piccola, esegue il denoising lì, e poi decodifica il risultato tornando ai pixel. Questo rende più pratico generare immagini a più alta risoluzione senza perfezionare ogni pixel durante tutto il processo.
Puoi leggere un'anteprima come un lavoro in corso: guarda prima la composizione, poi controlla se i dettagli arrivano man mano che l'immagine si nitidisce. L'assistenza dell'IA per la ricerca accademica è un altro esempio di IA che supporta un processo di lavoro passo dopo passo.
Le coppie di addestramento sono lezioni, non uno scaffale di immagini finite che aspettano di essere copiate dall'applicazione. Ogni coppia collega un esempio visivo con parole che lo descrivono, aiutando un modello a imparare le associazioni tra linguaggio e pattern visivi. Tali associazioni possono includere un soggetto, i suoi attributi, la disposizione di una scena e uno stile visivo.
La scala dei dati di addestramento è importante, ma lo è anche la qualità delle sue didascalie. LAION-5B, un dataset pubblico utilizzato nella ricerca immagine-testo, contiene circa5 miliardi di immagini, con circa2 miliardidotati di corrispondenti didascalie in inglese, secondo laricerca sul dataset immagine-testo LAION-5B. Il modello apprende i pattern da questi esempi; non li usa come tabella di ricerca di immagini finite.
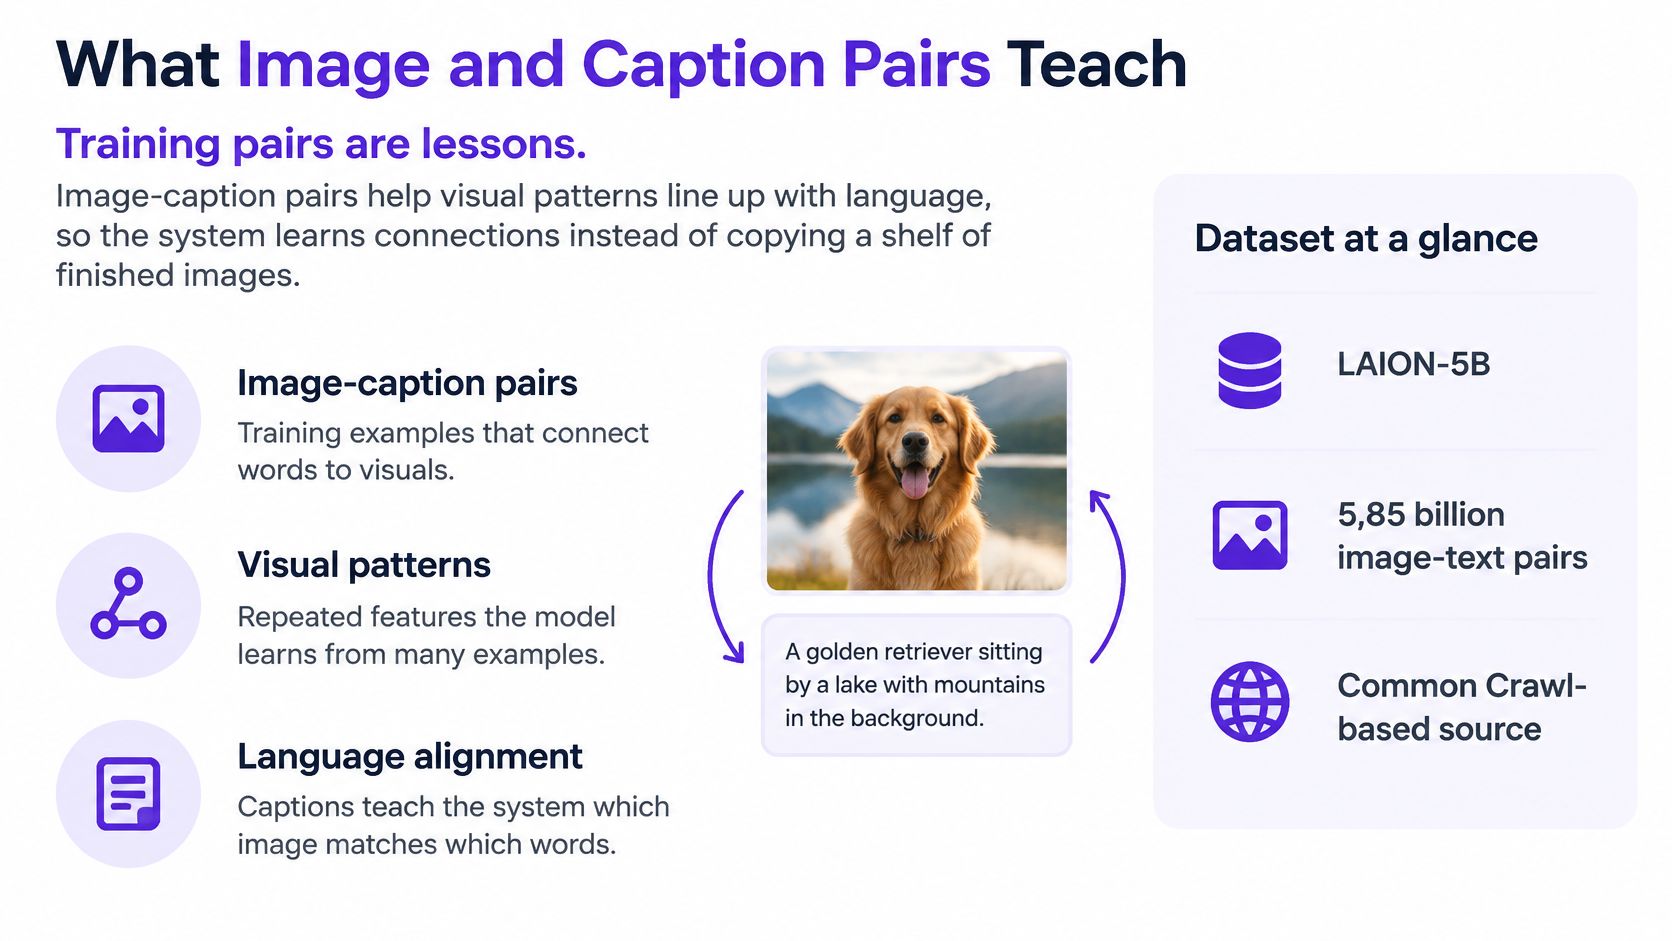
Le didascalie influenzano ciò che il modello può imparare ad associare a un'immagine. Didascalie dense e di alta qualità possono migliorare il modo in cui le immagini generate seguono il testo. Il compromesso è che possono anche ridurre la qualità estetica e la diversità dell'output. Un sistema che apprende da descrizioni più precise potrebbe essere migliore nel rispettare i dettagli indicati, senza produrre una gamma più ampia di aspetti.
Questo aiuta a spiegare perché seguire i prompt non è solo una questione di ingrandire un modello visivo. Il modello dipende anche dal fatto che le sue didascalie di addestramento abbiano descritto ogni immagine in modo sufficientemente chiaro. Se un costume insolito, una creatura di nicchia di un gioco o un marchio distintivo compaiono in pochi esempi ben descritti, il sistema potrebbe avere pattern più deboli a cui attingere.
Per un soggetto poco noto, suddividi l'idea in caratteristiche visive che il modello può esprimere: la forma di un costume, i suoi materiali e colori, le parti del corpo della creatura o la posizione di un marchio simile a un logo. Un prompt che descrive queste parti visibili dà al sistema molto più materiale su cui lavorare rispetto al solo nome di nicchia.
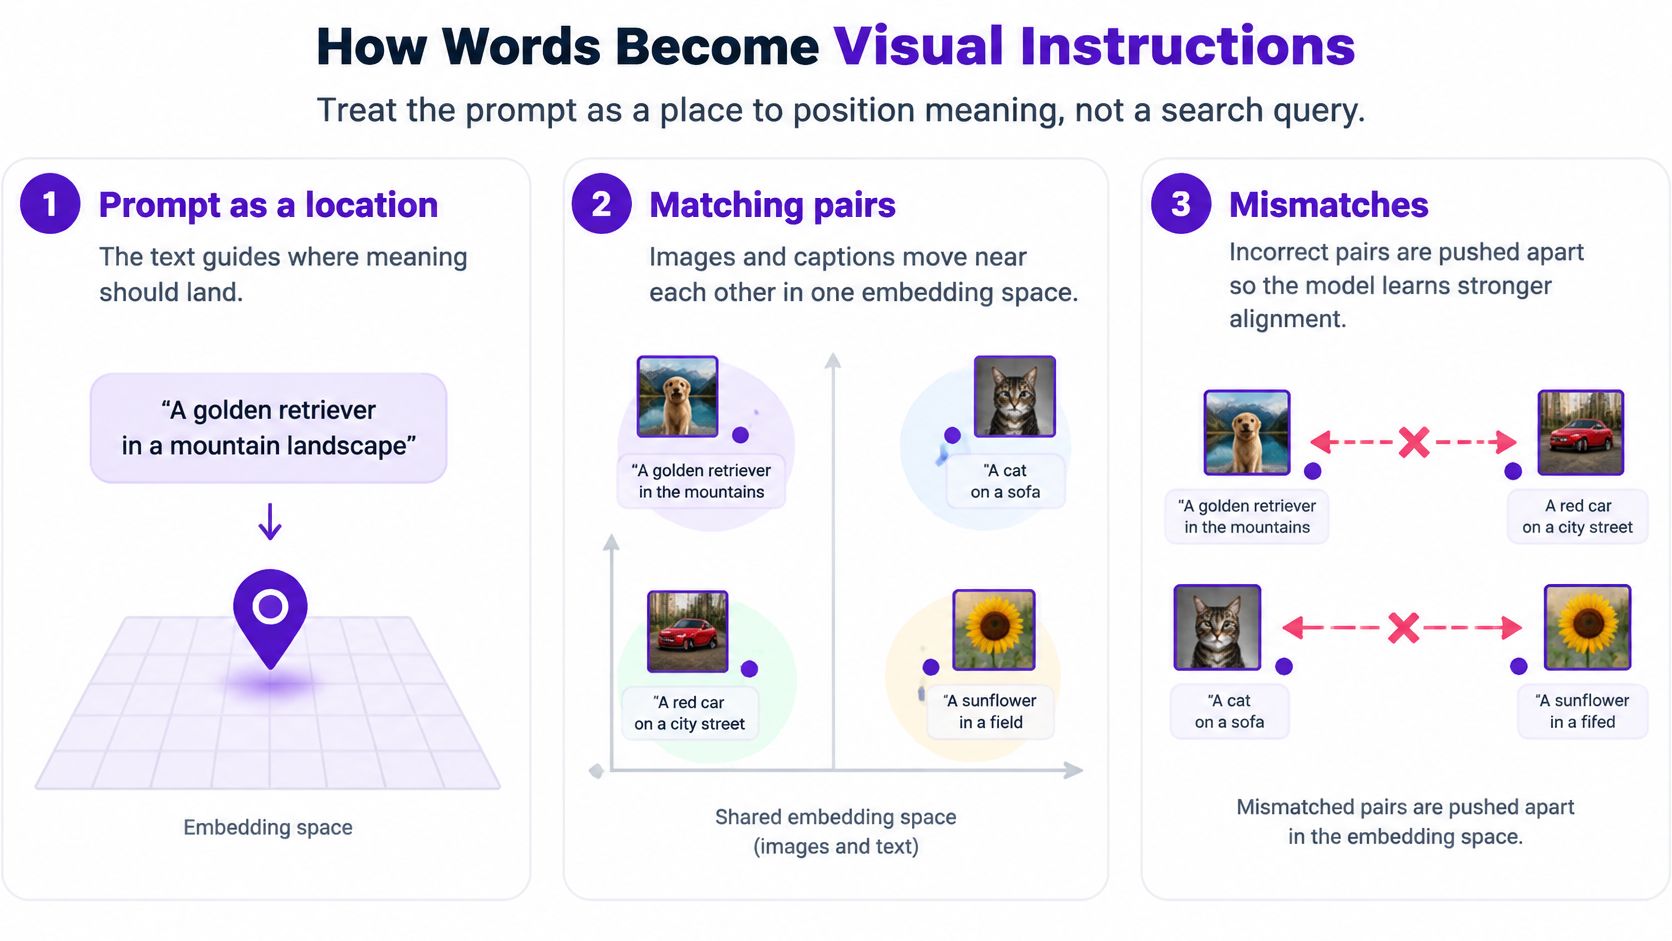
Pensa a una stanza condivisa dove le immagini e le loro didascalie hanno ciascuna un posto. Una buona didascalia si siede vicino alla foto che descrive; una didascalia errata si siede più lontano. In un approccio in stile CLIP, immagini e didascalie corrispondenti vengono avvicinate in uno spazio di embedding condiviso, mentre le coppie non corrispondenti vengono allontanate. Ilresoconto dell'apprendimento contrastivo nei sistemi da testo a immaginespiega come questa corrispondenza viene misurata in entrambe le direzioni, da immagine a testo e da testo a immagine.
Al momento della generazione, il prompt diventa una rappresentazione numerica che trasporta concetti come soggetto, attributi e stile. Il modello di diffusione utilizza tale rappresentazione per guidare la formazione dell'immagine, anziché trattare il prompt come una stringa non strutturata. In parole povere, il modello sta cercando di mantenere il significato nominato trasformandolo in struttura visiva.
Considera due prompt per l'immagine di un caffè:
"Bella foto di caffè."
"Tazza in smalto rosso su un davanzale, luce laterale del mattino, nessun testo."
Il primo dà al modello una destinazione ampia, ma lascia aperte molte scelte. Il secondo nomina l'oggetto, il suo colore e materiale, il suo rapporto con il davanzale, l'illuminazione e un vincolo. Questi dettagli forniscono alla rappresentazione del prompt ancore più chiare.
Un prompt da testo a immagine non è una query di ricerca che recupera la foto esistente più vicina. È un insieme di istruzioni che guida il processo di creazione dell'immagine. Nomina ciò che dovrebbe apparire, come si relazionano gli elementi e quali scelte visive contano di più. Unaguida all'ottimizzazione dei prompt per l'IApuò aiutarti a sviluppare questa abitudine per la creazione di immagini.
La guida del testo influisce anche sulla forza con cui il prompt agisce in ogni fase del denoising. Un prompt preciso fornisce al modello concetti più chiari da preservare; l'impostazione della guida determina con quanta fermezza questi concetti influenzano l'immagine che emerge. Né l'uno né l'altra garantiscono che ogni dettaglio sarà corretto.
Prova questa abitudine di scrittura: nomina il soggetto, una relazione, un punto di vista o una fonte di luce e qualcosa da tralasciare. Ad esempio, "tazza rossa su un davanzale, vista all'altezza degli occhi, luce laterale morbida del mattino, nessuna scritta" è più azionabile di una sfilza di complimenti generali. Questa chiarezza non rimuove l'incertezza, ma dà al processo un obiettivo più specifico.
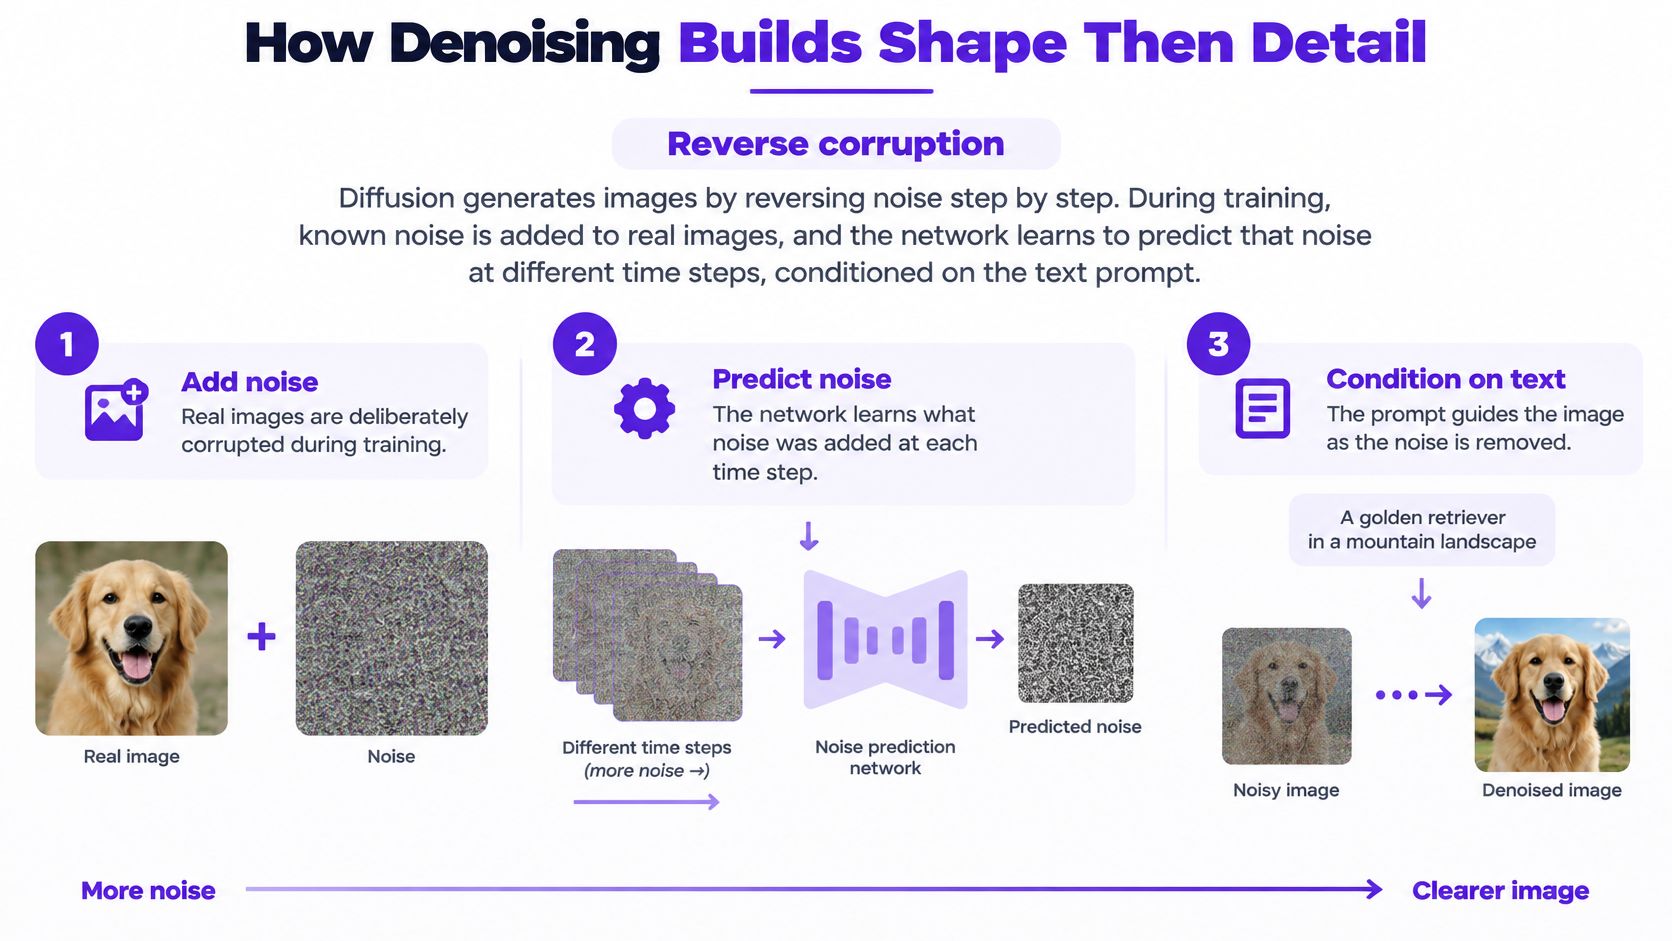
Durante l'addestramento, il modello vede immagini deliberatamente alterate con rumore noto. Impara a prevedere il rumore a diversi passi temporali utilizzando la rappresentazione del testo come condizione. La generazione inverte questa corruzione: il modello parte dal rumore e applica ripetutamente la sua operazione di denoising appresa, muovendosi verso un'immagine che si adatta al prompt.
Non c'è alcuna foto originale nascosta sotto il punto di partenza casuale. Durante l'inferenza, il modello non sta recuperando una particolare immagine che ha visto prima. Ogni passo fa una previsione su come dovrebbe apparire l'immagine emergente, dato lo stato rumoroso attuale e la guida del testo.
Un sistema di diffusione basato su pixel lavora direttamente sui pixel dell'immagine, il che può richiedere calcoli considerevoli. La diffusione latente comprime prima l'immagine, esegue i passaggi di denoising su quella rappresentazione più piccola, quindi utilizza un decoder per trasformare il risultato in pixel. Il passaggio a questo approccio nel 2022 ha ridotto i requisiti di calcolo e memoria pur supportando la sintesi ad alta risoluzione.
L'efficienza comporta un compromesso. Il modello non perfeziona ogni pixel direttamente durante il suo ciclo di generazione principale, e il processo di compressione e decodifica può limitare la qualità finale. La diffusione latente rende la generazione più pratica, ma non rende ogni output perfetto.
I primi passaggi di denoising stabiliscono la composizione globale e la geometria degli oggetti. Quelli successivi riempiono principalmente i dettagli, come la superficie di un tessuto, un punto luce o un bordo. Un'introduzione in linguaggio semplice a Stable Diffusionoffre un altro modo per esplorare un approccio di diffusione ampiamente utilizzato.
Questo ordine è utile quando giudichi un'anteprima. Se la posa di un corridore o la posizione del personaggio sulla copertina di un libro appare sbagliata mentre l'immagine è ancora sfocata, aggiungere texture non è la soluzione. Il modello può perfezionare una prima supposizione errata invece di correggerla magicamente. Pensa al progresso visivo comeprima il layout, poi le superfici, infine i pixel.
Un prompt non viene convertito direttamente in pixel in un'unica operazione. Il modello inizia con rumore casuale e compie una sequenza di previsioni, quindi eseguire nuovamente le stesse parole può portare a un risultato diverso. Anche gli approcci di diffusione accelerata richiedono comunemente circa20–50 passaggi di denoising sequenziali per immagine, secondo un'analisi di velocità, incoerenza e problemi pratici nella generazione da testo a immagine.
Lo stesso processo iterativo aiuta a spiegare perché un prompt può fallire un'istruzione. Una previsione sull'allineamento del testo, sull'anatomia o sul numero di oggetti può influenzare i passaggi successivi. Un prompt più lungo può anche peggiorare le cose se combina soggetti o stili in competizione, lasciando il modello con un insieme confuso di indicazioni.
| Cosa noti | Perché il meccanismo lo fa | Cosa provare dopo |
|---|---|---|
| Stesso prompt, immagine diversa | Ogni esecuzione parte da un nuovo rumore casuale e approssima | Nome, composizione e punto di vista, quindi rigenera |
| Mani, arti o conteggi anomali | Gli errori possono accumularsi in circa 20-50 passaggi | Usa meno persone, semplifica la posa, poi effettua una modifica |
| Scritte interrotte o extra | Il testo è difficile da mantenere allineato nei pixel | Usa parole molto brevi o aggiungi il testo al di fuori del modello |
| Più dettagli hanno peggiorato la situazione | Concetti in competizione strappano l'embedding | Scegli un soggetto, relazioni chiare e uno stile |
| La generazione risulta lenta | I passaggi vengono eseguiti in sequenza, non come scrittura a pixel singolo | Pianifica diversi tentativi invece di un passaggio perfetto |
Una rappresentazione latente compressa può ridurre il calcolo, ma crea anche un limite massimo di qualità imposto dall'autoencoder. Se la compressione perde qualcosa, la successiva rimozione del rumore non sempre riesce a recuperarla. Ecco perché un'immagine accattivante è la prova di un risultato riuscito, non la garanzia che il modello risolverà in modo affidabile ogni prompt.
La distillazione e la modellazione della coerenza sono sviluppi da seguire. Mirano a ridurre la generazione a una o due valutazioni anziché a molti passaggi di diffusione, il che potrebbe rendere la creazione di immagini più reattiva per i flussi di lavoro creativi mobili e ad alto volume. Questa direzione non significa che ogni attuale app per immagini generi già in uno o due passaggi.
Per i creatori, la risposta pratica è specificare composizione, relazioni tra i soggetti, fotocamera o punto di vista e vincoli di output. Tratta quindi un risultato imperfetto come un'inferenza fallita, non come un verdetto sull'idea: rigenera quando la composizione è errata o modifica la parte che non ha funzionato. Quando confronti gli strumenti, concentrati su quale gestisce la tua attività ricorrente e il flusso di lavoro di correzione; questapanoramica dei modelli da testo a immaginefornisce un altro punto di partenza.
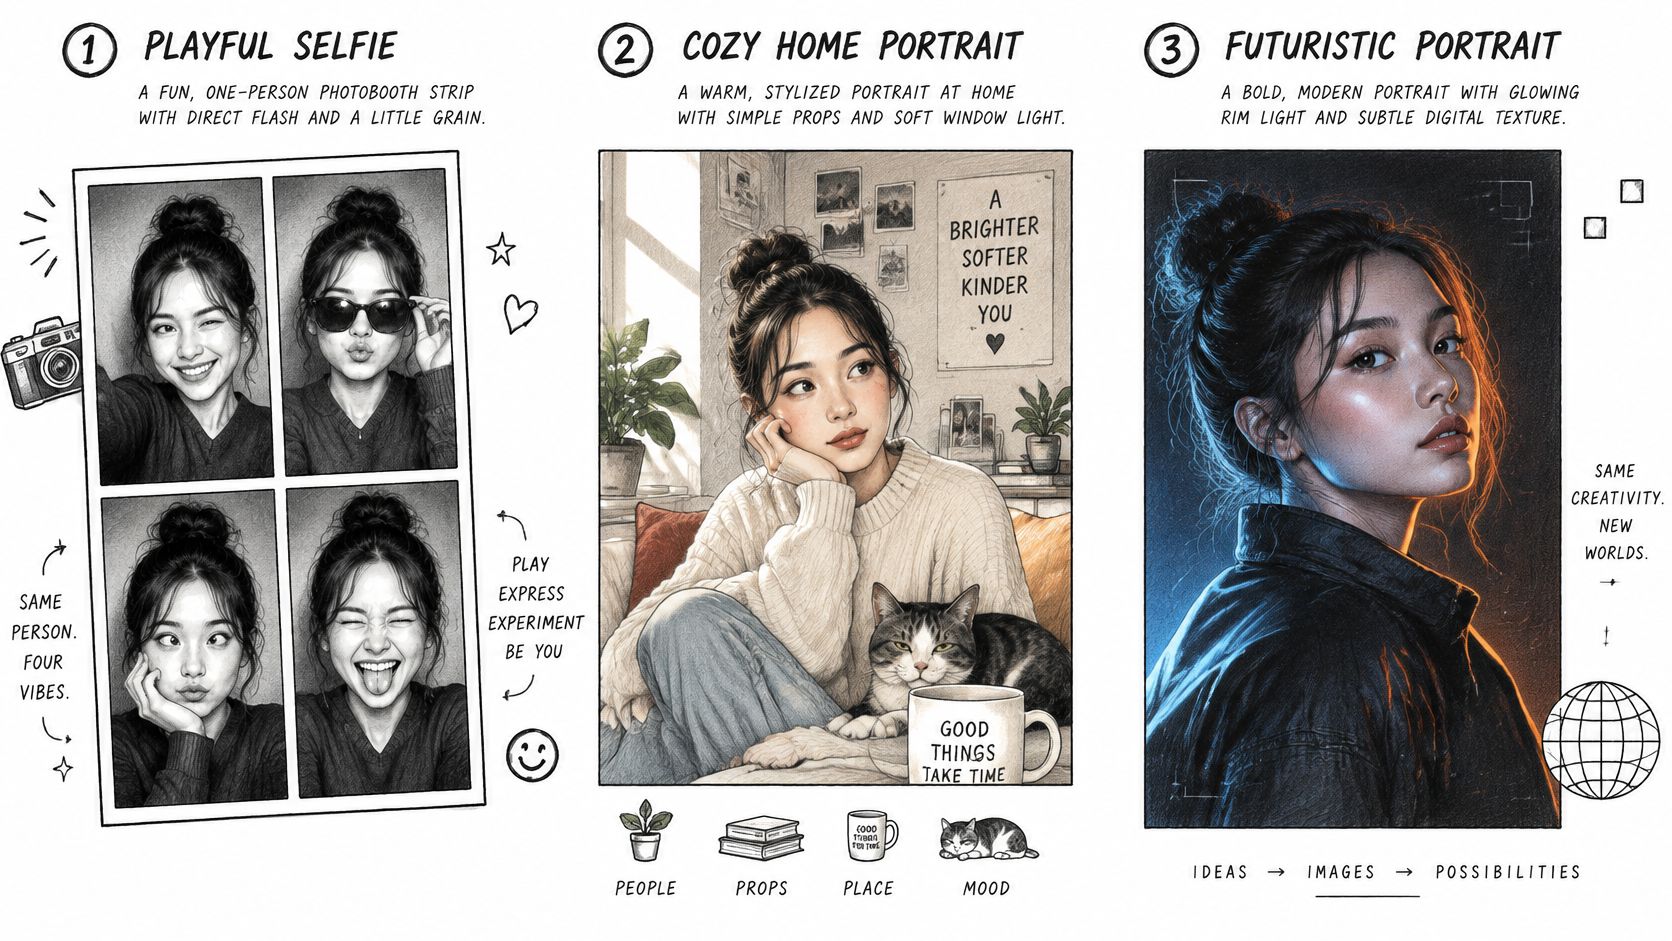
La stessa abitudine di scrittura dei prompt può servire per la trasformazione di un selfie, un ritratto atletico o il concept di un personaggio. In ogni caso, fornisci prima al modello le istruzioni strutturali, quindi utilizza i dettagli che supportano l'aspetto desiderato. Ecco tre prompt che puoi adattare.
Selfie in stile fototessera:“Una persona con un'espressione giocosa, flash diretto della fotocamera, layout a striscia di quattro foto, leggera grana della pellicola.” Le parole “una persona” e “layout a striscia di quattro foto” forniscono al modello il soggetto e la composizione iniziale da stabilire. “Flash diretto della fotocamera” definisce l'illuminazione; “leggera grana della pellicola” è un dettaglio superficiale. Tralascia etichette di stile extra che competono con il look della striscia fotografica.
Per vedere il tipo di trasformazioni di ritratti che possono ispirare nuove idee, dai un'occhiata all'esempio qui sotto.
Ritratto atletico:“Corridore a metà falcata su una pista, postura determinata, semplice abbigliamento sportivo scuro, luce laterale.” “Corridore a metà falcata” e “postura determinata” aiutano a determinare la posizione del corpo e la forma generale. La pista e la luce laterale collocano il soggetto in un contesto chiaro. Non accumulare diversi stili di abbigliamento o stati d'animo su un prompt che richiede già una posa leggibile.
Personaggio per una copertina o merchandising:“Un personaggio fantasy, cappotto verde bosco e sciarpa di rame, semplice sfondo crema, nessun testo.” Il soggetto e i dettagli dell'abbigliamento forniscono al generatore un obiettivo visivo conciso; lo sfondo semplice mantiene l'attenzione sul personaggio. Tralasciare il titolo è deliberato. Aggiungi scritte accurate in seguito anziché affidarti al modello di immagine per comporre il titolo di una copertina.
Per un flusso di lavoro quotidiano, starryai ti consente di iniziare da un prompt di testo o da un selfie, generare variazioni di immagine e utilizzare Modifica quando una mano, uno sfondo o un ritaglio non sono perfetti. Mantieni il soggetto, il layout e lo sfondo chiari nel prompt iniziale. Quindi regola solo il dettaglio fallito anziché riscrivere tutto.
Un segnale di provenienza può mostrare che un'immagine è stata generata o elaborata dall'intelligenza artificiale. Non stabilisce che tu abbia l'autorizzazione a utilizzare ogni elemento, che un marketplace consenta l'immagine o che il suo contesto sia veritiero. Le credenziali dei contenuti e le filigrane invisibili possono registrare o segnalare la storia di un'immagine, sebbene il ritaglio, la compressione o una modifica sostanziale possano rendere difficile rilevare una filigrana. Nessun segnale visibile dimostra che un'immagine sia una fotografia.
Per copertine di libri, merchandising, avatar e post di brand, salva il modo in cui è stata creata l'immagine e rivedila prima della pubblicazione:
Un'etichetta può spiegare il processo di un'immagine, ma devi comunque giudicare cosa rappresenta e se hai il diritto di utilizzare i suoi ingredienti. In starryai, salva il tuo prompt accanto all'immagine generata, quindi rigenera o modifica l'anatomia o il testo difettosi. Esamina il file finale prima di pubblicarlo o venderlo.
starryai offre un generatore di immagini AI gratuito e una suite creativa per trasformare prompt di testo, selfie ed emoji in grafica visiva. Prova un prompt chiaro, confronta i risultati evisita starryaiper sperimentare il flusso di lavoro di generazione e modifica.


