

Scritto daMo Kahnil


Hai trovato l'immagine di riferimento. L'illuminazione è esattamente quella giusta, il soggetto ha l'espressione che desideri e la composizione sembra naturale. Poi provi a descriverla e il risultato viene fuori come un ritratto generico con luce piatta, colori casuali e senza alcuna della tensione originale.
Questa è la sfida principale dietro i flussi di lavoroda immagine a prompt. Uno strumento può identificare un volto, una sedia o un tramonto, ma una ricreazione utile dipende da dettagli come la direzione della luce, la resa dell'obiettivo, la gerarchia spaziale, la texture e lo stile visivo. L'ingegneria inversa manuale ti dà il controllo su quei dettagli, mentre l'analisi automatica può comunque velocizzare le parti che gli umani trovano noiose.
Ogni creatore alla fine salva un'immagine che non sa spiegare bene. Potrebbe essere un ritratto lunatico con una stretta striscia di luce da una finestra, una foto di prodotto con ombre insolitamente morbide o una composizione editoriale in cui lo spazio vuoto fa sembrare il soggetto prezioso. Sai che l'immagine funziona, ma "donna alla scrivania, illuminazione cinematografica, alta qualità" non catturerà il perché.
Il problema è che le descrizioni delle immagini di solito iniziano con gli oggetti invece che con le relazioni. Una didascalia potrebbe identificare una persona, una scrivania, un taccuino e una lampada. Potrebbe non notare che la persona è seduta fuori centro, la lampada crea una pozza calda contro una stanza più fredda e la scrivania guida l'occhio in diagonale verso il viso. Queste omissioni contano più dell'elenco degli oggetti.
La maggior parte dei sistemi da immagine a prompt segue uno schema sensato. Un modello di visione-linguaggio analizza il riferimento, quindi un LLM propone del testo che potrebbe ricrearlo. Un approccio documentato utilizza un processo in due fasi che confronta il riferimento con un'immagine generata prima di redigere i prompt di inversione candidati, il che rende il flusso di lavoro più utile rispetto alla semplice creazione di didascalie (l'approccio di reverse-prompting descritto).
). Altre pipeline combinano la didascalia BLIP con la ricerca di somiglianza CLIP. Il sistema crea una didascalia, recupera le parole chiave vicine da un database di prompt utilizzando gli embedding delle immagini e combina tali parole chiave con la didascalia (una pipeline in stile CLIPInterrogator documentata). Ciò può far emergere un linguaggio di stile utile, ma può anche produrre un prompt affollato pieno di termini vagamente correlati.
Regola pratica:Usa l'estrazione per generare indizi, non per prendere la decisione creativa al posto tuo.
La storia più ampia spiega perché questi sistemi sono diventati pratici. Il dataset Conceptual Captions di Google, introdotto nel 2018, conteneva circa3,3 milioni di immagini di addestramento, insieme a28.000 immagini di validazione22.500 immagini di test, creando la scala necessaria per i sistemi immagine-test per collegare i pattern visivi con il linguaggio(Il resoconto storico di OpenAI su DALL·E e sull'apprendimento immagine-test). L'annuncio di DALL·E da parte di OpenAI il5 gennaio 2021ha contribuito a spostare la generazione di immagini guidata da testo da dimostrazioni di ricerca a una categoria di prodotti mainstream.
Questa scala non elimina il divario di descrizione. Rende possibile l'assistenza automatizzata, ma l'occhio umano deve comunque decidere quali fatti visivi definiscono il riferimento. Un flusso di lavoro ibrido utile combina la vastità di una macchina con il giudizio di un creatore. Per un contesto sul motivo per cui immagini e linguaggio lavorano insieme in primo luogo, consulta questa guida all'intelligenza artificiale multimodale.
Una descrizione forte non riporta tutto ciò che è visibile. Identifica i dettagli che controllano l'identità dell'immagine generata. Inizia dal soggetto, ma non fermarti lì. Una traduzione utile da immagine a prompt di solito richiede quattro livelli collegati:illuminazione, composizione, colore e stile.
Chiedi da dove proviene la luce, quanto appare grande la sorgente e cosa succede nelle ombre. Una luce frontale morbida produce un volto diverso rispetto a una piccola sorgente direzionale posizionata in alto su un lato. Una luce di taglio decisa separa un soggetto dallo sfondo, mentre una luce diffusa e nuvolosa riduce il contrasto e conferisce ai materiali un aspetto più tranquillo.
Descrivi la qualità anziché cercare subito un aggettivo alla moda. "Luce principale calda da sinistra rispetto alla camera, riempimento ambientale freddo, ombra delicata sotto il mento" fornisce a un generatore indicazioni più utilizzabili rispetto a "bellissima illuminazione cinematografica". Se l'immagine contiene luci pratiche, finestre o riflessi, includili solo quando influenzano la scena.
La composizione è la disposizione del peso visivo. Nota se il soggetto è centrato, posizionato su un terzo, tagliato strettamente o circondato da uno spazio negativo intenzionale. Registra l'angolazione della telecamera, la distanza apparente, la posizione dell'orizzonte e le relazioni di profondità.
Un'angolazione bassa può far sentire monumentale un oggetto ordinario. Una vista dall'alto trasforma un tavolo in un pattern grafico. Un primo piano poco profondo con uno sfondo lontano crea un ordine di lettura diverso rispetto a una scena piatta e uniformemente a fuoco. Queste relazioni spesso contano più dell'elencare ogni oggetto.
Estrai prima la palette dominante, poi identifica gli accenti. Potresti vedere salvia tenue, crema e carbone con un singolo dettaglio arancione. O la scena potrebbe basarsi su blu profondi, toni della pelle chiari e riflessi ambrati. Evita di nominare colori che sono tecnicamente presenti ma visivamente irrilevanti.
Il colore ha anche una distribuzione. Chiedi se la palette è concentrata sullo sfondo, riservata al soggetto o ripetuta attraverso piccoli accenti. Una "giacca rossa" è meno informativa di "una singola giacca rosso saturo contro un'architettura grigia desaturata".
Lo stile include il mezzo, l'epoca, la finitura e il riferimento culturale. Decidi se l'immagine sembra una fotografia in studio, un servizio di moda editoriale, un fotogramma di pellicola analogica, un poster grafico, una pittura a olio, un rendering 3D o un concept art disegnato a mano. Quindi descrivi le qualità della superficie che supportano tale lettura, come grana, alonatura, consistenza del pennello, riflessi lucidi, fibre di carta o bordi vettoriali puliti.
I prompt più forti descrivono come le scelte visive lavorano insieme, non solo ciò che appare nell'inquadratura.
Una sequenza pratica èsoggetto, azione, ambientazione, composizione, illuminazione, colore, materiale e stile. Questo ordine mantiene il prompt leggibile e dà al modello una gerarchia anziché un mucchio di descrittori disconnessi. Per una base più ampia, usa questa introduzione alprompt engineering per principianti.
L'estrazione manuale funziona meglio quando rimandi la scrittura. Guarda prima l'immagine, riducila a decisioni visive e solo dopo trasforma quelle decisioni in linguaggio. L'obiettivo non è descrivere ogni pixel. È identificare gli attributi che un'altra immagine deve preservare.
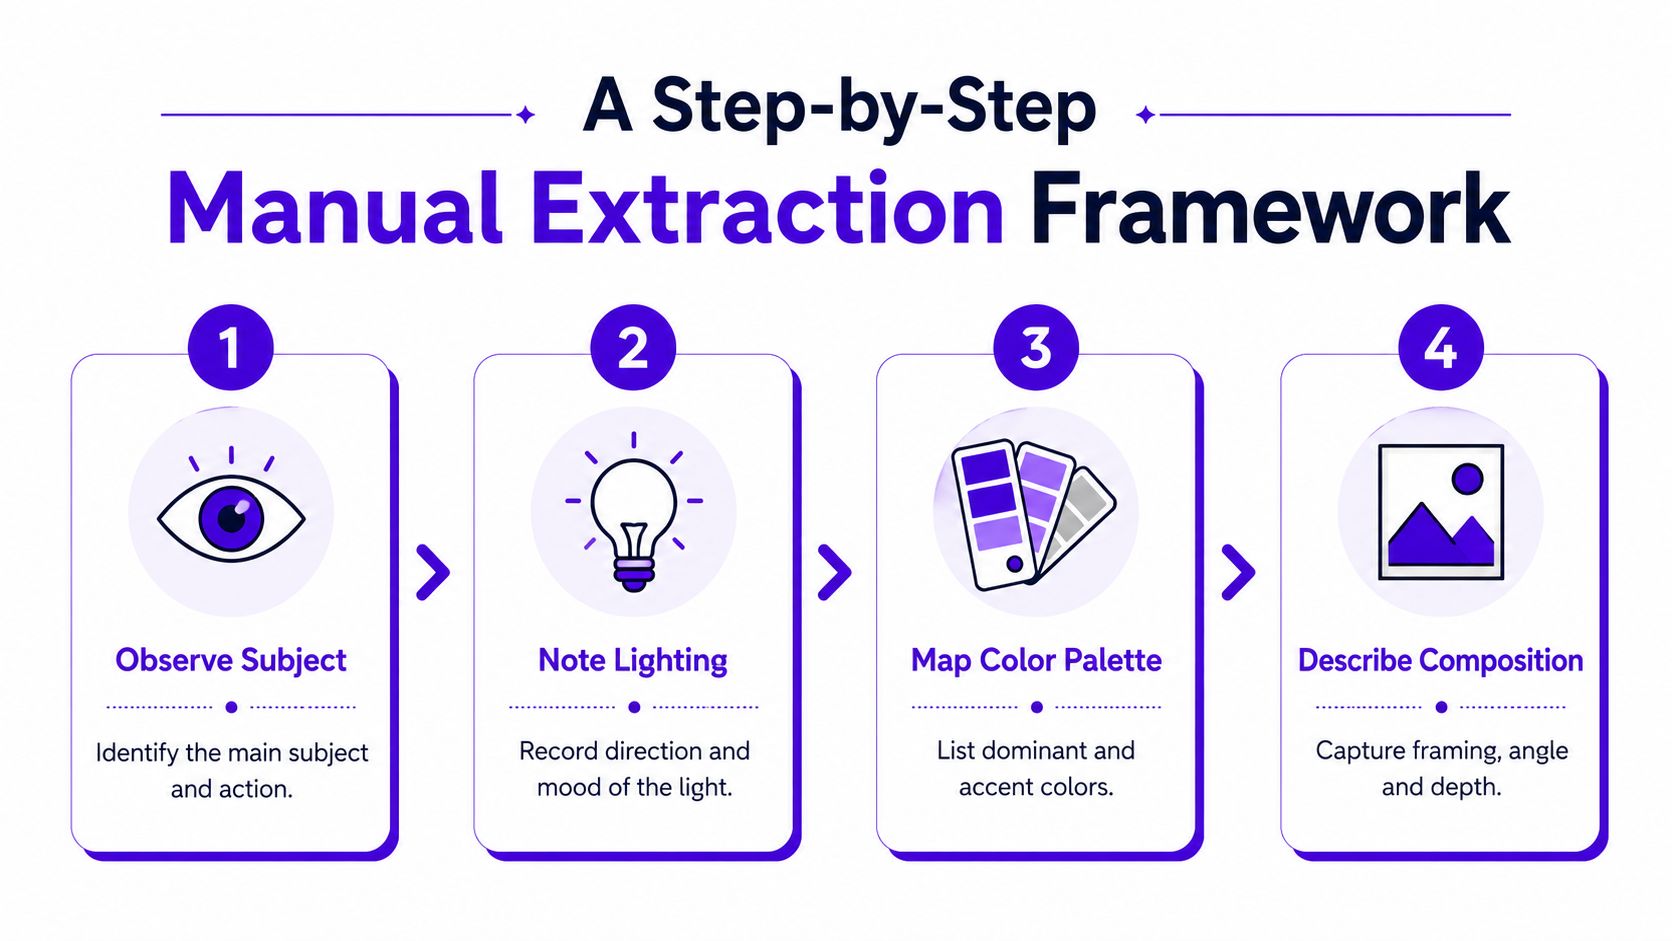
Nomina il soggetto principale in termini concreti, poi dichiara cosa sta facendo. "Persona" è debole. "Giovane donna chinata su una scrivania di legno, che guarda verso un album da disegno" ti dà identità, postura e azione.
Separa gli elementi primari da quelli secondari. Al soggetto focale viene data la descrizione più chiara. Gli oggetti di sfondo dovrebbero apparire solo se stabiliscono il luogo, la scala o l'atmosfera. Un ritratto può aver bisogno della persona, della posa, dell'abbigliamento e dell'espressione, ma non di ogni libro sullo scaffale.
Trova la regione più luminosa e traccia la direzione delle ombre. La fonte è in alto, laterale, frontale, retroilluminata o sparsa sull'intera scena? Quindi descrivi la qualità: dura, diffusa, fosca, lucida, a basso contrasto o scolpita nettamente.
Per un ritratto d'atmosfera, potresti registrare una stretta fonte di luce calda da una finestra sulla destra, una profonda caduta di luce sulla guancia opposta e uno sfondo scuro. Per lo scatto di un prodotto commerciale, potresti notare un'ampia illuminazione frontale, riflessi controllati, uno sfondo chiaro e una morbida ombra di contatto. Lo stesso oggetto può sembrare intimo o commerciale a seconda di questo livello.
Scrivi il colore di sfondo dominante, il colore principale del soggetto e l'accento più forte. Poi aggiungi osservazioni sui materiali. Carta opaca, metallo spazzolato, vetro bagnato, lana lavorata a maglia, pelle, plastica lucida e cemento grezzo rispondono tutti alla luce in modo diverso.
Il linguaggio dei materiali aiuta a evitare che un prompt diventi visivamente generico. "Bottiglia nera" descrive un oggetto. "Bottiglia di vetro nero opaco con un riflesso sobrio e gocce di condensazione" descrive come l'oggetto dovrebbe essere reso.
Registra inquadratura, angolazione, ritaglio e profondità. È un primo piano, un campo medio, una disposizione dall'alto, una scena ampia o un layout di prodotto centrato? Nota se il soggetto guarda la camera e se lo sfondo è compresso o ampio.
Ispeziona il testo incorporato separatamente. Lettere leggibili, etichette, insegne ed elementi di interfaccia richiedono un passaggio a parte perché i generatori di immagini potrebbero trattarli come texture visiva anziché come linguaggio. L'OCR può aiutare a identificare le parole, ma dovresti comunque decidere se il testo appartiene all'output finale o se debba essere aggiunto in seguito in uno strumento di design.
Un foglio di lavoro per l'estrazione compatto potrebbe apparire così:
Traduci quegli appunti in un primo prompt, poi confronta il risultato con il riferimento. Non aggiungere ogni dettaglio mancante in una sola volta. Modifica il livello che ha causato la discrepanza, così sai quale correzione ha aiutato.
Una volta chiari gli appunti visivi, puoi usarli come informazioni di guida anziché sperare che un'immagine caricata contenga l'intero concetto. starryai ti consente di lavorare da selfie, prompt di testo ed emoji, mentre il suo flusso di lavoro basato sull'immagine unisce un'immagine caricata a indicazioni scritte. Questo lo rende adatto a testare l'atmosfera, la posa, la tavolozza o la trasformazione di un riferimento senza trattare l'immagine sorgente come un set completo di istruzioni.
Carica il riferimento o un'immagine di base correlata, quindi inizia con il soggetto e la composizione. Un primo prompt pratico potrebbe descrivere unritratto a tre quarti di una donna seduta a una scrivania di legno, china su un taccuino, con il soggetto posizionato nel terzo destro dell'inquadratura. Aggiungi solo l'illuminazione e la tavolozza che definiscono il riferimento.
La prima generazione è diagnostica. Se la posa è sbagliata, rivedi l'azione e il linguaggio della macchina da presa. Se la scena sembra troppo luminosa, regola la qualità della luce e la profondità delle ombre. Se l'immagine perde la sua identità, rimuovi i termini di stile decorativo e rafforza il soggetto, l'inquadratura e i materiali chiave.
I creatori spesso iniziano con "da sogno", "virale" o "cinematografico", per poi chiedersi perché il risultato sembri intercambiabile. Lo stile funziona meglio dopo che il generatore ha compreso la scena. Aggiungi "illustrazione digitale editoriale", "leggera grana della carta" o "morbidi bordi pittorici" dopo la descrizione strutturale, non prima.
Puoi anche utilizzare il flusso di lavoro di trasferimento dello stile di starryai quando il trattamento visivo dell'immagine di destinazione conta più del suo contenuto letterale. Il suo flusso di lavoro per gli schizzi inizia con una foto caricata e un prompt che descrive lo stile di schizzo desiderato, offrendoti un altro modo per separare la guida del soggetto dalla direzione estetica.
Usa gli strumenti di modifica per correggere un problema alla volta. Una sequenza utile è:
Questo video offre un riferimento visivo per passare da un'idea a un risultato generato:
Per un'introduzione più semplice all'interfaccia e al flusso di lavoro di base, usa questa guida a ungeneratore di immagini IA per principianti. L'obiettivo non è costringere un riferimento a diventare un duplicato esatto. È preservare le decisioni visive che contano, lasciando spazio a una nuova immagine per sviluppare i propri dettagli.
Il fallimento più comune è il disordine dei prompt. Un creatore vede un'immagine intricata, annota ogni oggetto visibile, aggiunge diversi nomi di stile e infine appicca termini di qualità per buona misura. Il generatore riceve troppe priorità in conflitto e produce un'immagine che contiene gli ingredienti ma perde il ritmo originale.
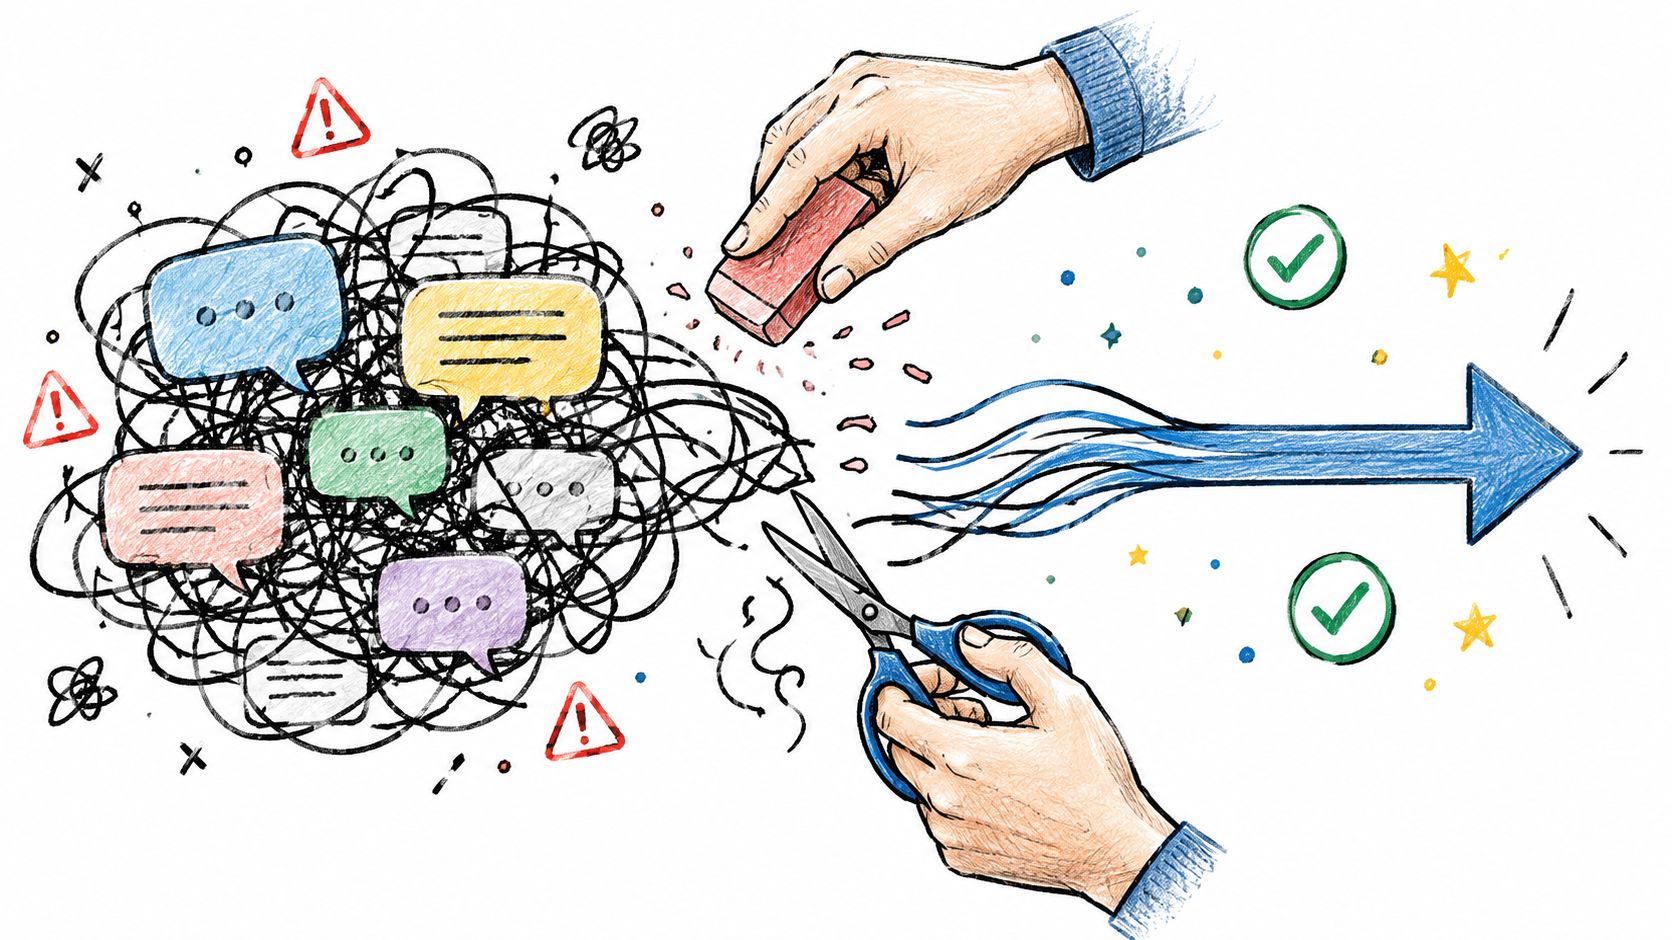
Quando un output sembra generico, non allungare automaticamente il prompt. Elimina prima gli aggettivi deboli. "Sbalorditivo", "epico" e "di alta qualità" spiegano raramente cosa fa funzionare il riferimento. Sostituiscili con istruzioni osservabili su inquadratura, luce, resa dell'obiettivo, consistenza e relazioni spaziali.
I descrittori in conflitto creano un problema simile. "Collage editoriale minimalista massimalista" può sembrare ambizioso in modo creativo, ma dà al modello indicazioni incompatibili. Scegli la logica visiva dominante, quindi descrivi i dettagli di supporto che sono d'accordo con essa.
Confronta l'immagine generata con il riferimento utilizzando una checklist fissa:
Modifica una categoria per ogni iterazione. Se modifichi insieme posa, tavolozza, illuminazione e stile, non saprai quale modifica ha migliorato il risultato. Lostudio ACM sull'ottimizzazione dei promptha scoperto cheda 100 a 500 iterazioni di ottimizzazione possono essere sufficienti per un'iterazione rapidae che il conteggio delle iterazioni e la durata dell'ottimizzazione non erano correlati in modo significativo con la soddisfazione dell'utente. Più test non sono automaticamente migliori. I test mirati lo sono.
Anche le ipotesi legali possono creare problemi quando si esegue il reverse engineering di un riferimento per scopi commerciali. Un prompt non è un documento magico di proprietà e l'output puramente generato dall'IA non è generalmente passibile di copyright negli Stati Uniti senza una significativa autorialità umana. La modifica, il compositing o la disposizione umana possono essere proteggibili, quindi rivedi laguida sul copyright per il lavoro generato dall'IAprima di utilizzare commercialmente un visivo ricreato.
Il flusso di lavoro affidabile è semplice: osserva, dai priorità, genera, confronta e modifica. L'automazione può proporre un linguaggio, ma l'analisi umana deliberata decide cosa merita di rimanere.
starryai ti offre un luogo pratico in cui combinare un'immagine caricata con un prompt di testo accuratamente estratto, per poi esplorare stili, trasformazioni e modifiche senza ricostruire il visivo da zero. Visitastarryaicon un'immagine di riferimento, annota il suo soggetto, la luce, la composizione e la tavolozza, e testa un prompt mirato anziché uno affollato.


