

Scritto daMo Kahnil
1 luglio 2026


L'IA multimodale è un tipo di intelligenza artificiale in grado di comprendere ed elaborare informazioni provenienti da più fonti contemporaneamente, come testo, immagini e suoni, in modo simile a quanto fanno gli esseri umani. È già una categoria di mercato reale, con una stima del settore che valuta il mercato globale dell'IA multimodale a1,6 miliardi di dollari nel 2024e prevedecirca 27 miliardi di dollari entro il 2034.
Probabilmente avverti già il divario che questo risolve. Digiti un prompt, ottieni un'immagine simile a ciò che desideri, ma vorresti poter caricare anche una foto di riferimento, descrivere l'atmosfera desiderata, magari aggiungere note vocali e fare in modo che lo strumento comprenda tutto insieme.
Questa è la grande idea alla base dell'IA multimodale. Non tratta la creatività come solo testo. Inizia a funzionare più come un collaboratore in grado di leggere le tue parole, guardare i tuoi riferimenti e collegare i pezzi in un'unica risposta. Per artisti, creatori di contenuti, autori indipendenti, persone con progetti secondari e social media manager, questo cambia ciò che l'IA può fare in un flusso di lavoro quotidiano.
Molti vecchi strumenti di IA sembravano simili a lavorare con qualcuno che poteva leggere solo appunti infilati sotto una porta. Se digitavi un prompt forte, potevano rispondere. Ma se volevi mostrare un selfie, indicare una palette di colori e dire "fa' in modo che questo sembri un poster fantasy da sogno", spesso il sistema non riusciva a combinare bene quei segnali.
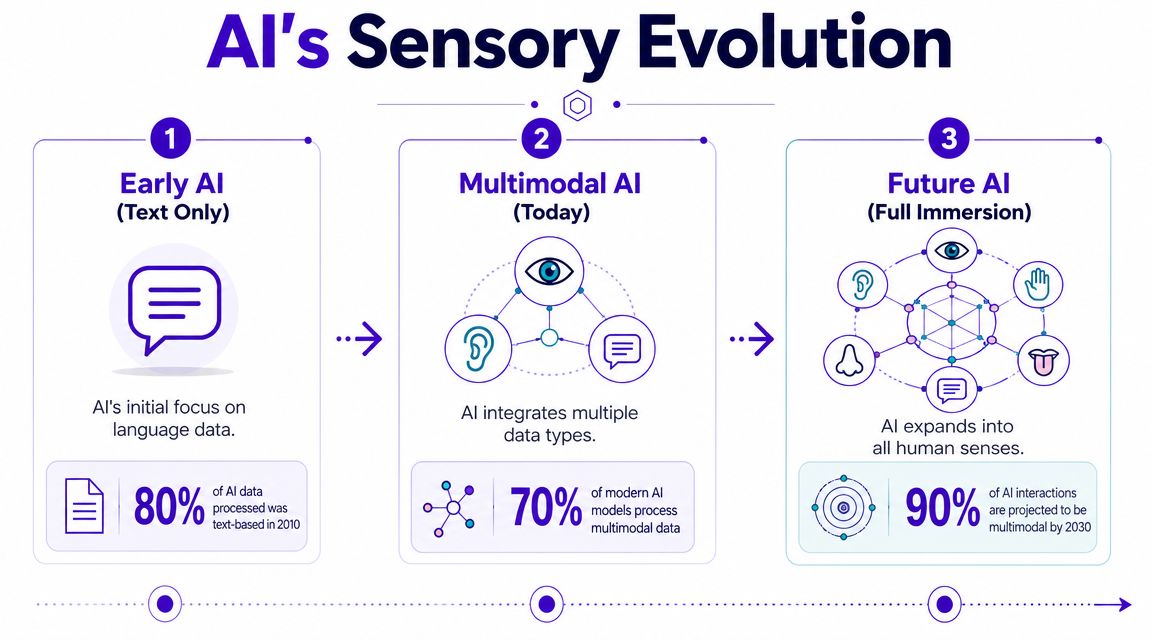
Ecco perchécos'è l'IA multimodaleè importante per i creatori. Segna il passaggio da sistemi a singolo input a strumenti in grado di operare sutesto, immagini, audio e videoinvece di trattare ciascun formato come un mondo separato.
I creator raramente lavorano con un solo formato alla volta. Un concept per TikTok potrebbe iniziare come un'idea per una didascalia, trasformarsi in una bacheca di riferimento, diventare un voiceover e infine concludersi come un breve video. Una copertina di un libro potrebbe iniziare con note sui personaggi, poi immagini d'atmosfera e infine esperimenti tipografici.
L'IA multimodale si adatta meglio a questa realtà rispetto ai vecchi strumenti perché è in grado di gestire un contesto più ricco.
Se vuoiottimizzare la produzione video con la sintesi vocale (TTS), il pensiero multimodale inizia a diventare efficace. Non hai più a che fare con attività isolate. Stai combinando diversi tipi di media in un unico sistema creativo.
Regola pratica:Più la tua idea dipende dalle relazioni tra parole, immagini e suoni, più l'IA multimodale sembrerà utile anziché una semplice trovata pubblicitaria.
Anche il lato commerciale riflette questo cambiamento. Una stima del settore valuta il mercato globale dell'IA multimodale a1,6 miliardi di dollari nel 2024e prevede che raggiungeràcirca 27 miliardi di dollari entro il 2034, implicando unCAGR del 32,7%secondo l'analisi del mercato dell'IA multimodale di Global Market Insights.
Se stai già lavorando con elementi visivi generati dall'intelligenza artificiale, è utile comprendere prima l'aspetto delle immagini, soprattutto grazie a guide come quella sucos'è un'immagine IA. L'IA multimodale si basa su queste fondamenta, aggiungendo poi ulteriori percezioni alla conversazione.
Il modo più semplice per comprendere l'intelligenza artificiale multimodale è confrontarla con la propria percezione. Quando incontri un cane, non elabori un solo segnale. Vedi la sua forma, senti il suo abbaiare, magari leggi il nome su una targhetta e il tuo cervello fonde questi indizi in un'unica percezione.
Un sistema di intelligenza artificialeunimodalefunziona più come uno specialista a senso unico. Può solo leggere del testo o solo classificare immagini. Un sistemamultimodalepuò collegare diversi tipi di input ed elaborare ragionamenti su di essi.
Spesso i lettori si confondono su questo punto. Multimodale non significa semplicemente che "l'app accetta caricamenti". Molti strumenti ti consentono di allegare un'immagine e incollare del testo, ma non comprendono necessariamente la relazione tra di essi.
Un sistema multimodale fa qualcosa di più profondo. Può guardare una foto, interpretare istruzioni scritte o parlate su quella foto e generare una risposta che rifletta entrambi gli input contemporaneamente.
Questo cambiamento è diventato una pietra miliare fondamentale nel settore. Le principali descrizioni di ricerca e industriali inquadrano l'IA multimodale attorno a modelli che elaborano congiuntamentetesto, immagini, audio e video, che è ciò che ha spinto l'IA da una specializzazione ristretta a sistemi che assomigliano più da vicino alla percezione umana, come spiegato nellaguida di TileDB all'IA multimodale.
| Tipo | Cosa gestisce | Dove risulta limitata |
|---|---|---|
| IA unimodale | Un tipo di dati alla volta | Può perdere il contesto presente in un altro formato |
| IA multimodale | Più tipi di dati insieme | È più complessa, ma può produrre risposte più ricche |
Per un creator, questa differenza è concreta.
L'IA multimodale inizia a sembrare utile quando la relazione tra gli input conta più di qualsiasi singolo input da solo.
La direzione creativa è solitamente stratificata. Potresti volere “questo volto”, “quella atmosfera pittorica”, “questo tono per la didascalia” e “quella energia nella colonna sonora”. I collaboratori umani comprendono questi insiemi in modo naturale. L'IA multimodale cerca di fare qualcosa di simile nel software.
Ecco perché sta comparendo in settori come la diagnostica sanitaria, i veicoli autonomi, la moderazione dei contenuti, il servizio clienti e la robotica nel mercato più ampio. Per i creatori, la conclusione è più semplice. L'IA sta migliorando nel gestire il contesto, ed è nel contesto che risiede lo stile.
Sotto il cofano, l'IA multimodale è meno magia e più coreografia. Immaginala come un piccolo team di traduttori che lavora dietro le quinte.
Un traduttore comprende il testo. Un altro comprende le immagini. Un altro gestisce l'audio. Ogni specialista prende un diverso tipo di input grezzo e lo trasforma in una forma che il sistema può confrontare e combinare.
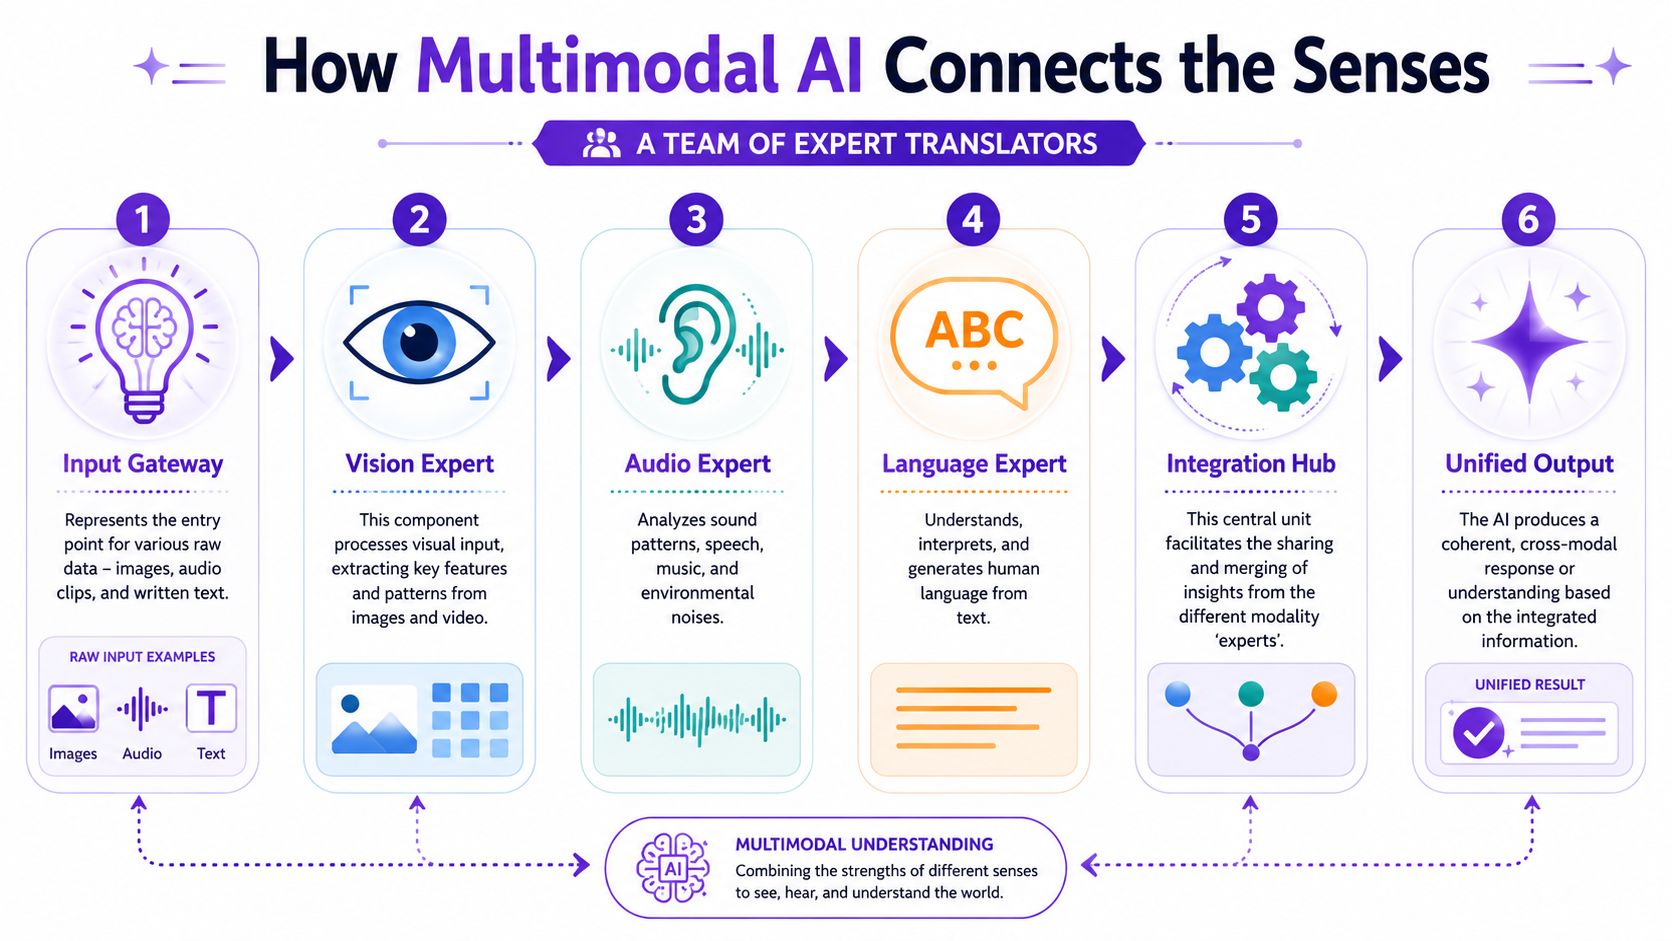
Un'architettura multimodale comune include unmodulo di input, unmodulo di fusionee unmodulo di output. In termini più tecnici, questi sistemi sono solitamente costruiti a partire daencoder specifici per modalitàpiù unstrato di fusioneche mappa testo, immagini, audio o video in uno spazio di embedding condiviso, come descritto nella guida di McKinsey sull'IA multimodale.
Ecco la versione in linguaggio semplice:
Input
Diversi encoder gestiscono diversi media. Il testo viene suddiviso in token. Le immagini vengono ridimensionate e codificate. L'audio viene spesso trasformato in caratteristiche che il modello può interpretare.
Fusione
Questo è il passaggio intermedio essenziale. Il sistema mappa quei diversi input in uno spazio condiviso in modo da poter confrontare il significato tra formati diversi.
Output
Un modello a valle produce la risposta. Tale risposta potrebbe essere testo, un'immagine, istruzioni, una classificazione o un altro risultato generato.
Senza la fusione, l'IA multimodale sarebbe solo un mucchio di specialisti separati. Lo strato di fusione è ciò che consente al sistema di collegare il tuo prompt alla tua immagine invece di trattarli come file non correlati.
Questo è ciò che abilita il ragionamento cross-modale. Un modello può usare un'immagine e un prompt di testo insieme per rispondere a una domanda o generare una risposta che rifletta entrambi.
Pensa allo strato di fusione come al tavolo delle riunioni in cui ogni specialista porta appunti nella stessa lingua.
Questa idea dello spazio condiviso spiega anche perché la tecnologia può supportare output flessibili. Una volta che diverse modalità sono incorporate nella stessa rappresentazione ad alta dimensionalità, il modello può supportare lagenerazione da qualsiasi cosa a qualsiasi cosa(any-to-any), il che significa che può accettare una o più modalità e produrre un'altra modalità come output, secondo quanto riportato da Milvus sui requisiti computazionali multimodali.
Se carichi un ritratto e aggiungi “trasformalo in un poster cyberpunk al neon”, il sistema non sta semplicemente sovrapponendo un'istruzione a un file. Sta cercando di allineare le caratteristiche visive del ritratto con il significato semantico del prompt prima di generare il risultato.
Ecco perché alcuni risultati sembrano stranamente centrati sul brief, mentre altri deviano. Il modello deve allineare correttamente più segnali.
Se desideri una base più ampia sull'ecosistema che circonda questi sistemi,spiegazione dei modelli di IA generativaè una lettura complementare utile. I modelli generativi creano l'output. Il design multimodale li aiuta a comprendere un mix più ampio di input prima di farlo.
Il modo più veloce per comprendere l'IA multimodale è usarla per qualcosa a cui tieni già. Per i creatori, ciò significa solitamente identità, stile, velocità o narrazione.
Questo è uno dei casi d'uso più chiari per i creatori. Inizi con un'immagine di te stesso, quindi aggiungi del testo che guida la trasformazione.
Un prompt come “trasforma questo ritratto in un ranger elfico al chiaro di luna con armatura d'argento e illuminazione pittorica” fornisce al modello due cose contemporaneamente: indizi di identità dalla foto e indizi di stile dal linguaggio. Il risultato può funzionare come avatar, aggiornamento del profilo, concept per un poster o fan art.
Per questo tipo di flusso di lavoro, strumenti comestarryai text to imagesono pertinenti perché supportano la creazione di immagini basata su prompt e si adattano ai creatori che desiderano un output visivo senza una configurazione tecnica.
A volte l'obiettivo non è “fammici sembrare diverso”. È “fa' in modo che questa idea assomigli di più a quell'estetica”.
Ciò potrebbe significare caricare un'immagine di riferimento per l'atmosfera e scrivere un prompt che specifichi il tono, la tavolozza o il genere. Un creatore che vende stampe su Etsy potrebbe usarlo per testare direzioni per collezioni cottagecore, retro sci-fi o dark academia. Un autore indipendente potrebbe usare lo stesso schema per concept di personaggi o esplorazione di copertine.
Se ti occupi di editoria, questa guida sullaselezione di generatori di IA per autori indipendentiè utile perché inquadra la scelta dello strumento attorno a flussi di lavoro reali per copertine e concept anziché su un astratto clamore sull'IA.
L'IA multimodale non si limita a generare. Può anche interpretare.
Puoi inserire un'immagine e richiedere:
Questo è utile quando ci si blocca nel dare un nome, pubblicare o rifinire un'idea che si riesce a vedere ma non si è ancora articolata.
Una breve demo rende la cosa più concreta:
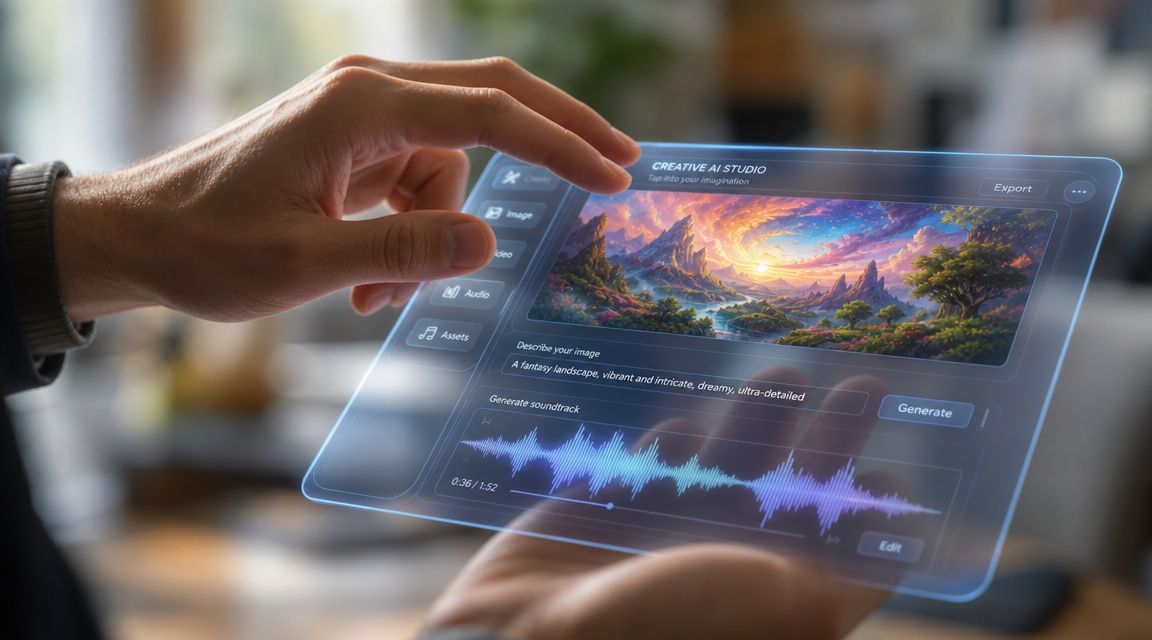
Per i creatori di video brevi, il salto interessante è combinare script, grafica e voce. Un concetto può iniziare come un gancio scritto, diventare un'immaginazione generata, per poi assumere narrazione o sound design.
Ciò non significa che ogni creatore abbia bisogno di uno stack di produzione completo. Significa che il muro tra "scrittura", "design" e "montaggio" si sta assottigliando. La stessa idea di base può ora muoversi in modo più fluido tra i formati, motivo per cui l'IA multimodale risulta particolarmente naturale per TikTok, reel, trailer e storytelling visivo.
Un buon prompt creativo non deve più sostenere l'intero lavoro da solo. I media di riferimento possono ora condividere il carico.
L'IA multimodale apre nuove porte creative, ma aumenta anche il costo per fare le cose nel modo giusto. Questi sistemi sono più esigenti rispetto ai modelli a singolo input perché devono elaborare diversi flussi di informazioni e allinearli in modo coerente.
Rispetto ai sistemi unimodali, i modelli multimodali richiedonosostanzialmente più capacità di calcolo e memoriaperché devono elaborare più codificatori e mantenere architetture più grandi. Ciò aumenta la latenza e la domanda di addestramento e inferenza, come notato nel precedente riferimento a Milvus collegato.
Quando un sistema può combinare immagini, testo, audio e video, può anche essere utilizzato per rendere contenuti fuorvianti più convincenti. Ciò include immagini false, contenuti vocali manipolati o post multimediali misti progettati per sembrare autentici.
I bias sono un'altra preoccupazione. Se il materiale di addestramento contiene rappresentazioni distorte, il modello può trasportare quei pattern su più formati contemporaneamente anziché in un solo canale.
Un modo concreto per utilizzare l'IA multimodale è semplice:
I creatori non devono temere la tecnologia. Devono però usarla con giudizio.
No.L'IA generativadescrive i sistemi che creano output come immagini, testo, audio o video.IA multimodaledescrive i sistemi che possono comprendere o lavorare su più tipi di input. Alcuni strumenti sono entrambi. Altri sono solo uno.
Un'app da testo a immagine può essere generativa. Un sistema che analizza un'immagine, legge il prompt e quindi genera un risultato è sia generativo che multimodale.
Sì. Non è necessario costruire modelli o comprendere la matematica del machine learning per iniziare. La maggior parte dei principianti può apprendere il concetto provando flussi di lavoro semplici, come caricare una foto, aggiungere un prompt e confrontare gli output.
Inizia con piccoli esperimenti:
Riduce il divario tra l'idea nella tua testa e i materiali che hai già. Invece di costringere tutto nel testo, puoi combinare riferimenti, linguaggio e talvolta suono o movimento.
Ciò è particolarmente utile per i creatori che pensano prima visivamente o che costruiscono su piattaforme in cui un singolo concetto deve diventare un post, una miniatura, una copertina, un voiceover o un breve video.
La direzione probabile è un'interazione più naturale. I creatori lavoreranno sempre più con strumenti in grado di accettare input misti in un unico flusso, per poi restituire output che sembrano più consapevoli del contesto.
Il cambiamento importante non è solo una migliore qualità. È una migliore collaborazione tra la tua intenzione e i media che fornisci.
Se vuoi provare questo tipo di flusso di lavoro in prima persona,starryaiè un'opzione per trasformare prompt, selfie e idee visive in immagini generate dall'intelligenza artificiale senza bisogno di una configurazione tecnica.


