

Geschreven doorMo Kahnop
26 juli 2026


Je bent waarschijnlijk op het punt aangekomen waarop je prompts behoorlijk zijn, je ideeën sterk zijn, en de resultaten toch nog net iets te generiek aanvoelen. Misschien blijft de held in je indie-roman eruitzien als een standaard fantasiepersonage, of neigen al je Etsy-mockups naar dezelfde flauwe esthetiek, hoe zorgvuldig je de prompt ook formuleert. Dat is meestal het moment waarop het trainen van een eigen AI-model minder aanvoelt als een technische nieuwsgierigheid en meer als een creatieve beslissing die je goed moet aanpakken.
Een indie-auteur wil dat een terugkerend personage er op elke cover, teaserafbeelding en personagekaart precies hetzelfde uitziet. Een Etsy-verkoper wil een merchandise-lijn die niet dezelfde internetesthetiek heeft die iedereen al gebruikt. In beide gevallen is de vraag niet "kan AI helpen", maar "welke weg past bij de klus".
Er zijn vier echte opties.Kant-en-klare modellenzijn het snelst en goedkoopst om mee te beginnen, en ze volstaan wanneer de output geen strikt gecontroleerde identiteit vereist.Retrieval-gebaseerde personalisatiewerkt wanneer de assistent antwoorden moet geven op basis van goedgekeurde bestanden, websites of bronnen in de cloud in plaats van het model zelf te wijzigen, wat in bedrijfsomgevingen vaak de standaardbetekenis is van "trainen op je data"aangepaste GPT-training en retrieval. Fine-tuningpast een bestaand vooraf getraind model aan voor een merkstem, een visuele stijl of een taakspecifiek patroon.Vanaf de basis trainenis de zwaarste weg, en de meeste makers hebben dit niet nodig.
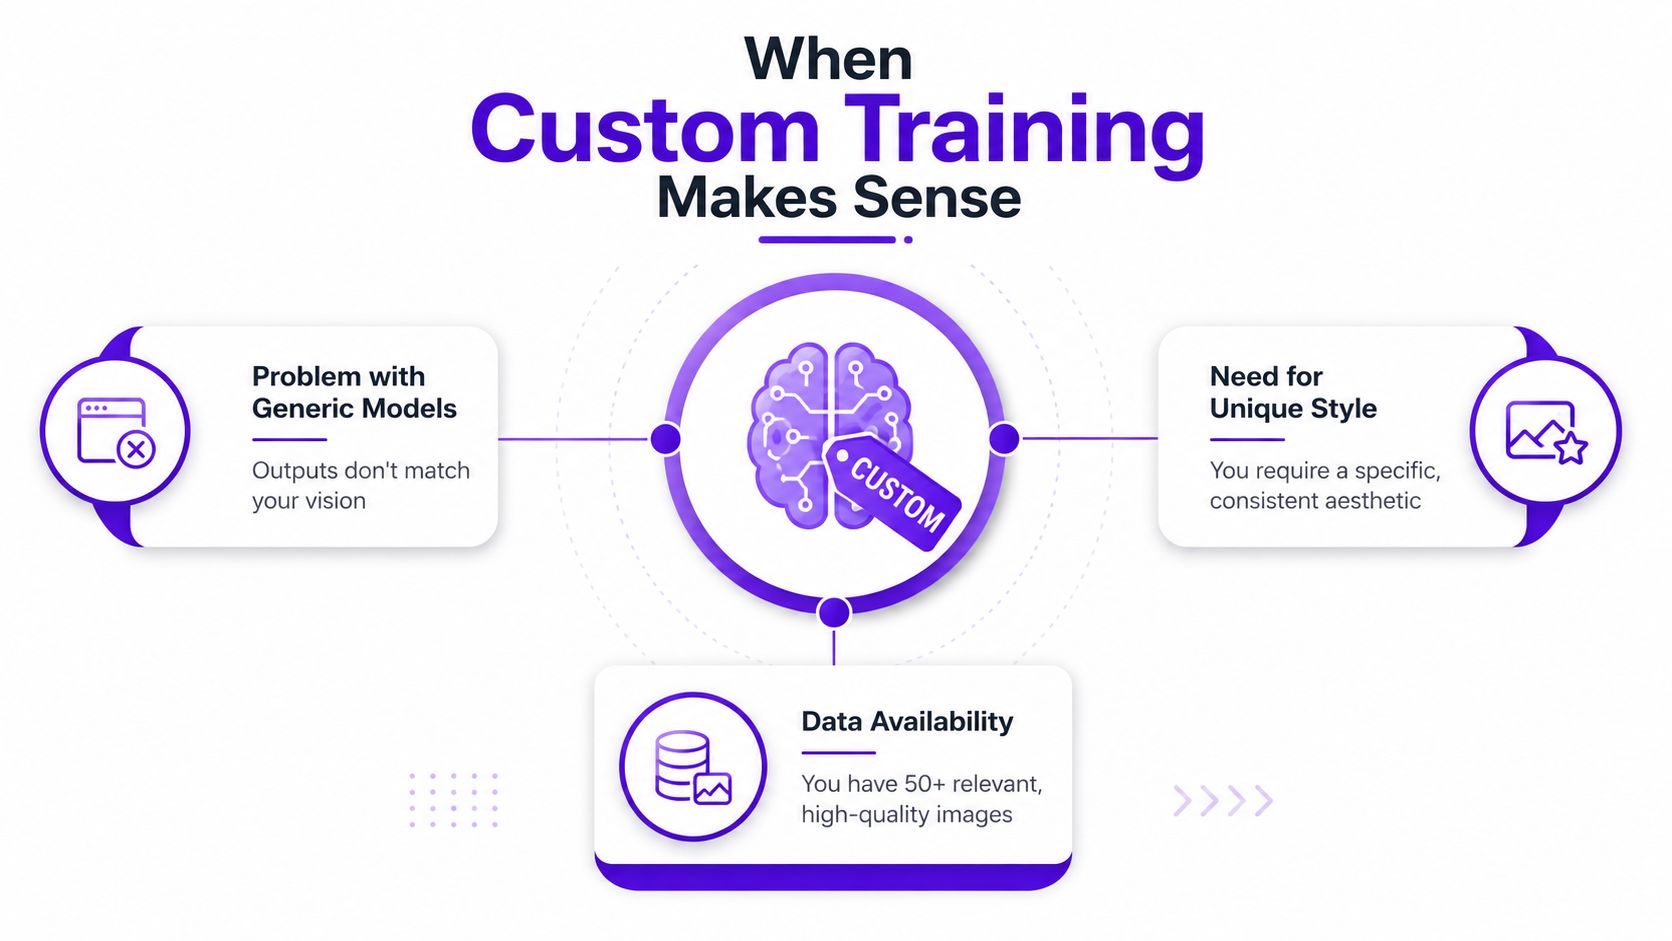
Praktische regel:train alleen aangepast als de generieke output je domein blijft missen, je maandelijkse inferentievolume hoog genoeg is om het extra werk te rechtvaardigen, of je eisen op het gebied van latentie en merkconsistentie strikt zijn.
Een nuttige historische marker isBERT in 2018, wat hielp om taakspecifieke fine-tuning bovenop vooraf getrainde funderingsmodellen te normaliseren. Google's oorspronkelijke BERT-werk rapporteerdestate-of-the-art resultaten bij 11 NLP-taken, waaronder een sprong van90,9% naar 94,9%op deGLUE-benchmarkin die tijd, wat laat zien hoe aangepaste modellen generieke benaderingen konden overtreffen wanneer ze werden afgestemd op een specifieke taakOracle's overzicht van AI-modeltraining. Diezelfde omslag is de reden waarom kleine teams nu een model kunnen aanpassen in plaats de hele boel vanaf nul op te bouwen.
Een snelle mentale controle helpt:
De dataset bepaalt meestal of je model gepolijst aanvoelt of vreemd uit de bocht vliegt. Dat geldt met name voor creator-workflows, waar één vage afbeelding, één verkeerd gelabeld onderschrift of één gedupliceerde referentie het resultaat richting eenheidsworst in plaats van een specifieke stijl kan duwen.
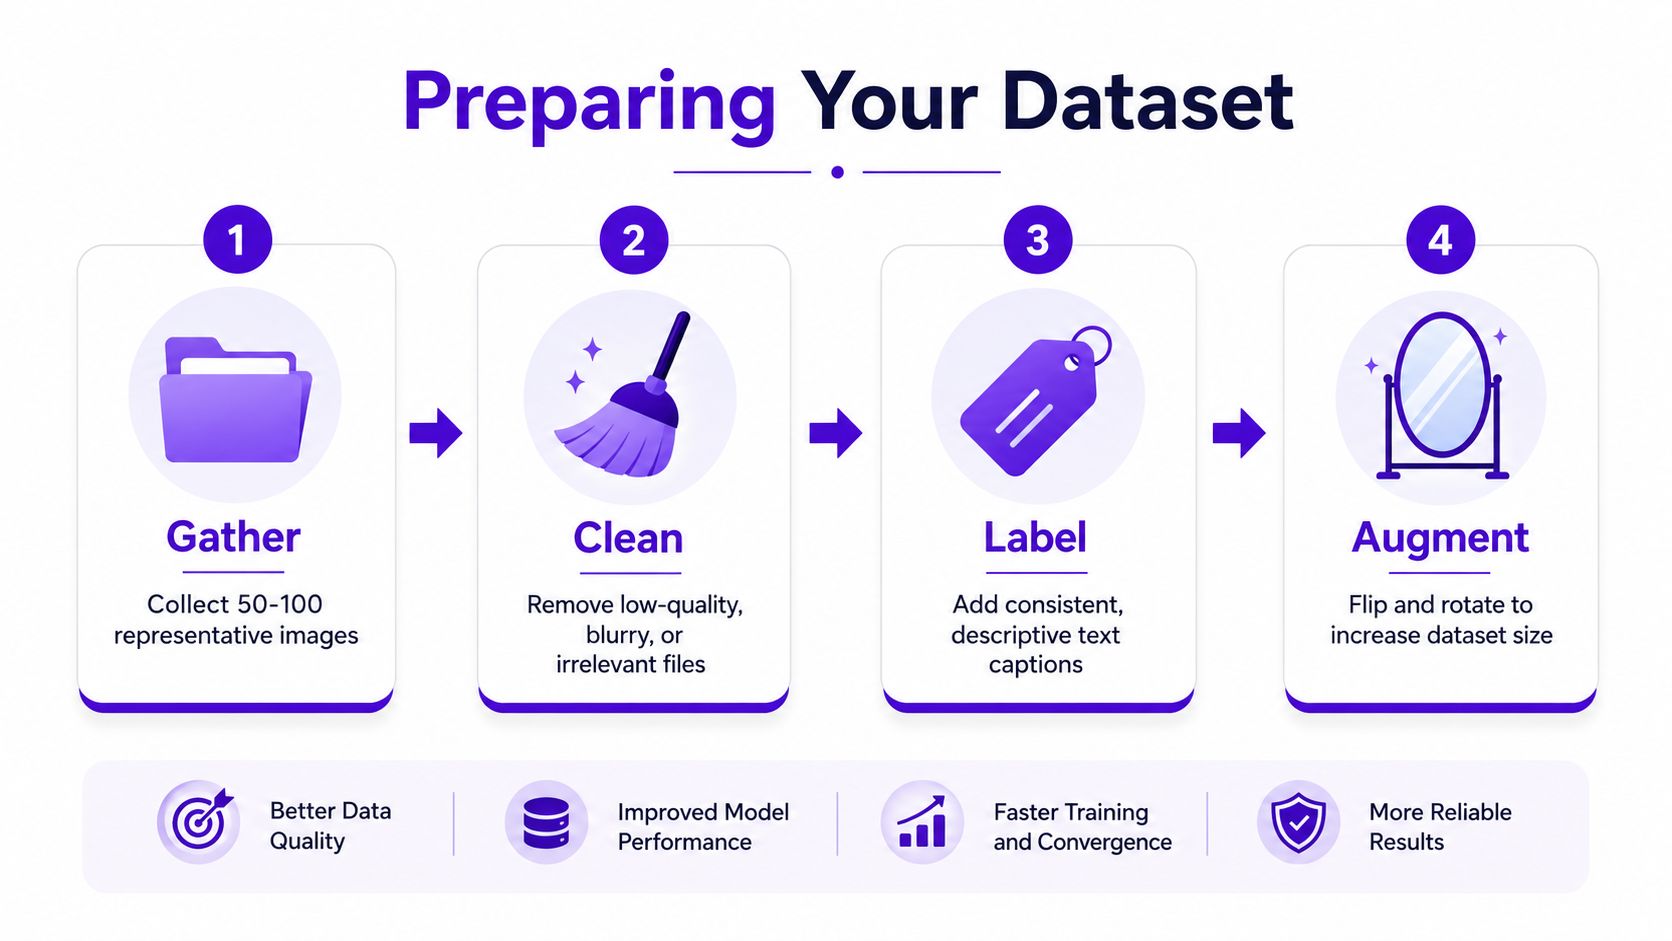
Begin met het verzamelen van alleen afbeeldingen of tekst die in het model thuishoren. Een gerichte set verslaat een brede stapel gemengd referentiemateriaal, omdat het model het patroon leert dat je het meest laat zien. Voor het maken van afbeeldingen is één praktisch startpunt12 tot 20 afbeeldingenmet bijschriften, en het bronmateriaal raadt ook eenminimum van 10 afbeeldingenaan wanneer bijschriften zijn inbegrepenafbeeldingstraining opzet.
Maak de set vervolgens grondig schoon. Verwijder duplicaten, bestanden van lage kwaliteit, irrelevante uitschieters en kapotte bijschriften. De reden is simpel: het model kan 'belangrijk' niet scheiden van 'toevallig' tenzij je data dat werk al voor hem heeft gedaan. De duidelijkste structuur blijft de klassieke splitsing,70 tot 80%voor training,10 tot 15%voor validatie, en10 tot 15%voor testendataset splitsing begeleiding.
Je validatieset is belangrijker dan veel beginners denken. Trainingsverlies kan blijven dalen terwijl het validatieverlies naar boven begint af te wijken, en die kloof is het vroegste teken van overfitting. Als het model je dataset aan het memoriseren is in plaats van de stijl te leren, zie je meestal geweldig uitz Ekomende trainingsvoorbeelden en teleurstellende nieuwe outputs.
Het meer operationele deel is bias en dekking. Een creator-model moet variatie in pose, belichting, hoek, achtergrond en kadrering bevatten, zodat het resultaat zich niet vastklampt aan één smalle look. Eén interne workflowreferentie die veel teams gebruiken voor datasetorganisatie isbegeleiding bij collectiebeheer, omdat het probleem vaak minder ligt bij het genereren van afbeeldingen en meer bij het netjes genoeg houden van de bronbibliotheek om van te trainen.
Houd bij elke dataset een notitie bij: waar deze vandaan kwam, wat je hebt verwijderd en waarom je de uiteindelijke voorbeelden hebt behouden. Dat archief bespaart uren later wanneer een model zich vreemd gedraagt en je de oorzaak moet traceren.
Creators hebben meestal niet de zwaarst mogelijke methode nodig. Ze hebben de methode nodig die de look waar ze om geven behoudt zonder tijd, rekencapaciteit of hun geestelijke gezondheid op te slokken. Dat is waarom de juiste keuze afhangt van of je het model een volledig gedrag probeert te leren, een lichte stijl, of gewoon een triggerwoord voor een visueel concept.
| Methode | Benodigde data | Trainingstijd | Best voor |
|---|---|---|---|
| Fine-Tuning | Meer gecureerde voorbeelden, bredere dekking | Langer | Merkstem, taakspecialisatie, diepere gedragsveranderingen |
| LoRA | Gemiddelde, gerichte dataset | Korter | Personages, stijlen, creator-visuals, snelle iteraties |
| Textual Inversion | Kleine conceptset | Kortste | Nieuwe tokens, eenvoudige stijlkeuzes, smalle visuele triggers |
Fine-tuningverandert meer van het gedrag van het model, dus het is de zwaardere optie wanneer je diepere aanpassing nodig hebt. Het is handig wanneer het onderliggende model het domein blijft missen, maar het vraagt ook meer van je data en je geduld. Een goed startpunt voor het conceptueel begrijpen van diffusion-stijl workflows is de bredere uitleg overBasisprincipes voor Stable Diffusion-training, omdat veel beeldenmakers deze methoden als eerste binnen dat ecosysteem tegenkomen.
LoRAis de optie waar veel makers naartoe trekken. Het is lichter, sneller en eenvoudiger om op door te itereren wanneer je een karaktergezicht, een terugkerende avatar of een specifieke omslagesthetiek traint. Het geeft je meestal genoeg controle om een stijl vast te zetten zonder een volledige modelherschrijving te erzien.
Textual inversionis de meest subtiele aanpak. Het werkt het best wanneer je gewoon een token nodig hebt dat betrouwbaar een specifiek visueel idee oproept. Als je doel is "laat deze eruitzien als mijn originele drakenmaskot", dan kan dat genoeg zijn. Als je doel is "zorg dat het merk ons hele brandsysteem begrijpt", dan is dat meestal niet zo.
Als het doel een herhaalbaar personage is, begin dan met de lichtste methode die je daar brengt. Direct overstappen op volledige finetuning voegt vaak complexiteit toe voordat het kwaliteit toevoegt.
Een eenvoudige beslissingsregel werkt goed. Kiestextual inversionvoor een smal concept,LoRAvoor het meeste stijl- of personagewerk gericht op makers, enfinetuningwanneer je brede gedragscontrole nodig hebt en je al over de datasetdiscipline beschikt om dit te ondersteunen.
Een eerste trainingsrun is minder dramatisch dan mensen verwachten. Je bent geen "magisch model aan het lanceren", je test of je dataset, captions en instellingen de output in de juiste richting kunnen bewegen zonder dat de stijlaltheid instort.
Begin met een basismodel dat al lijkt op je doeluse-case. Voor een personage uit een fantasieboekenreeks betekent dit meestal een visueel coherente basis in plaats van de meest algemene die beschikbaar is. Stel een conservatieve leersnelheid in zodat het model niet voorbij de look rent die je het probeert te leren. Te agressief, en de resultaten worden vaak snel bros of overfitted.
Gebruik checkpointing na elke epoch. Dat geeft je een terugrolpunt wanneer het model begint te driften, en het maakt vergelijking naast elkaar een stuk eenvoudiger. De praktische workflow beschreven in het bronmateriaal raadt ookslice-gebaseerde validatieen ablaties aan, wat betekent dat je kleine subsets van afbeeldingen of captions controleert om te zien welk onderdeel helpt bij debegeleiding van de trainingsworkflow.
Een eenvoudige creator-stijl lus ziet er als volgt uit:
Eenvoudige augmentatie helpt, maar het moet de identiteit van de set niet overnemen. Spiegelingen, bescheiden uitsneden en lichte kleuraanpassingen kunnen de sterkte verbeteren. Zware vervorming schaadt meestal de stijltrouw, vooral wanneer het trainingsdoel een herkenbaar gezicht, outfit of merklook is.
Als het model er geweldig uitziet op trainingsvoorbeelden maar gezichten begint af te vlakken of achtergrondartefacten herhaalt bij nieuwe prompts, stop dan de run en inspecteer de captions voordat je meer epochs toevoegt.
Voor een eerste run is de nuttigste vraag niet "heeft het getraind", maar "heeft het het soort output verbeterd dat ik nodig heb". Dat is het verschil tussen een technisch succesvolle taak en een nuttig instrument voor makers.
Aangepaste training wordt duur wanneer mensen de planningsfase overslaan. Een maker heeft geen financieel team nodig, maar ze hebben wel een ruw idee nodig van wanneer een aangepaste opstelling ophoudt een leuk experiment te zijn en een terugkerende infrastructurele beslissing wordt.
De ene gids schat dat aangepaste training economisch aantrekkelijk wordt boven ruwweg5 tot 10 miljoen aanroepen per maand, of wanneer de latentie onder50 ms custom model training guidemoet blijven. Voor de meeste makers is dat ruim buiten een typische boekomslag- of avatarworkflow. Een gehoste API of een lichte aangepaste workflow binnen starryai is op kleinere schaal meestal veel beter te verantwoorden.
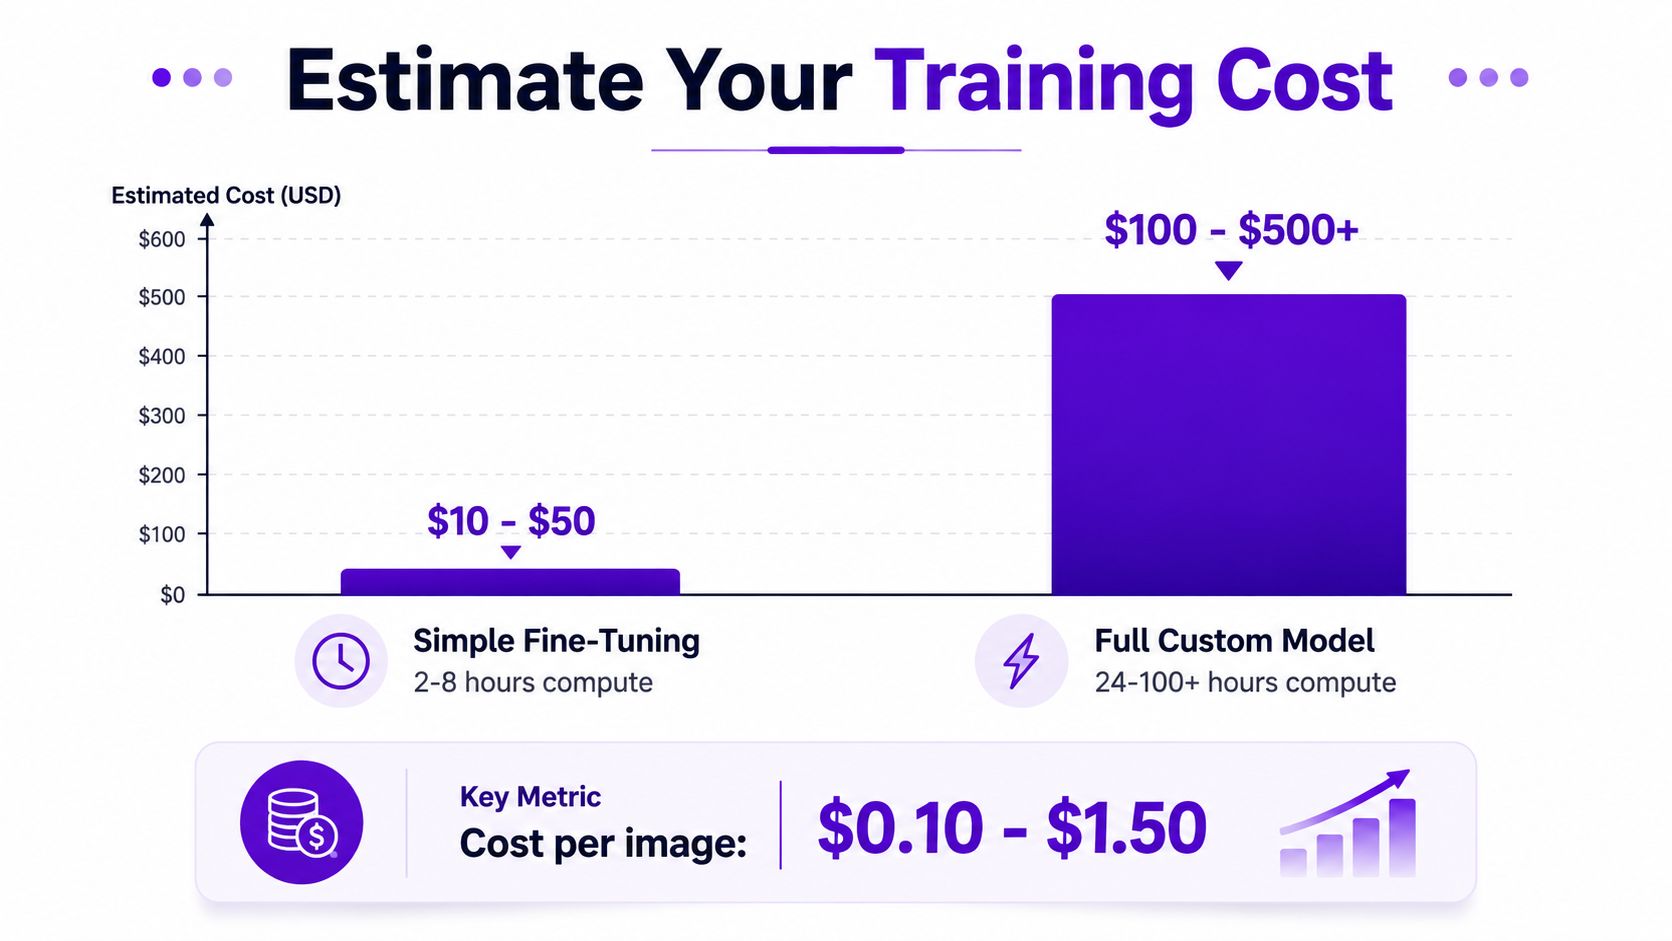
Een praktische manier om over uitgaven na te denken is per niveau:
| Trainingsniveau | Typisch berekeningsgevoel | Verwacht resultaat | Geschiktheid voor makers |
|---|---|---|---|
| Licht | Een korte run met een smalle dataset | Stijl- of conceptuitlijning | Avatars, maskotconcepten, eenvoudige merchandise-afbeeldingen |
| Gemiddeld | Meer iteratie en checkpointvergelijking | Consistentere karakter- of merklook | Indie-boekomslagen, terugkerende productvisuals |
| Zwaar | Veel experimenteercycli en strakkere afstemming | Diepere modelbesturing | Teams met strenge eisen op het gebied van latentie, domein of schaal |
Het bronmateriaal vermeldt ook een praktischekosten per afbeelding van $0,10 tot $1,50in de trainingscontext die in de grafiek wordt getoondkostenramingsgraphic. Dat is geen universele factuurformule, maar het is wel een handig planningsanker wanneer u beslist of u één concept wilt trainen of vijf.
Als u thuis experimenteert, is lokale training op een consumenten-gpu voldoende voor kleine tests. Gehoste platforms zijn beter wanneer u een kortere insteltijd en minder omgevingsgedoe wilt. De vraag is niet "wat is in theorie het goedkoopst", maar "wat brengt me naar een bruikbaar resultaat zonder een week te verspillen aan de installatie."
Reserveer budget voor iteratie, niet alleen voor de eerste run. De meeste nuttige modellen ontstaan nadat u een paar kleinere runs hebt vergelijken in plaats van alles te wedden op één reusachtige run.
Een model kan er geweldig uitzien en toch onbruikbaar zijn als de trainingsdata slordig is verzameld. Dat is het onderdeel dat veel makers onderschatten, vooral wanneer ze van plan zijn om prints, omslagen, avatar-pakketten of merchandise te verkopen die op de output zijn gebaseerd.
De schone regel is om decopyright, servicevoorwaardente respecteren, evenals degegevensbeschermingsregelsbij het verzamelen van webinhoud. Het advies van CIO raadt ook aan om gedetailleerde registers bij te houden van bronnen en voorverwerking, samen met strenge validatie, ontdubbeling, opschoning en regelmatige audits om vooroordelen te verminderenCIO over governance van trainingsdata. Dat zijn geen abstracte ethische punten, het zijn operationele maatregelen.
U moet ook de licentie van het basismodel scheiden van de rechten rondom uw getrainde resultaat. Een fijn afgestemd model neemt niet automatisch alle commerciële toestemming over die aan het funderingseffect is verbonden, en bedrijven van makers worden hier vaak de dupe van als ze daar zomaar van uitgaan. Als u niet zeker weet wat een platform toestaat, moet u destarryai-licentievoorwaardencontroleren voordat u betaald werk verzendt.
Voor gelijkenissen en fan-personages is toestemming belangrijk. Als uw model een herkenbaar persoon leert kennen, of als u traint rond het beschermde karakterontwerp van iemand anders, moet u dat behandelen als een kwestie van rechten, en niet alleen als een esthetische keuze. Dat is vooral belangrijk wanneer de output bedoeld is voor de verkoop.
Vooroordelen controleren is ook praktisch. Zoek naar systematische vertekening in geslacht, leeftijd, huidskleur, lichaamstype of culturele kenmerken in uw resultaten. Als de ene groep op dezelfde manier blijft worden neergezet, vertelt de dataset dat waarschijnlijk aan het model, zelfs als u dat niet zo bedoeld had.
Een snelle checklist voor rechten helpt:
Voor een breder beleidsveld duiken dezelfde eerlijkheidsproblemen ook op in andere AI-systemen, waarondereerlijkheid bij AI-gestuurde werving. De categorie is anders, maar de les is hetzelfde: als de data vertekend is, is de output dat ook.
Training is slechts de helft van het werk. Een model dat alleen in een notebook of een trainingsrun leeft, helpt een auteur, verkoper of social creator niet om iets te verzenden.
Evaluatie moet visueel beginnen. Vergelijk resultaten naast elkaar, gebruik prompt sweeps en vraag een paar echte gebruikers welke resultaten het dichtst in de buurt komen van de beoogde look. Voor projecten van makers vangt dat soort beoordeling fouten op die numerieke metrieken kunnen missen, vooral wanneer de output merkeigen moet aanvoelen in plaats van alleen technisch geldig.
Optimaliseer daarna voor de manier waarop het model zal worden gebruikt.Kwantiseringkan de bestandsgrootte verkleinen en helpen bij geheugenlimieten.Distillatiekan de inferentie versnellen. Prompt-engineering is nog steeds belangrijk, omdat een goed getraind model ondermaats kan presteren als de prompt voorbijgaat aan de manier waarop het is geconditioneerd.
Een implementatievolgorde die in de praktijk werkt, ziet er zo uit:
Creator-workflows omvatten vaak eigen avatars, boekomslagen en visuals voor social media, dus een platform dat die taken al ondersteunt, kan tijd besparen. starryai biedtStijltraining, waarmee gebruikers5 tot 60 afbeeldingenvan een consistente stijl, object of esthetiek kunnen uploaden om een aangepast stijlmodel te trainen. Dat maakt het een praktische optie wanneer het doel een herhaalbare look is in plaats van een volledige engineering-project.
Monitoring is belangrijk na de lancering. Controleer op nauwkeurigheidsdrift, vreemde randgevallen en verschuivingen in kwaliteit naarmate je het model nieuwe prompts voert. Als de outputs achteruit beginnen te gaan, is een kleine, samengestelde set moeilijke voorbeelden meestal nuttiger dan helemaal opnieuw beginnen.
Het model is nooit "klaar". Het blijft alleen bruikbaar als je de outputs blijft vergelijken met de look die je daadwerkelijk wilt.
Als je klaar bent om een ruw visueel idee om te zetten in iets herhaalbaars, begin dan metstarryai, test een gerichte stijlset en kijk of je project past in een lichtgewicht creator-workflow voordat je je vastlegt op een zwaarder trainingstraject.


