

Geschreven doorMo Kahnop


Tekst-naar-afbeelding AI haalt geen opgeslagen foto op: een tekstencoder zet je prompt om in getallen, waarna herhaalde ruisverwijdering willekeurige ruis verandert in een afbeelding die door die getallen wordt gestuurd. Latente diffusie, geïntroduceerd in invloedrijk onderzoek in 2022, maakt dat proces efficiënter door te werken met een gecomprimeerde representatie in plaats van met elke afzonderlijke pixel.
Het populaire advies om "gewoon een betere prompt te schrijven" mist een deel van de kern. Je woorden sturen een iteratieve gok aan, geen directe zoekopdracht of een collage, dus het resultaat kan tijd kosten, veranderen tussen runs, of handen, objecten en letters verkeerd krijgen. Het begrijpen van de stappen helpt je om duidelijkere prompts te schrijven en te bepalen wat je moet corrigeren wanneer een generatie mislukt.
Een tekst-naar-afbeeldingsapp haalt geen voltooide afbeelding op en stelt geen collage samen uit jouw woorden. Het gebruikt je prompt om een reeks gokken aan te sturen, te beginnen bij willekeurige ruis en dit geleidelijk te vormen tot een afbeelding. Hetonderzoek uit 2022 naar latente diffusie en het genereren van afbeeldingenbeschrijft hoe dit proces verloopt van ruis naar een afbeelding die bij de prompt past.
| Fase | Wat het model doet | Wat je ziet |
|---|---|---|
| Tekst-encoder | Een taalencoder zet de prompt om in numerieke embeddings | Nog niets zichtbaar |
| Start met ruis | Het genereren begint vanuit willekeurige Gaussiaanse ruis | Grijze statische ruis zonder objecten |
| Vroege ruisverwijdering | De eerste stappen bepalen de algehele vorm, objecten en indeling | Een wazige compositie |
| Late ruisverwijdering | Latere stappen voegen kleur, textuur en fijne details toe | Scherpere oppervlakken en randen |
| Decoderen | Een decoder zet de latente representatie weer om in pixels | De voltooid afbeelding |
De fasen verklaren waarom een vroege preview wazig kan lijken, maar toch de compositie van de scène laat zien. Tekstcodering bereidt numerieke instructies voor, terwijl de initiële ruis geen herkenbare objecten bevat. Vroege denoising (ruisonderdrukking) bepaalt de algemene compositie; latere stappen verfijnen voornamelijk kleuren, oppervlakken en randen.
Tekstbegeleidingbeschrijft hoe sterk de prompt de denoising stuurt. Sommige apps stellen dit in als een begeleidingsschaal (guidance scale). Een hogere instelling brengt het resultaat dichter bij de formulering, hoewel de afbeelding daardoor harder kan ogen. Een lagere instelling geeft de generatie meer ruimte om af te wijken. De prompt bepaalt het doel; de begeleidingsinstelling beïnvloedt hoe streng het proces dat volgt.
Het direct ontdoen van ruis voor elke individuele pixel zou te veel rekenkracht en geheugen vergen. Latent diffusion comprimeert eerst een afbeelding tot een compactere weergave, voert daar de denoising op uit en decoreert (decodeert) het resultaat vervolgens weer naar pixels. Dit maakt het praktischer om afbeeldingen in een hogere resolutie te genereren zonder dat elke pixel tijdens het hele proces hoeft te worden bijgewerkt.
Je kunt een preview lezen als een werk in uitvoering: let eerst op de compositie en controleer pas daarna of de details arriveren naarmate de afbeelding scherper wordt. AI-ondersteuning voor academisch onderzoek is een ander voorbeeld van AI die een stapsgewijs werkproces ondersteunt.
Trainingsparen zijn lessen, geen verzameling voltooide foto's die liggen te wachten tot de app ze kopieert. Elk paar verbindt een visueel voorbeeld met beschrijvende woorden, waardoor een model leert om verbanden te leggen tussen taal en visuele patronen. Die associaties kunnen bestaan uit een onderwerp, de bijbehorende kenmerken, de indeling van een scène en een visuele stijl.
De schaal van de trainingsdata is belangrijk, maar de kwaliteit van de bijschriften is dat eveneens. LAION-5B, een openbaar beschikbare dataset die wordt gebruikt in onderzoek naar beeld en tekst, bevat grofweg5 miljard afbeeldingen, waarvan ongeveer2 miljardvoorzien zijn van bijbehorende Engelse bijschriften, aldus hetonderzoek naar de LAION-5B beeld-tekstdataset. Het model leert patronen uit deze voorbeelden; het gebruikt ze niet als een opzoektabel van voltooide afbeeldingen.
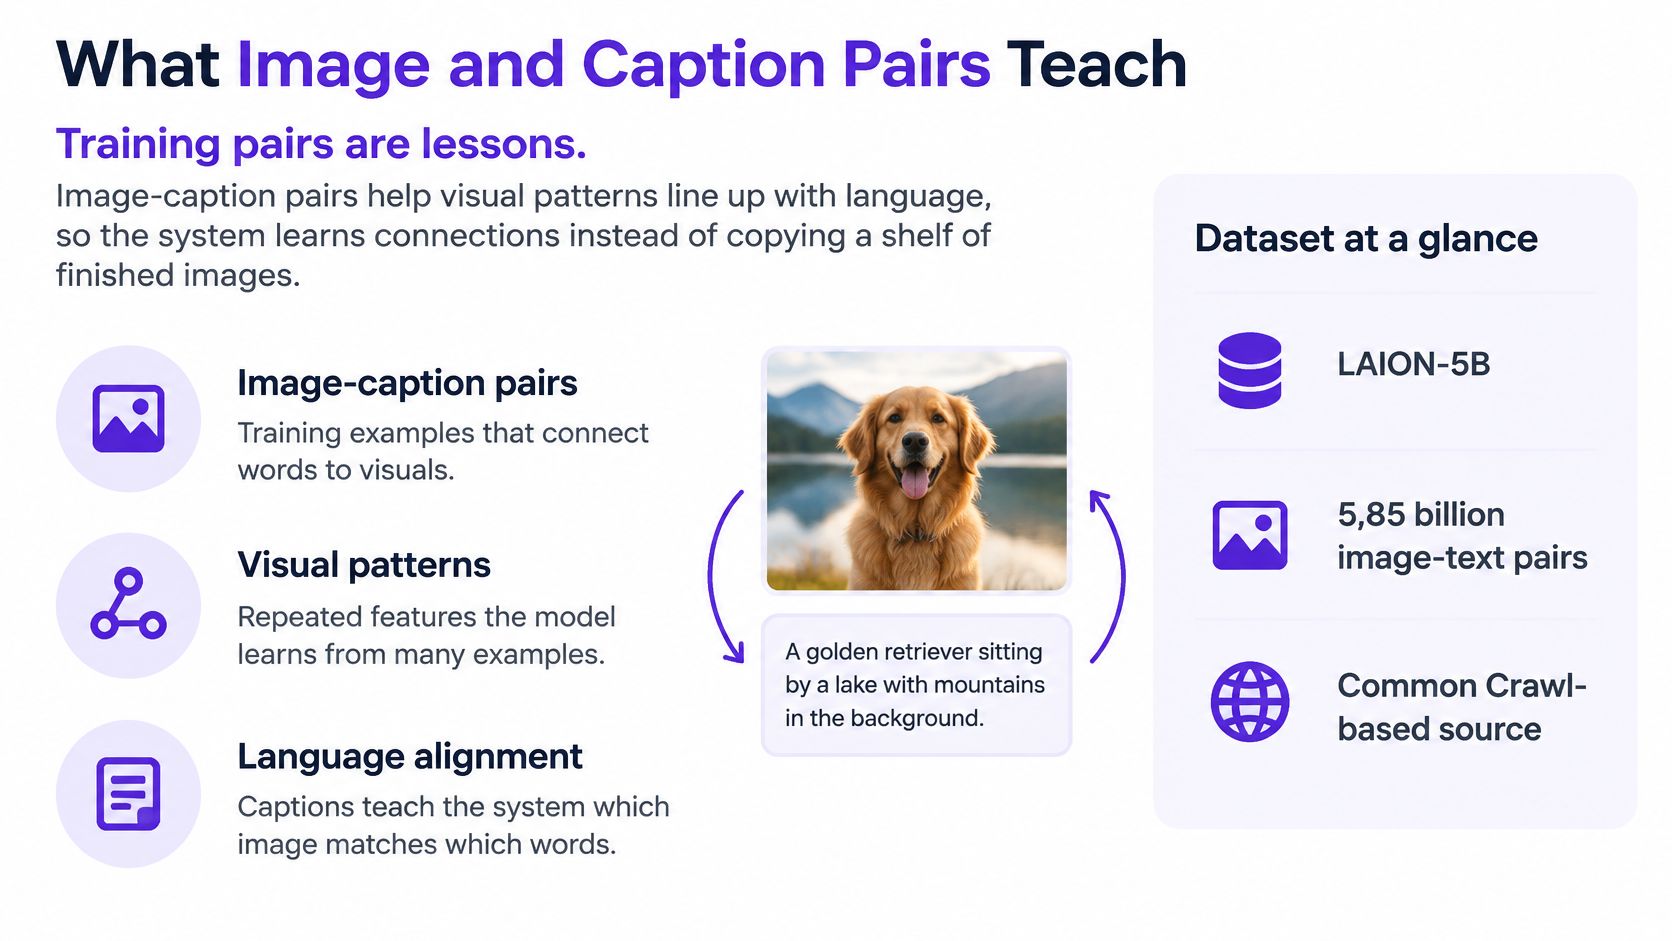
Bijschriften beïnvloeden welke associaties het model met een afbeelding kan leggen. Dichte, kwalitatief hoogwaardige bijschriften kunnen verbeteren hoe goed gegenereerde foto's de tekst volgen. Het nadeel hiervan is dat het ook de esthetische kwaliteit en de diversiteit van de output kan verminderen. Een systeem dat leert van specifiekere beschrijvingen is mogelijk beter in staat om te voldoen aan vermelde details, zonder daarbij een groter bereik aan verschillende stijlen te produceren.
Dit helpt te verklaren waarom prompt-opvolging niet enkel een kwestie is van het vergroten van een visueel model. Het model is eveneens afhankelijk van de vraag of de trainingsbijschriften elke afbeelding voldoende helder hebben beschreven. Als een ongebruikelijk kostuum, een niche-gamefiguur of een kenmerkend merk in slechts een paar goed beschreven voorbeelden voorkomt, heeft het systeem zwakkere patronen om op terug te grijpen.
Voor een obscuur onderwerp kun je het idee opbreken in visuele kenmerken die het model kan uitdrukken: de vorm van een kostuum, de materialen en kleuren, de lichaamsdelen van het wezen, of de positie van een logo-achtig merk. Een prompt die deze zichtbare onderdelen beschrijft, geeft het systeem meer handvatten dan enkel een naam van binnenuit.
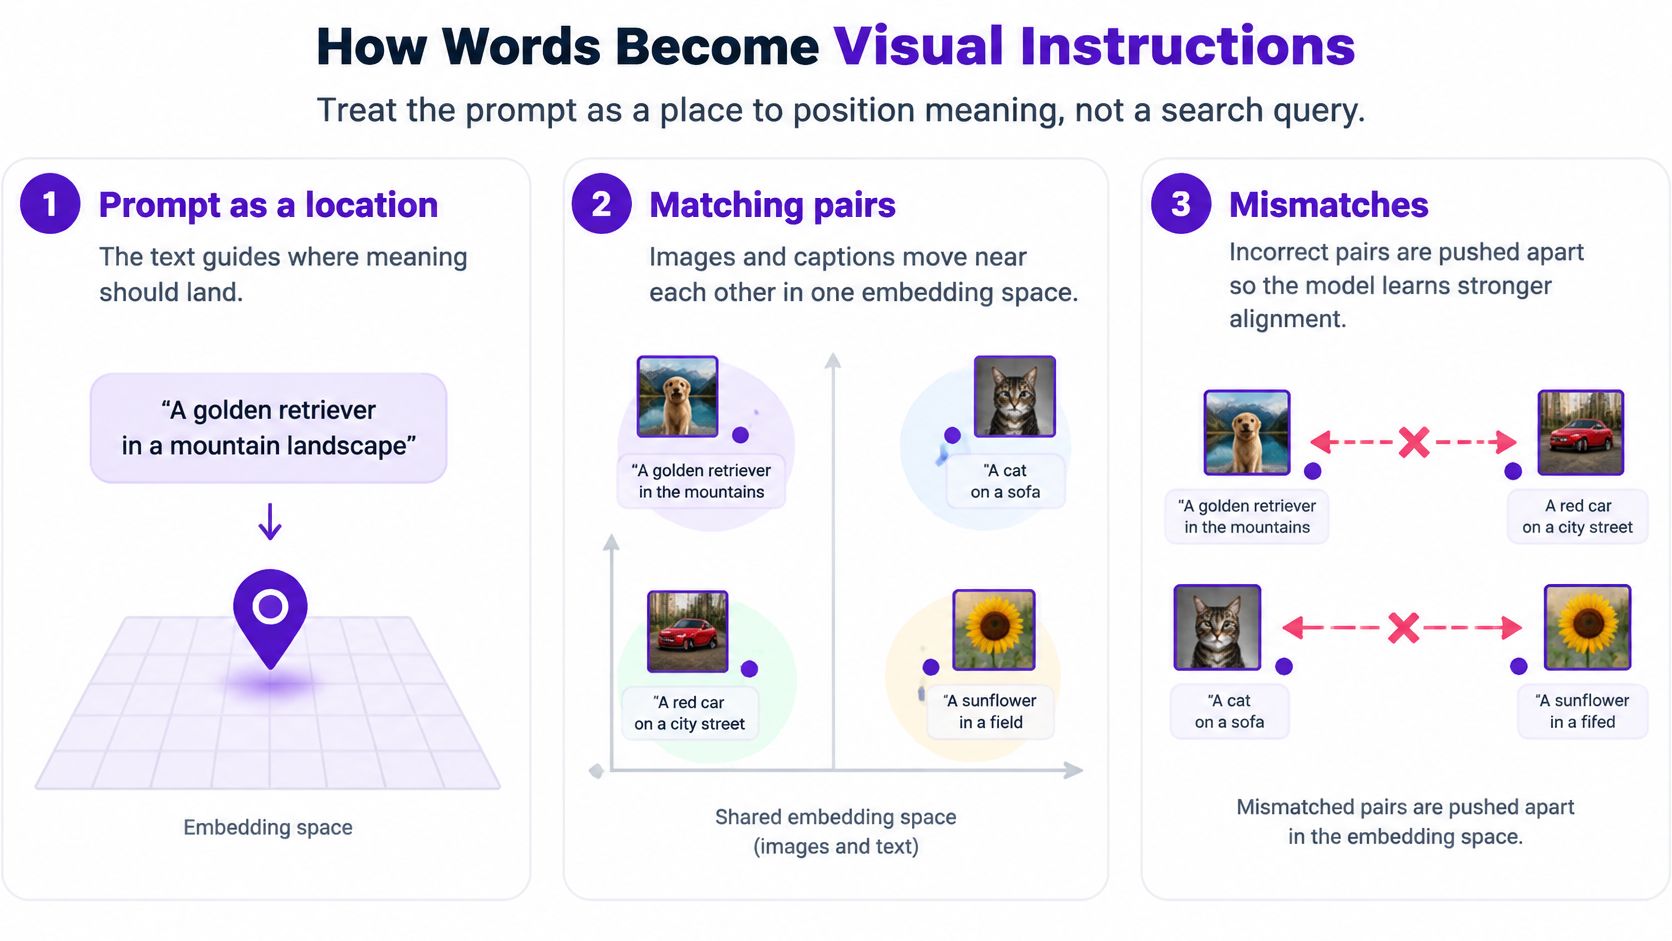
Denk aan een gedeelde ruimte waar afbeeldingen en hun bijschriften elk een vaste plek hebben. Een goed bijschrift bevindt zich dicht bij de foto die het beschrijft; een onjuist bijschrift bevindt zich verder weg. In een benadering in CLIP-stijl worden bij elkaar passende afbeeldingen en bijschriften dicht bij elkaar gebracht in een gedeelde inbeddingsruimte (embedding space), terwijl niet-matchende paren uit elkaar worden geduwd. Hetverslag over contrastief leren in tekst-naar-beeld-systemenlegt uit hoe deze overeenkomst in beide richtingen wordt gemeten: van beeld naar tekst en van tekst naar beeld.
Tijdens het genereren wordt de prompt omgezet in een numerieke weergave die concepten met zich meedraagt zoals het onderwerp, kenmerken en stijl. Het diffusiemodel gebruikt die weergave om de vorming van de afbeelding te begeleiden, in plaats van de prompt te behandelen als een ongestructureerde reeks tekens. Eenvoudig gezegd probeert het model de benoemde betekenis te behouden terwijl het deze omzet in een visuele structuur.
Beschouw twee prompts voor een koffieafbeelding:
“Leuke koffiefoto.”
“Rode emaille mok op een vensterbank, ochtendzijlicht, geen tekst.”
De eerste geeft het model een brede bestemming, maar laat veel keuzes open. De tweede benoemt het object, de kleur en het materiaal, de relatie tot de vensterbank, de belichting en een randvoorwaarde. Die details geven de prompt-weergave duidelijkere ankers.
Een tekst-naar-beeld-prompt is geen zoekopdracht die de dichtstbijzijnde bestaande foto ophaalt. Het is een reeks instructies die het proces van het maken van de afbeelding stuurt. Benoem wat er te zien moet zijn, hoe de elementen zich tot elkaar verhouden en welke visuele keuzes het belangrijkst zijn. Eengids voor AI-prompt-optimalisatiekan je helpen om die gewoonte aan te leren voor het maken van afbeeldingen.
Tekstbegeleiding beïnvloedt ook hoe krachtig de prompt trekt bij elke denoising-stap. Een nauwkeurige prompt geeft het model duidelijkere concepten om te behouden; de instelling voor begeleiding bepaalt hoe sterk die concepten de opkomende afbeelding beïnvloeden. Geen van beide garandeert dat elk detail klopt.
Probeer deze schrijfgewoonte: benoem het onderwerp, één relatie, een standpunt of lichtbron, en iets dat je wilt weglaten. Bijvoorbeeld: „rode mok op een vensterbank, ooghoogte, zacht ochtendzijlicht, geen letters” is bruikbaarder dan een reeks algemene complimenten. Die helderheid neemt onzekerheid niet weg, maar geeft het proces wel een specifieker doel.
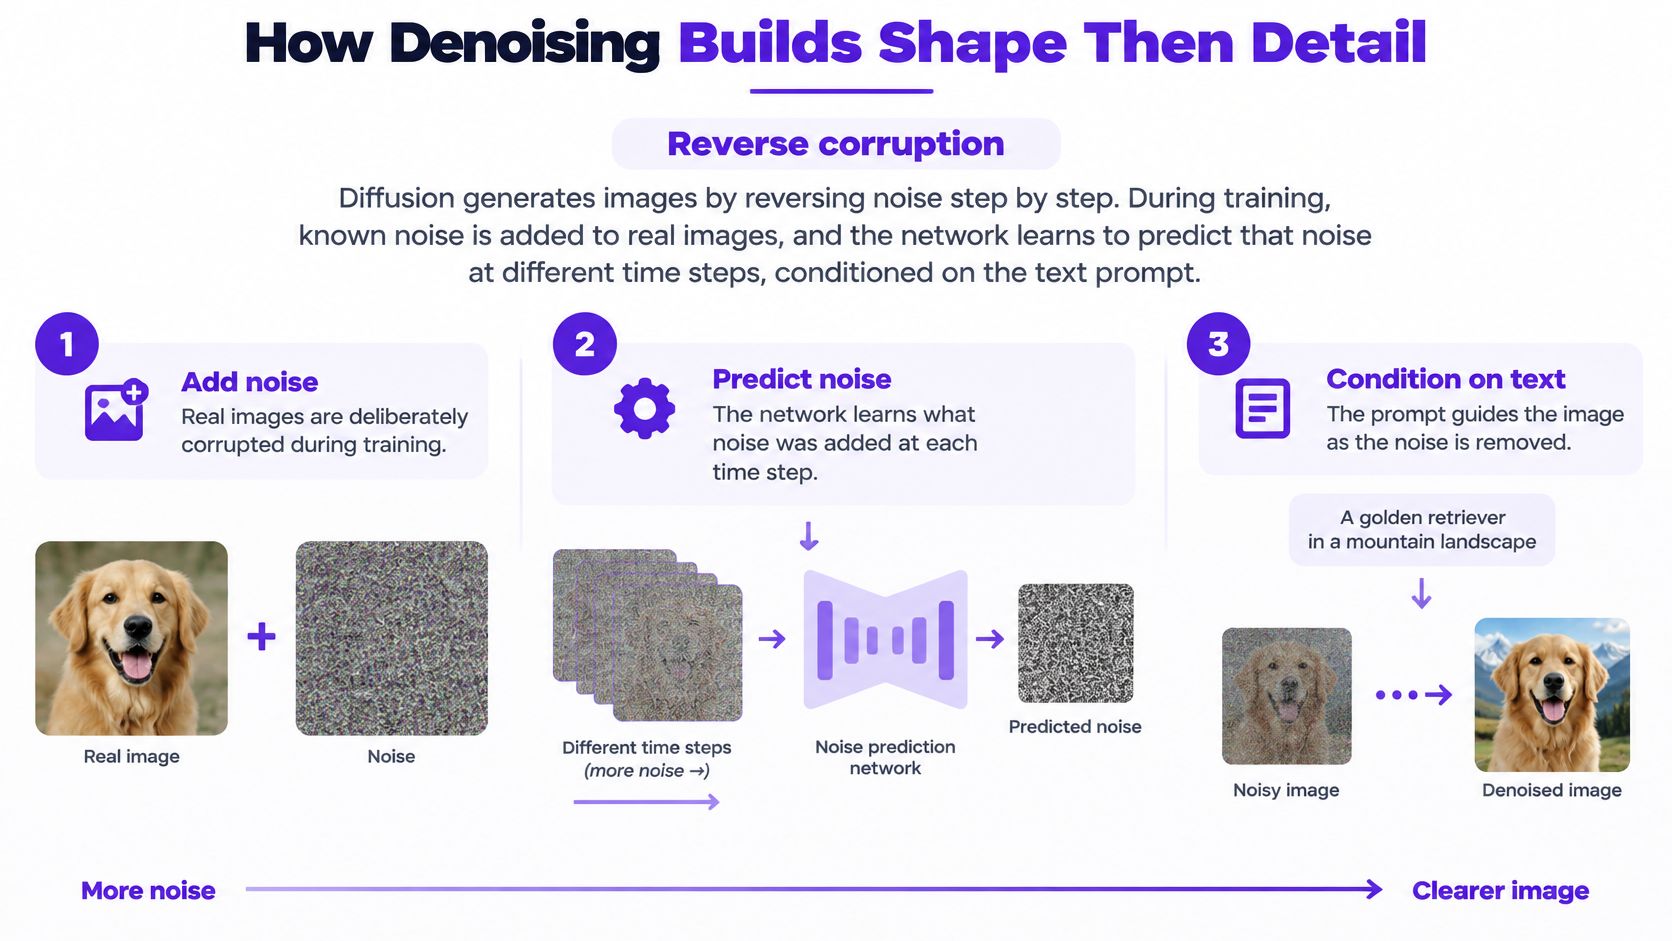
Tijdens de training ziet het model afbeeldingen die bewust zijn gewijzigd met bekende ruis. Het leert om de ruis te voorspellen op verschillende tijdstippen, waarbij de tekstweergave als voorwaarde wordt gebruikt. Het genereren draait die corruptie om: het model start vanuit ruis en past herhaaldelijk de geleerde denoising-bewerking toe, op weg naar een afbeelding die bij de prompt past.
Er zit geen originele foto verborgen onder het willekeurige startpunt. Bij inferentie herstelt het model geen specifieke foto die het eerder heeft gezien. Elke stap doet een voorspelling over hoe de opkomende afbeelding eruit moet zien, gegeven de huidige ruizige staat en de tekstbegeleiding.
Een op pixels gebaseerd diffusiesysteem werkt direct op de pixels van de afbeelding, wat veel rekenkracht kan vergen. Latent diffusion comprimeert de afbeelding eerst, voert de denoising-stappen uit op die kleinere weergave en gebruikt vervolgens een decoder om het resultaat om te zetten in pixels. De overstap naar deze methode in 2022 verminderde de computer- en geheugenvereisten en ondersteunde tegelijkertijd de synthese in hoge resolutie.
Die efficiëntie brengt wel een compromis met zich mee. Het model verfijnt niet elke pixel direct tijdens zijn hoofdgeneratielus, en het compressie- en decoderingsproces kan de uiteindelijke kwaliteit beperken. Latent diffusion maakt het genereren praktischer, maar zorgt er niet voor dat elke output vlekkeloos is.
Vroege denoising-stappen bepalen de globale compositie en de geometrie van het object. Latere stappen vullen voornamelijk details in, zoals een textieloppervlak, een reflectie of een rand. Eeneenvoudige introductie tot Stable Diffusionbiedt een andere manier om een veelgebruikte diffusie-aanpak te verkennen.
Deze volgorde is handig wanneer je een preview beoordeelt. Als de houding van een hardloper of de positie van een personage op een boekomslag er verkeerd uitziet terwijl de afbeelding nog wazig is, is meer textuur niet de oplossing. Het model kan een onjuiste vroege gok verfijnen in plaats van deze op magische wijze te corrigeren. Zie de zichtbare voortgang alseerst de indeling, dan de oppervlakken, en als laatste de pixels.
Een prompt wordt niet in één handeling direct omgezet in pixels. Het model begint met willekeurige ruis en voert een reeks voorspellingen uit, waardoor het opnieuw invoeren van dezelfde woorden tot een ander resultaat kan leiden. Zelfs versnelde diffusiebenaderingen vereisen doorgaans grofweg20 tot 50 opeenvolgende denoising-stappen per afbeelding, volgens eenanalyse van snelheid, inconsistentie en praktische problemen bij tekst-naar-beeldgeneratie.
Dit zelfde iteratieve proces helpt te verklaren waarom een prompt een instructie kan missen. Een voorspelling over tekstuitlijning, anatomie of het aantal objecten kan latere stappen beïnvloeden. Een langere prompt kan de zaken bovendien erger maken als deze concurrerende onderwerpen of stijlen combineert, waardoor het model achterblijft met een verwarde set aan richtlijnen.
| Wat je opvalt | Waarom het mechanisme dit doet | Wat te proberen |
|---|---|---|
| Zelfde prompt, andere afbeelding | Elke run begint met nieuwe willekeurige ruis en benadert | Naam compositie en standpunt, regenereer daarna |
| Vreemde handen, ledematen of tellingen | Fouten kunnen zich opstapelen gedurende ongeveer 20 tot 50 stappen | Gebruik minder mensen, vereenvoudig de pose en voer dan een bewerking uit |
| Gebroken of extra belettering | Tekst is moeilijk uitgelijnd te houden in pixels | Gebruik zeer korte woorden of voeg type toe buiten het model |
| Meer detail maakte het erger | Concurrerende concepten trekken de embedding uit elkaar | Kies één onderwerp, duidelijke relaties en één stijl |
| Generatie voelt traag aan | Stappen worden na elkaar uitgevoerd, niet als één pixel-schrijfoperatie | Reken op meerdere pogingen in plaats van één perfecte pass |
Een gecomprimeerde latente representatie kan de berekening verminderen, maar het creëert ook een kwaliteitsplafond dat wordt opgelegd door de autoencoder. Als de compressie iets verliest, kan latere denoisering dat niet altijd terugbrengen. Daarom is een aansprekende afbeelding het bewijs van één succesvol resultaat, en geen bewijs dat het model elke prompt betrouwbaar zal oplossen.
Distillatie en consistentiemodellering zijn ontwikkelingen om in de gaten te houden. Ze zijn erop gericht om de generatie terug te brengen tot één of twee evaluaties in plaats van vele diffusiestappen, wat het creëren van afbeeldingen responsiever zou kunnen maken voor mobiele en high-volume creatieve workflows. Die richting betekent niet dat elke huidige afbeeldingsapp al in één of twee stappen genereert.
Voor creators is de praktische reactie om de compositie, onderwerprelaties, camera of standpunt, en uitvoerbeperkingen te specificeren. Behandel een gebrekkig resultaat vervolgens als een mislukte inferentie, niet als een oordeel over het idee: regenereer wanneer de compositie niet klopt, of bewerk het deel dat mislukte. Bij het vergelijken van tools kun je je richten op welke tool jouw terugkerende taak en correctieworkflow aankan; ditoverzicht van tekst-naar-afbeelding modellenbiedt een ander startpunt.
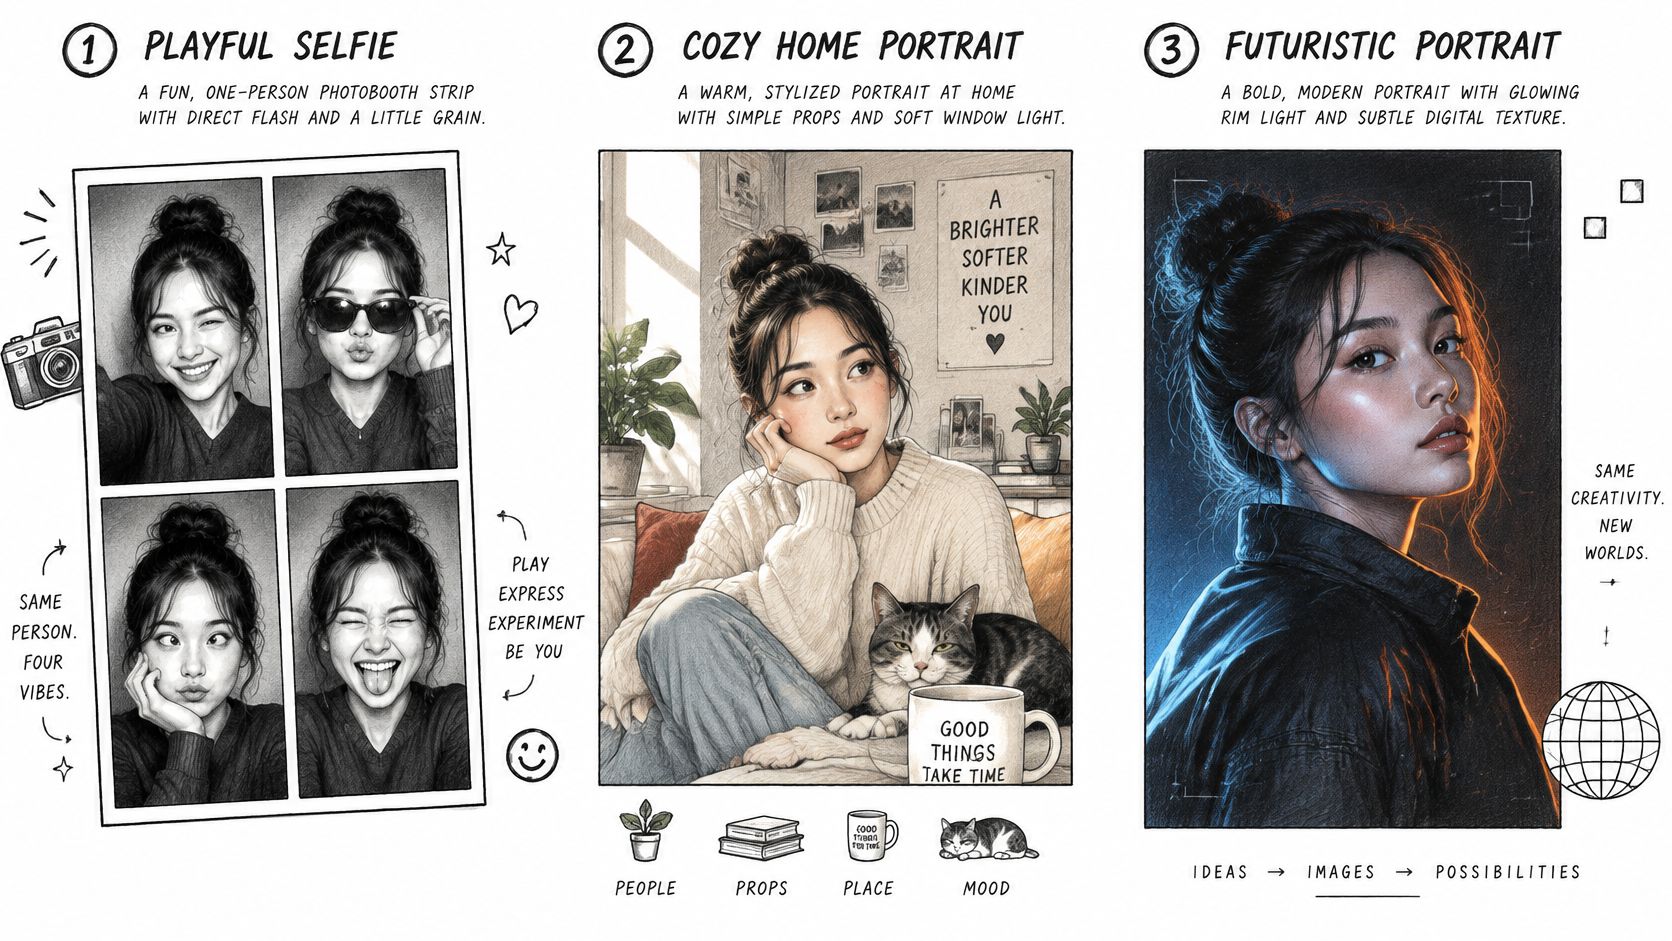
Dezelfde gewoonte voor het schrijven van prompts kan van dienst zijn bij een selfie-transformatie, een atletisch portret of een personageconcept. Geef het model in elk geval eerst de structurele instructies en gebruik vervolgens details die de beoogde look ondersteunen. Hier zijn drie prompts die je kunt aanpassen.
Photobooth-stijl selfie:"Eén persoon met een speelse uitdrukking, directe cameraflits, layout met vier fotostroken, lichte filmkorrel." De woorden "één persoon" en "layout met vier fotostroken" geven het model het onderwerp en de vroege compositie om vast te stellen. "Directe cameraflits" definieert de belichting; "lichte filmkorrel" is een oppervlaktedetail. Laat extra stijlstickers achterwege die concurreren met de fotostrook-look.
Bekijk het onderstaande voorbeeld om te zien wat voor soort portret-transformaties tot nieuwe ideeën kunnen leiden.
Atletisch portret:"Hardloper halverwege de stap op een baan, doelgerichte houding, eenvoudige donkere sportkleding, zijlicht." "Hardloper halverwege de stap" en "doelgerichte houding" helpen bij het bepalen van de lichaamshouding en de algehele vorm. De baan en het zijlicht plaatsen het onderwerp in een duidelijke omgeving. Stapel geen verschillende kledingstijlen of stemmingen op een prompt die al een leesbare pose nodig heeft.
Personage voor een omslag of merchandise:"Eén fantasiepersonage, bosgroene jas en koperen sjaal, effen crèmekleurige achtergrond, geen tekst." Het onderwerp en de kledingdetails geven de generator een beknopt visueel doel; de effen achtergrond houdt de aandacht op het personage. Het weglaten van de titel is een bewuste keuze. Voeg achteraf nauwkeurige belettering toe in plaats af te gaan op het afbeeldingsmodel om een omslagtitel te spellen.
Voor een alledaagse workflow kun je met starryai beginnen vanaf een tekstprompt of selfie, afbeeldingsvariaties genereren en Bewerken gebruiken wanneer een hand, achtergrond of uitsnede mist. Houd het onderwerp, de indeling en de achtergrond helder in de eerste prompt. Pas vervolgens alleen het mislukte detail aan in plaats van alles te herschrijven.
Een provenance-signaal kan laten zien dat een afbeelding is gegenereerd of verwerkt door AI. Het bewijst niet dat je toestemming hebt om elk element te gebruiken, dat een marktplaats de afbeelding toestaat, of dat de context ervan waarheidsgetrouw is. Content Credentials en onzichtbare watermerken kunnen de geschiedenis van een afbeelding vastleggen of aangeven, hoewel bijsnijden, compressie of ingrijpende bewerkingen een watermerk moeilijk te detecteren kunnen maken. Geen zichtbaar signaal bewijst niet dat een afbeelding een foto is.
Sla voor boekomslagen, merchandise, avatars en gebrande berichten op hoe de afbeelding is gemaakt en controleer deze voordat je publiceert:
Een label kan het proces van een afbeelding verklaren, maar je moet nog steeds beoordelen wat het afbeeldt en of je het recht hebt om de ingrediënten ervan te gebruiken. Sla in starryai je prompt op naast de gegenereerde afbeelding en regenereer of bewerk vervolgens foutieve anatomie of tekst. Bekijk het definitieve bestand voordat je het plaatst of verkoopt.
starryai biedt een gratis AI-afbeeldingsgenerator en creatieve suite om tekstprompts, selfies en emoji's om te zetten in visuals. Probeer een duidelijke prompt, vergelijk de resultaten enbezoek starryaiom te experimenteren met de generatie-en-bewerking workflow.


