

Geschreven doorMo Kahnop
1 juli 2026


Multimodale AI is een type kunstmatige intelligentie dat informatie uit meerdere bronnen tegelijk kan begrijpen en verwerken, zoals tekst, afbeeldingen en geluid, vergelijkbaar met hoe mensen dat doen. Het is al een echte marktcategorie, waarbij de wereldwijde markt voor multimodale AI in een schatting van de industrie wordt gewaardeerd opUSD 1,6 miljard in 2024en naar verwachting groeit totongeveer USD 27 miljard tegen 2034.
Je voelt waarschijnlijk al de kloof die dit oplost. Je typt een prompt, krijgt een afbeelding die in de buurt komt, en wenst vervolgens dat je ook een referentefoto kunt uploaden, de gewenste sfeer kunt beschrijven, misschien spraaknotities kunt toevoegen, en dat de tool dit allemaal samen begrijpt.
Dat is het grote idee achter multimodale AI. Het behandelt creativiteit niet langer als alleen tekst. Het begint meer te werken als een samenwerkingspartner die je woorden kan lezen, naar je referenties kan kijken en de stukjes kan verbinden tot één antwoord. Voor kunstenaars, contentmakers, indie-auteurs, ondernemers en socialemiddelmanagers verandert dat wat AI kan doen in een dagelijkse workflow.
Veel oudere AI-tools voelden aan als het werken met iemand die alleen briefjes kon lezen die onder een deur door werden geschoven. Als je een sterke prompt typte, konden ze reageren. Maar als je een selfie wilde laten zien, naar een kleurenpalet wilde wijzen en wilde zeggen "laat dit aanvoelen als een dromerige fantasieposter", kon het systeem die signalen vaak niet goed combineren.
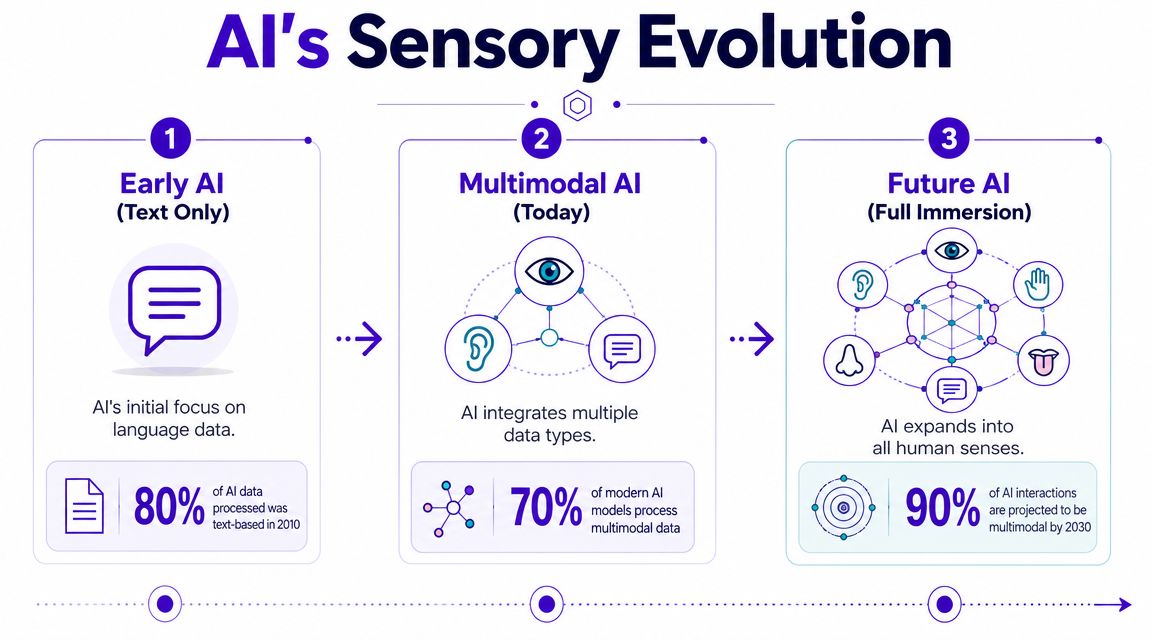
Dat is waaromwat multimodale AI isbelangrijk is voor makers. Het markeert een verschuiving van systemen met één invoer naar tools die kunnen werken mettekst, afbeeldingen, audio en videoin plaats van elk formaat als een afzonderlijke wereld te behandelen.
Makers werken zelden in één formaat tegelijk. Een TikTok-concept kan beginnen als een bijschriftidee, veranderen in een referentiebord, een voice-over worden en eindigen als een korte video. Een boekomslag kan beginnen met karakterschetsen, dan sfeerbeelden en vervolgens typografie-experimenten.
Multimodale AI sluit beter aan bij die werkelijkheid dan oudere tools, omdat het een rijkere context aankan.
Als jevideoproductie wilt stroomlijnen met TTS, begint multimodaal denken effectief te worden. Je hebt niet langer te maken met geïsoleerde taken. Je combineert mediatypen tot één creatief systeem.
Praktische regel:Hoe meer je idee afhangt van relaties tussen woorden, beelden en geluid, hoe waarschijnlijker het is dat multimodale AI nuttig aanvoelt in plaats van als een gimmick.
De commerciële kant weerspiegelt die verschuiving ook. Eén branche-schatting waardeert de wereldwijde markt voor multimodale AI opUSD 1,6 miljard in 2024en projecteert dat deze zal bereikenongeveer USD 27 miljard tegen 2034, wat een32,7% CAGRimpliceert volgensmarktanalyse van multimodale AI door Global Market Insights.
Als je al werkt met AI-visuals, helpt het om eerst de kant van de afbeelding te begrijpen, vooral in handleidingen zoalswat een AI-afbeelding is. Multimodale AI bouwt voort op dat fundament en voegt vervolgens meer zintuigen toe aan het gesprek.
De eenvoudigste manier om multimodale AI te begrijpen is door deze te vergelijken met je eigen waarneming. Als je een hond ontmoet, verwerk je niet slechts één signaal. Je ziet zijn vorm, hoort het geblaf, leest misschien de naam op een penning, en je brein smelt die signalen samen tot één begrip.
EenunimodaalAI-systeem werkt meer als een specialist met één zintuig. Het kan misschien alleen tekst lezen of alleen afbeeldingen classificeren. Eenmultimodaalsysteem kan verschillende soorten invoer met elkaar verbinden en erover redeneren.
Lezers struikelen hier vaak over. Multimodaal betekent niet alleen dat "de app uploads accepteert." Veel tools laten je een afbeelding bijvoegen en tekst plakken, maar ze begrijpen niet noodzakelijkerwijs de relatie daartussen.
Een multimodaal systeem doet iets diepers. Het kan naar een foto kijken, geschreven of gesproken instructies over die foto interpreteren en een respons genereren die beide invoeren samen weerspiegelt.
Die verschuiving werd een bepalende mijlpaal in het veld. Belangrijke onderzoeks- en branchebeschrijvingen kaderen multimodale AI rond modellen die gezamenlijk verwerkentekst, afbeeldingen, audio en video, wat AI bracht van smalle specialisatie naar systemen die meer lijken op menselijke waarneming, zoals uitgelegd inTileDB's gids voor multimodale AI.
| Type | Wat het verwerkt | Waar het beperkt aanvoelt |
|---|---|---|
| Unimodale AI | Eén gegeventype tegelijk | Het kan context missen die in een andere indeling staat |
| Multimodale AI | Meerdere gegeventypen tegelijk | Het is complexer, maar kan rijkere antwoorden opleveren |
Voor een maker is dat verschil praktisch.
Multimodale AI begint pas echt nuttig te aan te voelen wanneer de relatie tussen invoergegevens belangrijker is dan elke afzonderlijke invoer op zichzelf.
Creatieve sturing is meestal gelaagd. Je wilt misschien “dit gezicht,” “die schilderachtige sfeer,” “deze toon voor een bijschrift,” en “die energie van een soundtrack.” Menselijke samenwerkingspartners begrijpen dat soort combinaties op natuurlijke wijze. Multimodale AI probeert iets vergelijkbaars te doen binnen software.
Daarom duikt het op in bredere markten zoals de gezondheidszorg, autonome voertuigen, contentmoderatie, klantenservice en robotica. Voor makers is de conclusie eenvoudiger. AI wordt steeds beter in context, en context is waar stijl zich bevindt.
Onder de motorkap is multimodale AI minder magie en meer choreografie. Zie het als een klein team vertalers dat achter de schermen werkt.
De ene vertaler begrijpt tekst. Een andere begrijpt beelden. Een volgende verwerkt audio. Elke specialist neemt een ander soort ruwe invoer en zet deze om in een vorm die het systeem kan vergelijken en combineren.
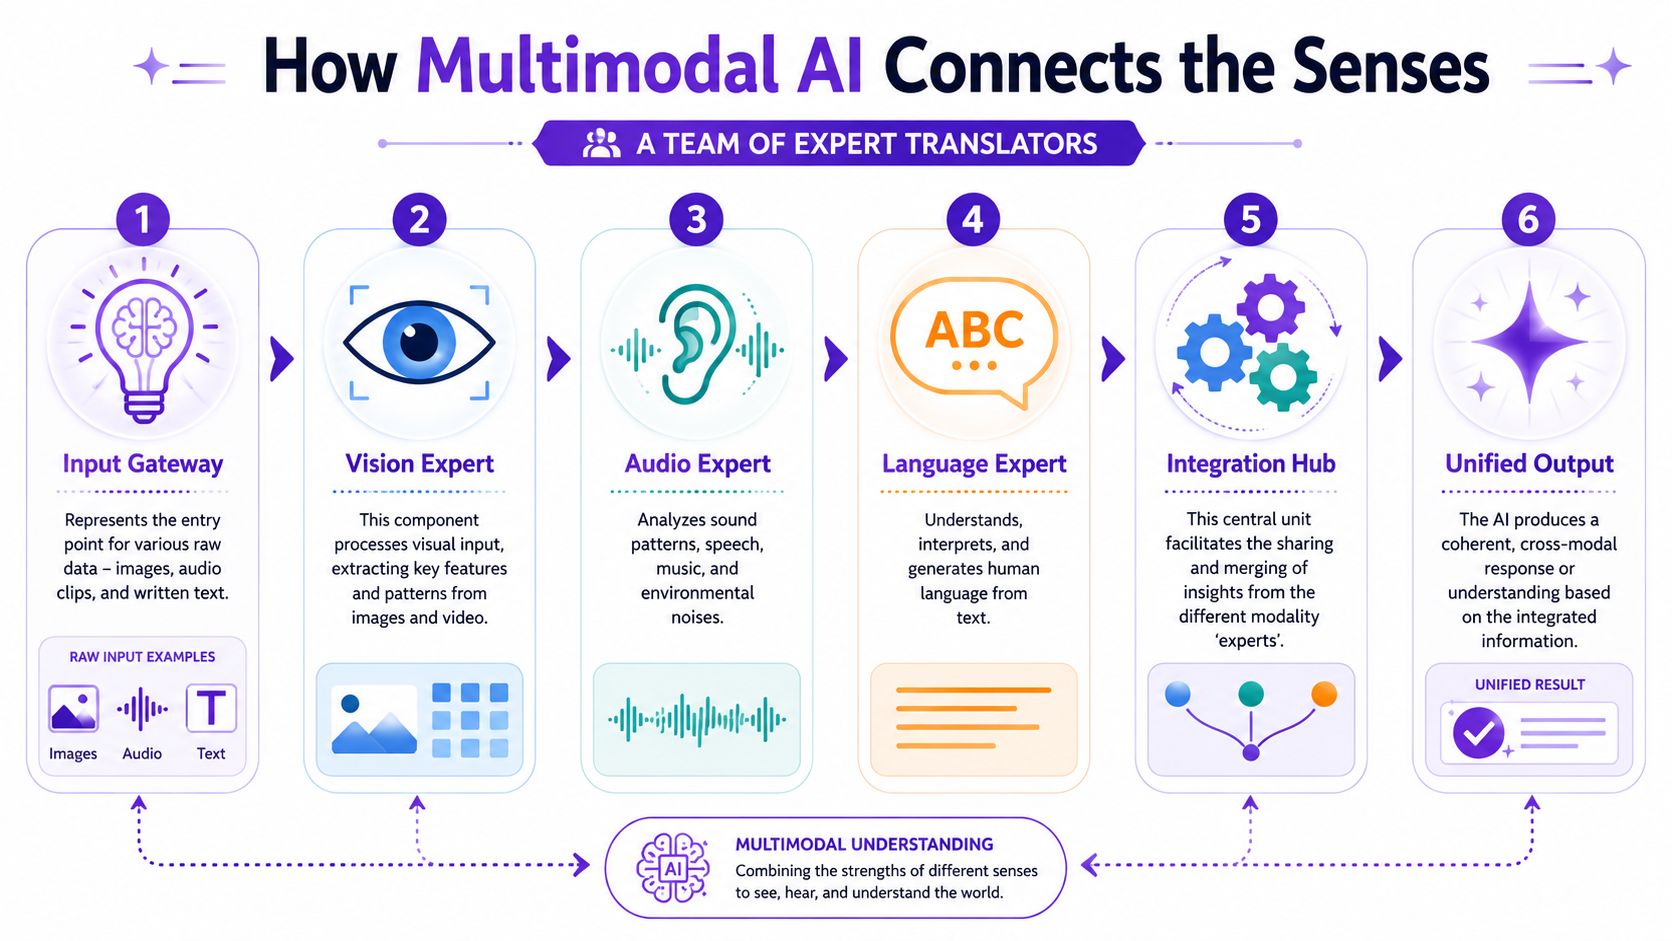
Een veelvoorkomende multimodale architectuur omvat eeninvoermodule, eenfusiemoduleen eenuitvoermodule. In meer technische termen zijn deze systemen doorgaans opgebouwd uitmodaliteitsspecifieke encodersplus eenfusielaagdie tekst, afbeeldingen, audio of video vertaalt naar een gedeelde 'embedding'-ruimte, zoals wordt beschreven in de uitleg over multimodale AI van McKinsey.
Hier is de versie in begrijpelijke taal:
Invoer
Verschillende encoders verwerken verschillende media. Tekst wordt opgeknipt in tokens. Afbeeldingen worden verkleind en gecodeerd. Audio wordt vaak omgezet in kenmerken die het model kan interpreteren.
Fusie
Dit is de essentiële tussenstap. Het systeem plaatst die verschillende invoergegevens in een gedeelde ruimte zodat het de betekenis over verschillende formaten heen kan vergelijken.
Uitvoer
Een stroomafwaarts model produceert het antwoord. Dat antwoord kan tekst, een afbeelding, instructies, een classificatie of een ander gegenereerd resultaat zijn.
Zonder fusie zou multimodale AI slechts een verzameling afzonderlijke specialisten zijn. De fusielaag zorgt ervoor dat het systeem jouw prompt kan koppelen aan je afbeelding, in plaats van ze als losstaande bestanden te behandelen.
Dat is wat cross-modale redenering mogelijk maakt. Een model kan een afbeelding en een tekstprompt samen gebruiken om een vraag te beantwoorden of een antwoord te genereren dat beide weerspiegelt.
Zie de fusielaag als de vergadertafel waar elke specialist zijn notities in dezelfde taal meebrengt.
Dit idee van een gedeelde ruimte verklaart ook waarom de technologie flexibele uitvoer ondersteunt. Zodra verschillende modaliteiten zijn ingebed in dezelfde theorie met een hoge dimensionaliteit, kan het modelany-to-any-generatieondersteunen. Dit betekent dat het één of meer modaliteiten kan opnemen en een andere modaliteit als uitvoer kan produceren, aldus Milvus over multimodale computervereisten.
Als je een portret uploadt en toevoegt “maak hier een neon cyberpunk-poster van,” stapelt het systeem niet zomaar één instructie bovenop één bestand. Het probeert de visuele kenmerken van het portret af te stemmen op de betekenis van de prompt voordat het resultaat wordt gegenereerd.
Daarom voelen sommige resultaten griezelig accuraat aan, terwijl andere juist afdwalen. Het model moet meerdere signalen correct op elkaar afstemmen.
Als je een vastere basis wilt in het ecosysteem rondom deze systemen, isgeneratieve AI-modellen uitgelegdeen nuttige aanvullende leestip. Generatieve modellen creëren de uitvoer. Multimodale ontwerpen helpen ze om een bredere mix van invoer te begrijpen voordat ze dat doen.
De snelste manier om multimodale AI te begrijpen, is door het te gebruiken voor iets waar je al om geeft. Voor makers betekent dat meestal identiteit, stijl, snelheid of storytelling.
Dit is een van de duidelijkste toepassingen voor makers. Je begint met een afbeelding van jezelf en voegt vervolgens tekst toe die de transformatie stuurt.
Een prompt als “verander dit portret in een elfachtige boswachter bij maanlicht met een zilveren uitrusting en schilderachtige belichting” geeft het model twee dingen tegelijk: identiteitskenmerken van de foto en stijlelementen uit de taal. Het resultaat kan dienen als avatar, vernieuwde profielfoto, posterconcept of fan-art.
Voor dit soort workflows zijn tools zoalsstarryai text to imagerelevant, omdat ze op prompts gebaseerde afbeeldingscreatie ondersteunen en goed passen bij makers die visuele uitvoer willen zonder technische installatie.
Soms is het doel niet “zorg dat ik er anders uitzie.” Het is “zorg dat dit idee meer lijkt op die esthetiek.”
Dat kan betekenen dat je een sfeerbeeld uploadt en een prompt schrijft waarin de toon, het palet of het genre wordt gespecificeerd. Een maker die prints verkoopt op Etsy, kan dit gebruiken om richtingen uit te proberen voor cottagecore, retro sci-fi of dark academia-collecties. Een onafhankelijke auteur kan hetzelfde patroon gebruiken voor personageconcepten of het verkennen van boekomslagen.
Als je in de uitgeverij werkt, is deze gids over hetselecteren van AI-generatoren voor zelfstandige uitgevershandig omdat het de keuze van tools koppelt aan echte workflows voor omslagen en concepten, in plaats van aan abstracte AI-hype.
Multimodale AI genereert niet alleen. Het kan ook interpreteren.
Je kunt een afbeelding invoeren en vragen om:
Dat is handig wanneer je vastzit bij het bedenken van een naam, het plaatsen of het verfijnen van een idee dat je wel kunt zien, maar nog niet hebt kunnen verwoorden.
Een korte demo maakt dit concreter:
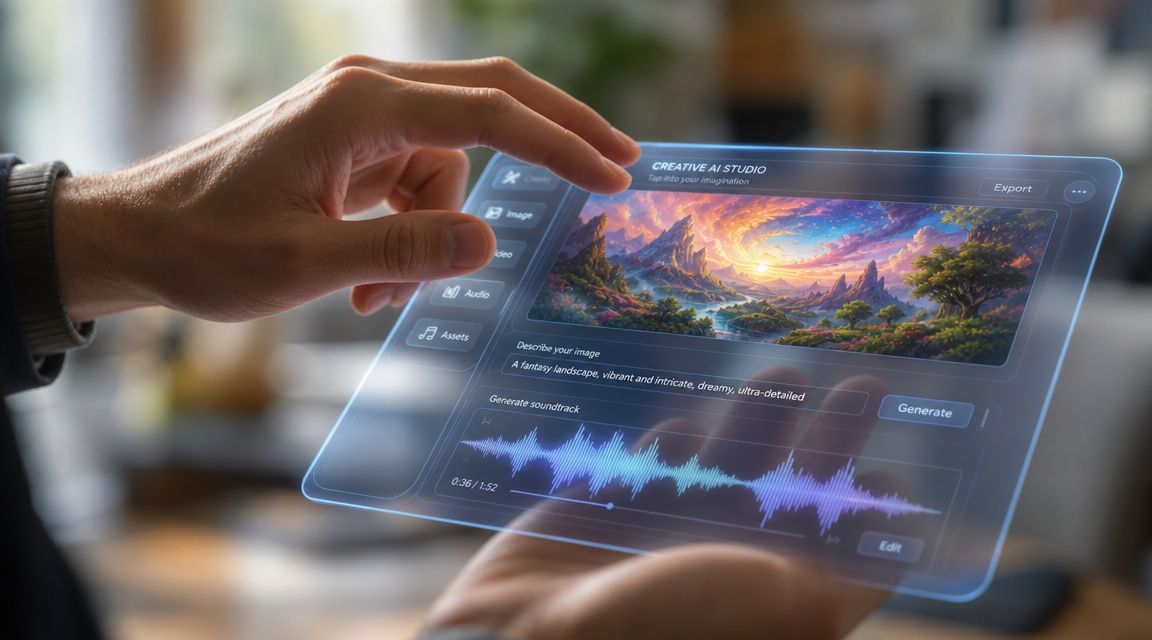
Voormakers van korte video's is de interessante sprong het combineren van scenario, visuals en stem. Een concept kan beginnen als een geschreven haak, gegenereerde beelden worden en vervolgens voice-over of sounddesign krijgen.
Dat betekent niet dat elke maker een volledige productiestack nodig heeft. Het betekent dat de muur tussen "schrijven", "ontwerpen" en "bewerken" dunner wordt. Hetzelfde kernidee kan nu soepeler over formats bewegen, wat de reden is waarom multimodale AI heel natuurlijk aanvoelt voor TikTok, reels, trailers en visuele storytelling.
Een goede creatieve prompt hoeft het hele werk niet langer in zijn eentje te dragen. Referentiemedia kunnen nu de last delen.
Multimodale AI opent nieuwe creatieve deuren, maar verhoogt ook de kosten om dingen goed te doen. Deze systemen zijn veeleisender dan modellen met een enkele invoer, omdat ze meerdere informatiestromen moeten verwerken en deze coherent op elkaar moeten afstemmen.
Vergeleken met unimodale systemen vereisen multimodale modellenaanzienlijk meer rekenkracht en geheugenomdat ze meerdere encoders moeten verwerken en grotere architecturen moeten onderhouden. Dat verhoogt de latentie en de vraag naar training en inferentie, zoals opgemerkt in de eerdere gekoppelde Milvus-referentie.
Wanneer een systeem beeld, tekst, audio en video kan combineren, kan het ook worden gebruikt om misleidende inhoud overtuigender te maken. Dat omvat neppe beelden, gemanipuleerde steminhoud of gemengde-media-berichten die ontworpen zijn om authentiek te lijken.
Vooroordelen zijn een ander punt van zorg. Als het trainingsmateriaal scheve representaties bevat, kan het model die patronen over meerdere formaten tegelijk overdragen in plaats van in slechts één kanaal.
Een gegronde manier om multimodale AI te gebruiken is eenvoudig:
Creators hoeven niet bang te zijn voor de technologie. Ze moeten het wel met beoordelingsvermogen gebruiken.
Nee.Generatieve AIbeschrijft systemen die uitvoer creëren zoals afbeeldingen, tekst, audio of video.Multimodale AIbeschrijft systemen die meerdere soorten invoer kunnen begrijpen of ermee kunnen werken. Sommige tools zijn beide. Sommige zijn slechts één.
Een tekst-naar-afbeelding-app kan generatief zijn. Een systeem dat een afbeelding analyseert, je prompt leest en vervolgens een resultaat genereert, is zowel generatief als multimodaal.
Ja. Je hoeft geen modellen te bouwen of de wiskunde van machine learning te begrijpen om te beginnen. De meeste beginners kunnen het concept leren door eenvoudige workflows te proberen, zoals het uploaden van een foto, het toevoegen van een prompt en het vergelijken van uitvoer.
Begin met kleine experimenten:
Het verkleint de kloof tussen het idee in je hoofd en de materialen die je al hebt. In plaats van alles in tekst te dwingen, kun je referenties, taal en soms geluid of beweging combineren.
Dat is met name handig voor makers die visueel denken of die over platforms heen bouwen waar een enkel concept een bericht, een thumbnail, een cover, een voice-over of een korte video moet worden.
De waarschijnlijke richting is meer natuurlijke interactie. Makers zullen in toenemende mate werken met tools die gemengde invoer in één stroom kunnen accepteren en vervolgens uitvoer retourneren die meer contextbewust aanvoelt.
De belangrijke verschuiving is niet alleen betere kwaliteit. Het is betere samenwerking tussen jouw intentie en de media die je levert.
Als je dat soort workflow zelf wilt proberen,starryaiis één optie om prompts, selfies en visuele ideeën om te zetten in door AI gegenereerde afbeeldingen zonder dat je een technische setup nodig hebt.


